Microsoft e fal levam Kling, LTX e MiniMax ao Foundry em public preview

A Microsoft e a fal firmaram parceria para ampliar a geração de vídeo no Microsoft Foundry, ajudando desenvolvedores a levar ideias criativas para aplicações corporativas. Os workloads de vídeo não partem do mesmo input nem buscam o mesmo resultado: uma equipe criativa pode explorar várias interpretações de um briefing escrito, um varejista pode transformar a imagem aprovada de um produto em um conceito curto em movimento, e um desenvolvedor pode combinar geração de imagem e de vídeo em um workflow que vai da descrição ao frame e à cena. Cada cenário exige um equilíbrio diferente entre qualidade visual, movimento, controle criativo, tempo de entrega e custo, o que torna necessária uma solução multimodelo. Os modelos de vídeo Kling, LTX e MiniMax estão em public preview no Microsoft Foundry, como serviço Azure first-party, com opções de text-to-video e image-to-video. Eles são servidos pela fal e vêm das empresas que os desenvolvem. O portfólio inicial inclui Kling v3 Pro, LTX-2.5 Fast, LTX-2.5 Pro, MiniMax H3 Max e MiniMax H3 Max Turbo, com mais modelos planejados ao longo do tempo. A fal oferece APIs para mais de 1.500 modelos de imagem, vídeo, áudio, 3D e mundos generativos, além de inference, treinamento e infraestrutura para rodar workloads de mídia generativa em produção. O Kling v3 Pro combina visuais cinematográficos e movimento fluido com geração de áudio nativa e suporte a elementos customizados, e seus recursos de image-to-video dão controle sobre como uma imagem inicial vira uma cena em movimento. O LTX-2.5 Fast é otimizado para velocidade, voltado a iteração rápida e prévias, enquanto o LTX-2.5 Pro prioriza qualidade, para o resultado final em alta fidelidade. Ambos suportam text-to-video e image-to-video com áudio sincronizado.

CEVIU IALeitura de 2 min
Imagem: Reprodução · techcommunity.microsoft.com
Receba o essencial de tech no e-mail

Curadoria diária por IA. Grátis, cancele quando quiser.

Ao se inscrever você concorda com a Política de Privacidade. Confirmação por e-mail · cancele quando quiser.

Últimas

Como a SmileID escalou a verificação de identidade para mais de 18.000 tipos de dispositivos Android com CameraX

Apps de verificação de identidade para bancos e registro de chips precisam de capturas faciais nítidas e em alta resolução para detectar spoofing e deepfakes. Para quem desenvolve câmeras no Android, o desafio comum é capturar frames bons o bastante para liveness e anti-spoofing sem derrubar aparelhos com pouca memória. Para a SmileID, SDK de verificação de identidade líder na África, o problema é maior por causa da diversidade de hardware. O Android responde por 85% do mercado-alvo da empresa, que inclui smartphones de entrada com processadores muito limitados, modelos regionais pouco conhecidos e terminais de ponto de venda (POS) customizados e reforçados. Antes do CameraX, a empresa lidava com previews esticados, orientações de sensor rotacionadas, crashes por falta de memória (OOM) e bugs específicos de OEMs. Segundo a SmileID, a migração dos SDKs Android para o CameraX transformou esses obstáculos em vantagem de negócio. Com as APIs legadas Camera1 e Camera2, de baixo nível, os resultados eram inconsistentes: fabricantes reportavam a orientação do sensor de formas diferentes, pedir um tamanho de frame em aparelhos de entrada distorcia o preview e inviabilizava a verificação biométrica, e processar imagens brutas em dispositivos com 1 GB de RAM ou menos causava crashes. Com isso, o crescimento anual de adoção do SDK ficava limitado a 2-3x, e muitas verificações recorriam ao upload de fotos estáticas por uma API REST de alta latência, em vez de liveness em tempo real no dispositivo. A SmileID reconstruiu seus SDKs móveis com o CameraX, usando os casos de uso Preview, que exibe o feed proporcional da câmera, e ImageAnalysis, que processa frames localmente em tempo real, detecta liveness e rosto no enquadramento e extrai a selfie verificada. Para capturar detalhes nítidos sem causar OOM, a empresa adicionou a API ResolutionSelector à configuração do ImageAnalysis, que permite pedir uma resolução-alvo e definir uma regra de fallback quando o aparelho não suporta o tamanho exato. Combinada com STRATEGY_KEEP_ONLY_LATEST, a FALLBACK_RULE_CLOSEST_HIGHER_THEN_LOWER prioriza a nitidez e a FALLBACK_RULE_CLOSEST_LOWER_THEN_HIGHER limita o uso de memória. O resultado foi um aumento de 4x na resolução das selfies capturadas, com a região recortada do rosto comprimida no dispositivo para manter o tamanho do upload igual ao do sistema anterior.

CEVIU Startups, Tecnologia e ProgramaçãoLeitura de 2 min

Arquiteto-chefe da JioStar conta como levou a descoberta de conteúdo com IA ao JioHotstar, com mais de 500 milhões de consumidores

A JioStar opera plataformas de entretenimento e esportes ao vivo usadas por mais de 500 milhões de consumidores e já chegou a 72,5 milhões de espectadores simultâneos de esportes ao vivo. Nessa escala, a IA precisa ser rápida, confiável e pronta para produção. Com a OpenAI API, a empresa criou no JioHotstar um assistente conversacional para descobrir vídeos e consultar estatísticas de críquete. O espectador fala de forma natural para encontrar filmes e séries, destaques históricos, momentos de partidas ao vivo ou estatísticas, e recebe os resultados em uma experiência visual e conversacional. No Executive Summit da OpenAI em Singapura, Sidharth Sharma, Head of Go-to-Market da OpenAI para a ASEAN, conversou com Vijay Seshadri, Chief Architect da JioStar, sobre como construir a experiência para mais de 15 idiomas em cerca de oito semanas e sobre as lições para líderes que levam a IA da demonstração à produção. Seshadri afirma que a descoberta de conteúdo evoluiu pouco nos últimos 25 anos, com as recomendações como a última grande mudança. Para ele, a conversa permite ao espectador explicar o que quer, ideia que a empresa chama de voice-visual interface. O projeto começou em outubro e novembro, com um grande torneio de críquete previsto para fevereiro, e precisou atender dois públicos: espectadores de entretenimento e fãs de críquete. Desde cedo, o problema foi tratado como um tradeoff entre precisão, latência e custo. Mais de 60% dos usuários usam voz em vez de texto. Em produção, Seshadri descreve um framework de avaliação e uma camada de validação, com um ciclo de feedback que transforma comportamentos e falhas de clientes em novos casos de eval. Especialistas de domínio, como editores de revistas esportivas, foram essenciais para as evals de estatísticas. A equipe começou pequena, com cientistas de dados e engenheiros, apoiada por forward-deployed engineers da OpenAI, e definiu primeiro o escopo e os guardrails, decidindo o que o sistema não deveria responder.

CEVIU IALeitura de 2 min

Microsoft detalha 59 reports de bugs no kernel Linux encontrados com o MDASH, entre eles 33 CVEs

No FORGE Lab da Microsoft, a equipe usou o codinome MDASH para escanear um subconjunto de subsistemas do kernel Linux entre o fim de maio e meados de junho de 2026. O esforço de três meses, liderado por um pesquisador em tempo integral e um estagiário, gerou até agora 59 reports públicos upstream e 33 CVEs atribuídos. Em oito desses CVEs foram confirmados exploits funcionais de escalonamento de privilégios para root, e 38 dos reports já tiveram correções incorporadas à mainline. Os scans iniciais produziram 26.502 achados brutos em cerca de duas semanas, mas transformá-los em bugs reproduzíveis, reports upstream e patches levou meses de investigação especializada e colaboração com os maintainers do Linux. Os subsistemas escolhidos incluem networking, filesystems e security modules, sem dependência óbvia de hardware especializado, o que simplificou a validação com QEMU. O scan de código usou principalmente Sonnet 4.6 (71,1% dos tokens), GPT-5.4 (20,1%) e GPT-5.5 (7,1%). Depois de filtrar afirmações de baixa confiança com os níveis de confiança do MDASH e agentes de triagem próprios, restaram 11.769 candidatos. Agentes geradores de PoC tentaram reproduzi-los em QEMU, principalmente com GPT-5.5 (77,3% dos tokens), Opus 4.6 (13,2%) e GPT-5.5-cyber (9,4%). Especialistas revisaram os 621 casos com evidência de PoC. Desses 621 casos, 59 viraram reports (9,5%). Dos demais, 266 (42,8%) compartilhavam causa raiz com outro caso, 163 (26,2%) não foram reportados após a revisão, em sua maioria por impacto de segurança limitado, e 133 (21,4%) já haviam sido reportados ou corrigidos upstream. O primeiro report público saiu em 27 de junho de 2026. Até 1º de setembro, 55 dos 59 estavam nas listas públicas; os outros quatro foram reportados em privado e encaminhados às listas públicas até meados de outubro. O Linux upstream normalmente exige que reports de vulnerabilidade venham com um patch funcional. Os agentes ajudaram a redigir as correções iniciais, mas validação humana, conhecimento dos subsistemas e iterações com os maintainers continuaram essenciais. Até agora, 38 correções foram incorporadas à mainline, metade na primeira submissão e o restante após uma a quatro revisões. Do primeiro patch público até um release da mainline, a mediana foi de 41 dias (máximo de 108). A maioria dos bugs estava no kernel havia anos: a idade média era de 8,1 anos no primeiro report público. Um dos mais antigos, um bug de shift-out-of-bounds em cls_u32 (CVE-2026-74544), existia havia pelo menos 21 anos. Dos 33 CVEs atribuídos até agora, 24 têm classificação High ou superior (CVSS v3.1 de pelo menos 7,0).

CEVIU Segurança da InformaçãoLeitura de 3 min

BMW i3 percorre 5.886 km da Noruega à Espanha com menos de 3 horas de recarga

Um BMW i3 50 xDrive saiu do Cabo Norte, na Noruega, e chegou a Tarifa, na Espanha, passando por oito países e rodando 3.658 milhas (5.886,7 km) com apenas 2 horas, 45 minutos e 54 segundos de recarga. Segundo a BMW, o resultado supera em mais de sete horas o recorde anterior do desafio Paneuropeana, estabelecido em 2017. Nele, os motoristas cruzam a Europa de norte a sul por checkpoints definidos, com liberdade para escolher a rota e onde recarregar. A BMW usou carregadores públicos, com potência média de 275 kW nas paradas. O consumo foi de 12,5 kWh/100 km (cerca de 5 milhas por kWh). Com a bateria de 108,7 kWh, isso equivale a cerca de 869 km de autonomia real até 0%, acima dos 468 milhas (classificação EPA) do i3 50 xDrive com pneus de verão de 20 polegadas. O carro do recorde usou rodas aerodinâmicas de 19 polegadas e pneus de baixa resistência ao rolamento. A viagem de 75 horas teve velocidade média de 79,7 km/h. O sedã usa a sexta geração da tecnologia de propulsão elétrica da BMW, com arquitetura de 800 volts e células cilíndricas em design cell-to-pack. Aceita recarga bidirecional, com pico de 400 kW em corrente contínua. A BMW indica 21 minutos para ir de 10% a 80% e até 423 km de autonomia WLTP adicionados em 10 minutos. A marca já havia demonstrado a autonomia da plataforma Neue Klasse com um iX3 de produção que foi de Debrecen, na Hungria, a Munique, na Alemanha, em 1.007 km sem recarregar, chegando com 2% de bateria. Isso exigiu preparação, direção principalmente em estradas secundárias e desligamento de sistemas, como o ar-condicionado. O autor relata que, em um test drive do iX3 na Romênia, percorreu cerca de 400 km no segundo dia, incluindo trechos de montanha, e chegou com 16% de bateria. Ele também afirma que, no Eurocharge 2025, rodou mais de 4.800 km pela Europa em diferentes elétricos e raramente teve problemas para encontrar um carregador rápido funcionando.

CEVIU Mobilidade ElétricaLeitura de 2 min

Node.js 26.13.1 (LTS) é release de segurança e corrige 18 vulnerabilidades em http2, TLS e outros módulos

O Node.js 26.13.1 'Lithium' (LTS), publicado em 11 de novembro de 2026, é um release de segurança. Ele corrige 18 vulnerabilidades: 9 de severidade alta, 6 de severidade média e 3 de severidade baixa. As correções de severidade alta se concentram em http2 e tls: liberação de headers quando um stream é removido, prevenção de execução aninhada do parser a partir de writes vazios (tls e http), detecção de streams abandonados pelo nghttp2, retenção de buffers até que os writes no socket terminem e retenção de streams durante writes pendentes. No TLS, o release desabilita a retomada de sessão em mTLS sem contexto de session id, impede que renegociação, HRR ou retomada de sessão alterem o SNI e corrige um crash de servidor TLS alcançável remotamente. A maior parte dessas correções é de Matteo Collina; as de TLS são de Tim Perry. Entre as de severidade média estão o overflow de buffers ALTSVC no http2, a aplicação da CA de contextos SNI sem certificado, a contabilização em maxSessionMemory dos dados DATA recebidos e retidos por streams, a ocultação de credenciais de proxy em erros de URL de proxy inválida, uma proteção contra write request nulo em stream cancelado e o isolamento das chaves de política TLS do Agent em https. As de severidade baixa tratam do vazamento de descendentes negados no fs.watch recursivo e da verificação do destino de heap snapshot, ambas no modelo de permissões e de autoria de RafaelGSS, além do tratamento do callback de params do zlib após destroy. O release também atualiza dependências: brotli 1.2.1, llhttp 9.4.4, sqlite 3.54.1 e undici 8.12.4. Há ainda ajustes de build e crypto para respeitar o nível de API configurado do OpenSSL e corrigir builds com versões mais antigas do OpenSSL 3.0.

CEVIU Web DevLeitura de 2 min

AlloyDB AI ganha ai.classify e ai.extract para classificar e extrair dados de texto direto em SQL

Bancos de dados transacionais guardam grandes volumes de texto não estruturado, como notas clínicas, avaliações de clientes, tickets de suporte, faturas e descrições de imóveis. Processar esse conteúdo exigia código de aplicação complexo: exportar dados, chamar endpoints de modelos externos, escrever wrappers de prompt, interpretar respostas imprevisíveis, gerenciar retries e atualizar registros. Esse ciclo gera atrito operacional, aumenta a latência das consultas, incha o código, eleva o custo de tokens e cria riscos de compliance ao mover dados sensíveis por várias fronteiras de rede. Para levar o conhecimento de mundo do Gemini ao banco operacional, o AlloyDB AI anunciou o preview de duas funções SQL no query engine, ai.classify e ai.extract. Elas estão na extensão google_ml_integration (versão 1.6.1 ou posterior) no PostgreSQL 18 e permitem classificação e extração estruturada dentro do banco, com SQL padrão. O smart batching para funções de IA (antes chamado de AI Function Acceleration) dá escalabilidade e desempenho para produção. A ai.classify categoriza texto em classes definidas pelo usuário, sem prompt engineering manual. As categorias podem ser uma lista simples de rótulos ou uma lista com nomes e descrições para orientar o modelo. Há classificação single-label (output_mode => 'single'), que atribui a melhor categoria, e multi-label (output_mode => 'multi'), que retorna todas as categorias correspondentes. A função também aceita descrições em arrays 2D, few-shot prompting com exemplos inline e modos de execução para linhas individuais (TEXT), arrays (TEXT[]) e cursores (REFCURSOR). Já a ai.extract converte texto não estruturado em JSON estruturado compatível com o schema desejado, informado como JSON schema padrão ou como lista de campos em texto simples. As instruções de sistema são tratadas internamente, sem templates de prompt ou parsers de resposta. A função tem assinaturas sobrecarregadas para linhas individuais, arrays e batching via cursor. Avaliar IA linha a linha pode deixar as consultas lentas. Por isso, quando ai.classify ou ai.extract são usadas em expressões de cláusulas WHERE, o AlloyDB agrupa automaticamente as entradas em micro-batches otimizados antes de enviá-las aos modelos da Gemini Enterprise Agent Platform. O smart batching acelera a inference em relação à avaliação linha a linha e reduz o gasto total de tokens ao otimizar o overhead do prompt de entrada. Na saúde, as funções convertem notas clínicas em texto livre em registros estruturados com nomes de pacientes, sintomas e medicamentos prescritos, mantendo os dados dentro do banco. Em serviços financeiros, extraem dados de fornecedores, datas de faturas e totais de itens a partir do texto de documentos digitalizados.

CEVIU DadosLeitura de 3 min

CNCF lança User Groups, espaços duradouros para colaboração entre usuários finais de cloud native

A CNCF End User Community lançou o User Group Program durante a KubeCon + CloudNativeCon North America. Os grupos são duradouros, organizados por setor da indústria ou domínio de problema, atendem a necessidades comuns dos usuários finais e se reportam diretamente ao CNCF Technical Advisory Board (TAB). A adoção de cloud native muda conforme o contexto: uma rede de telecom, um laboratório de pesquisa, um órgão público e um time de plataforma de uma empresa de software têm restrições, vocabulário e lacunas de ferramentas próprias. O User Group oferece a cada comunidade um lugar durável para se organizar, em vez de depender de iniciativas pontuais que se dissipam após um projeto ou evento. Cada grupo representa os usuários finais do seu domínio, identifica lacunas no portfólio de projetos da CNCF e ajuda a atrair projetos para preenchê-las, produz conteúdo educativo imparcial e prático, propõe arquiteturas de referência, boas práticas e how-tos criados pela comunidade e dá feedback aos projetos da CNCF sobre usabilidade, confiabilidade e desempenho. Há também responsabilidades: os grupos operam sob um charter, são liderados por chairs aprovados pelo TAB, realizam ao menos uma reunião pública mensal gravada e publicada no YouTube e prestam contas periodicamente ao TAB. Espera-se ainda participação na KubeCon + CloudNativeCon, com palestras, estandes ou atualizações do ecossistema. O programa foi desenhado como um caminho. Os Technical Community Groups (TCGs), dentro do CNCF Community Groups Program, são o ponto de partida leve. Para virar User Group, um TCG precisa ter concluído diversas iniciativas, cobrir uma lacuna não atendida por outro grupo e obter aprovação do TAB; depois redige um charter com escopo definido, votado pelo TAB. Domínios voltados a projetos seguem para o Technical Oversight Committee (TOC) e podem se tornar um Technical Advisory Group (TAG). Platform Engineering é o exemplo: começou como Working Group do antigo TAG App Delivery, virou TCG na reestruturação dos TAGs no ano passado e agora está em transição para User Group, após produzir o Platform Engineering Maturity Model e o Platforms White Paper.

CEVIU DevOpsLeitura de 2 min

LF Research lança série de estudos de 2027 e abre chamada para patrocinadores

A LF Research lançou sua série de estudos para 2027 e abriu a chamada para patrocinadores. Segundo o texto, as pesquisas fornecem dados valiosos às organizações e são uma oportunidade de interagir com a comunidade open source em geral e ouvi-la. Ao patrocinar, a organização pode influenciar resultados, ganhar reconhecimento de marca e obter outros benefícios. Os estudos listados são o relatório 2027 CRA Awareness, Evaluating AI Interventions for Healthcare CIOs e New Challenges in Enterprise Software Procurement Strategy. A agenda com mais detalhes de cada projeto está disponível para download. Em troca de um compromisso financeiro descrito como modesto, os patrocinadores recebem uma combinação de benefícios. Para patrocinar um estudo, o contato é [email protected].

CEVIU TILeitura de 1 min

Zen 6 da AMD: branch predictor mais rápido e dual decode cluster para superar a Zen 5

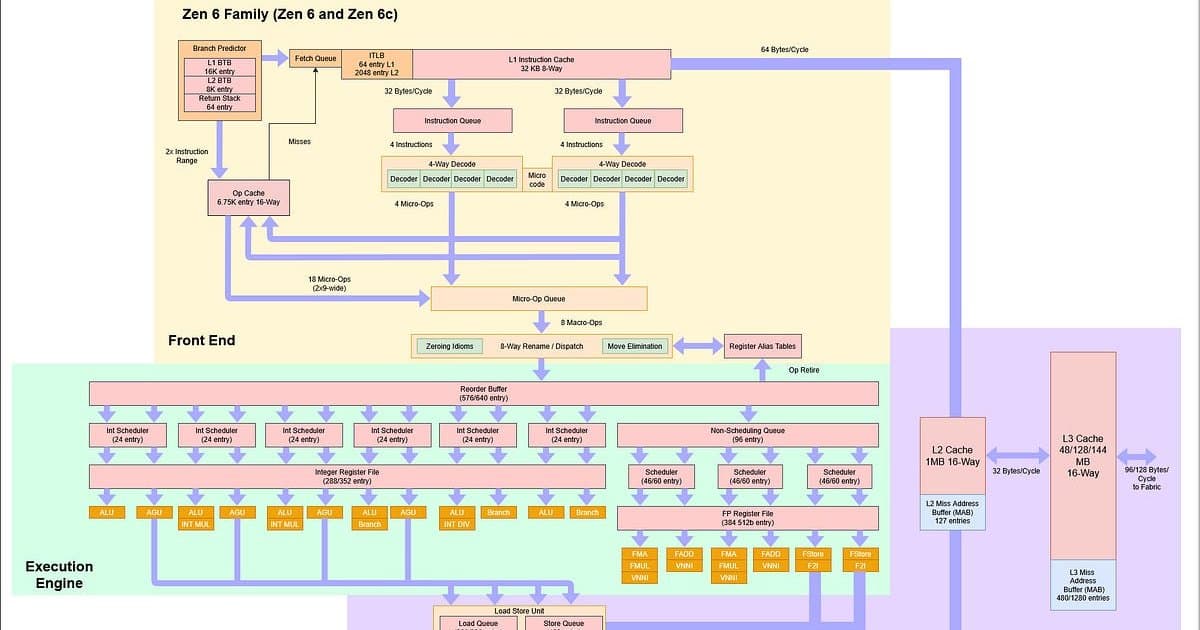
As CPUs Zen 6 da AMD avançam em relação à Zen 5 com um branch predictor mais rápido, um dual decode cluster para threads únicas e estruturas out-of-order otimizadas para reduzir stalls de memória. A principal diferença entre a Zen 6 e a Zen 6c está no ajuste arquitetural: a Zen 6 prioriza desempenho em frequências altas, enquanto a Zen 6c amplia a absorção de latência com caches maiores e mais núcleos.

CEVIU HardwareLeitura de 1 min

Antes de contratar mais vendedores, calcule quanto cada contrato custa em horas humanas

O responsável de receita da Lassie descreveu contratos anuais de US$ 15.000 a US$ 20.000 fechados em seis a sete dias, com algumas ligações e sem solutions engineer. A sugestão do texto é fazer uma conta simples: para cada um dos seus últimos dez negócios fechados, divida o valor anual do contrato pelas horas humanas gastas para conquistá-lo, incluindo o trabalho de sales engineering e jurídico. Se esse número cair à medida que você adiciona reps, o caminho é corrigir pricing e packaging antes de contratar mais.

CEVIU EmpreendedoresLeitura de 1 min

Vitalik defende ETH como reserva de valor e relativiza a queima de taxas

Vitalik Buterin defende que a proposta de valor do ETH está mais bem fundamentada na ideia de reserva de valor (store of value) do que nos mecanismos de queima de taxas. Segundo ele, otimizar para a queima exigiria trade-offs que prejudicam a descentralização e a resistência à captura. O mecanismo de queima do EIP-1559 continua intacto, mas Buterin o trata como algo incidental e afirma que uma queima de taxas abaixo de 10% do ponto de equilíbrio é aceitável no longo prazo, já que o valor do ETH vem de outras fontes. O argumento de store of value se apoia nas propriedades CROPS do Ethereum, que geram estabilidade em nível de protocolo, atributo mais valorizado por quem deposita ativos na rede. Buterin cita a era de disrupção da IA como o contexto de demanda em que essa estabilidade se torna uma vantagem concreta do ETH como reserva de valor.

CEVIU CriptoLeitura de 1 min

Post reúne 236 ideias de PR para pegar carona no lançamento de GTA VI

Segundo o post no LinkedIn, Grand Theft Auto VI será lançado em 9 dias, o que abre uma oportunidade para empresas de fora do setor de games conquistarem cobertura da imprensa. O conteúdo reúne 236 ideias de PR, agrupadas em 11 plays, com a descrição de como cada uma ficaria no contexto de GTA 6. Cada ideia é baseada em uma campanha real que levou uma marca de fora dos games para a imprensa.

CEVIU MarketingLeitura de 1 min

Anthropic mira avaliação de US$ 1,3 trilhão em IPO com ações entre US$ 70 e US$ 78

A Anthropic planeja vender 825 milhões de ações em sua oferta pública inicial (IPO), a uma faixa de US$ 70 a US$ 78 por ação. A estreia na bolsa está prevista para a quinta-feira da próxima semana. A empresa espera captar outros US$ 26 bilhões com grandes investidores, entre eles Google e AMD. Alguns executivos e membros fundadores pretendem vender cerca de 23,6 milhões de ações na oferta. Na avaliação planejada, o IPO da Anthropic não superará a oferta recorde da SpaceX, realizada em junho.

CEVIULeitura de 1 min

Apple Watch Series 12 e Ultra 4 passam a avisar no pulso quando a campainha toca e outros sons são detectados

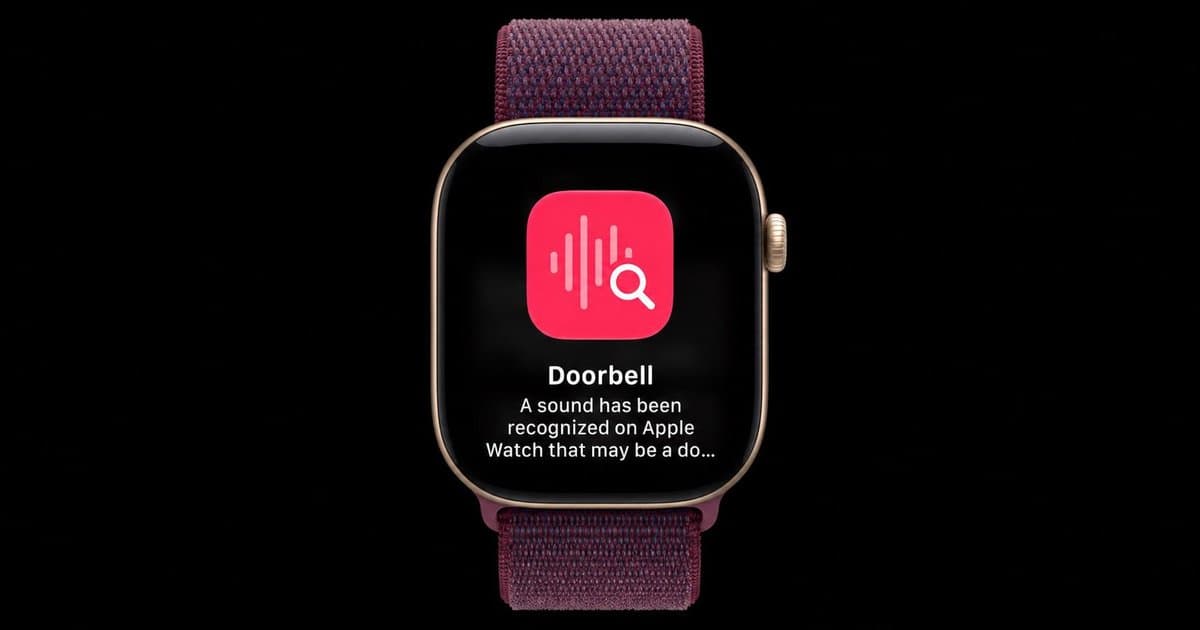
Um recurso de acessibilidade do iPhone, o Sound Recognition, ouve sons importantes ao redor, como campainha, sirene ou alarme, e envia uma notificação quando identifica um deles. Agora ele foi estendido aos novos Apple Watch Series 12 e Apple Watch Ultra 4, e o alerta chega ao pulso mesmo quando o iPhone não está por perto. O recurso é especialmente útil para pessoas surdas ou com deficiência auditiva, mas também tem usos no dia a dia. Quem trabalha com fones com cancelamento de ruído e não quer perder a campainha, por exemplo ao esperar uma entrega, pode contar com o aviso do relógio. O Sound Recognition detecta 15 sons. Os que forem ativados na lista Sounds do iPhone também são detectados pelo Apple Watch quando a opção Detect using Apple Watch está ligada. Se um som não for reconhecido automaticamente, é possível ensinar ao iPhone um Custom Alarm, um Custom Appliance ou uma Custom Doorbell na mesma lista. É preciso ter um Apple Watch Series 12 ou Ultra 4 pareado com um iPhone 11 ou posterior, ou um iPhone SE (2ª geração ou posterior), com iOS 27. Quem já usa o Sound Recognition no iPhone tem o recurso ativado automaticamente no relógio. Para configurar, abra Ajustes no iPhone e toque em Acessibilidade. Na seção Audição, entre em Reconhecimento de Som e Nome, depois em Reconhecimento de Som, ative a chave e ligue Detect using Apple Watch. Em Sounds, selecione os sons desejados, como Doorbell. Também é possível escolher um tom de alerta para cada som. Segundo a Apple, o processamento é feito no Apple Watch e no iPhone, e o recurso não grava nem armazena áudio. Ainda assim, ele não deve ser tratado como sistema de segurança: de acordo com as diretrizes da Apple, não se deve confiar nele em situações com risco de dano ou lesão, em contextos de alto risco ou emergência, nem para navegação.

CEVIU Smartphones e AcessóriosLeitura de 2 min

Dynamic Creatures e Sixth Wall Studio, da Hasbro, se unem para levar personagens a robôs interativos

A Dynamic Creatures anunciou parceria com a Sixth Wall Studio, estúdio de IA lançado pela Hasbro em junho de 2026. O plano é dar vida a personagens da Hasbro com robôs interativos, combinando os robôs móveis e expressivos da Dynamic Creatures com o character authoring e o alignment da Sixth Wall. A ideia é que os personagens recebam visitantes, compartilhem aventuras e se lembrem deles em novas visitas a parques temáticos, resorts e outros locais de entretenimento e hospitalidade. Segundo Marc Theermann, cofundador e CEO da Dynamic Creatures, o CharacterOS hoje está focado em voz, enquanto a empresa cuida da incorporação física. A Sixth Wall vai estender o CharacterOS e o framework de Behavioral Licensing para experiências físicas, definindo como os personagens falam, se comportam e se mantêm fiéis a personalidades e histórias. Os robôs ligam conversa e personalidade a movimentos, olhares, gestos e reações expressivas. Um exemplo: o personagem recebe um hóspede em um resort, o envia em uma missão e, no encontro seguinte, pergunta como foi. Em exploração, o visitante mostraria o ingresso ao robô, que o identificaria e sugeriria restaurantes ou formas de pular filas. As empresas também preveem usos em hotéis, cruzeiros e varejo. As experiências com memória dependeriam da escolha do visitante e de permissões claramente definidas, e os detalhes de implantação seriam definidos por local e caso de uso. As primeiras aplicações da Sixth Wall seguiriam o foco em público com 13 anos ou mais. Em segurança, Theermann diz que hoje há um humano no circuito e que, com mais autonomia, o supervisor deve passar da teleoperação para o telemonitoramento. A Dynamic Creatures saiu do stealth em setembro de 2026 e desenvolve robôs totalmente personalizados e experiências de personagens sobre plataformas robóticas existentes. Sediada em Cambridge, Massachusetts, é parceira oficial de hospitalidade e entretenimento da Boston Dynamics. Sua plataforma SnowJay de IA robótica coordena percepção, movimento e comportamento, reunindo conversação, memória, expressões faciais e animatrônica. A empresa lançou recentemente o Hugo, seu primeiro robô de personagem. Estágio: Protótipo/Promessa, com parceria em fase inicial de pesquisa e exploração de casos de uso.

CEVIU Robótica HumanoideLeitura de 2 min

Revolut conclui rodada e chega a avaliação de US$ 115 bilhões

A transação da Revolut, realizada em 4 de novembro, reúne investidores como Coatue, T. Rowe Price e Baillie Gifford. A operação também dá aos funcionários outra oportunidade de vender ações. O valor captado não foi divulgado. A avaliação acompanha o lançamento de bancos em outros países e a aprovação condicional de uma licença bancária (charter) nos EUA. Aprofundar o relacionamento com os clientes, porém, continua sendo um desafio. Segundo a Reuters, o crédito representava apenas 6% dos depósitos no fim de 2025, o que deixa bastante espaço para expansão, mas também implica maior risco de crédito.

CEVIU FintechLeitura de 1 min

No radar

além das notícias

Por editoria

CEVIU Web Dev

Node.js 26.13.1 (LTS) é release de segurança e corrige 18 vulnerabilidades em http2, TLS e outros módulos

O Node.js 26.13.1 'Lithium' (LTS), publicado em 11 de novembro de 2026, é um release de segurança. Ele corrige 18 vulnerabilidades: 9 de severidade alta, 6 de severidade média e 3 de severidade baixa. As correções de severidade alta se concentram em http2 e tls: liberação de headers quando um stream é removido, prevenção de execução aninhada do parser a partir de writes vazios (tls e http), detecção de streams abandonados pelo nghttp2, retenção de buffers até que os writes no socket terminem e retenção de streams durante writes pendentes. No TLS, o release desabilita a retomada de sessão em mTLS sem contexto de session id, impede que renegociação, HRR ou retomada de sessão alterem o SNI e corrige um crash de servidor TLS alcançável remotamente. A maior parte dessas correções é de Matteo Collina; as de TLS são de Tim Perry. Entre as de severidade média estão o overflow de buffers ALTSVC no http2, a aplicação da CA de contextos SNI sem certificado, a contabilização em maxSessionMemory dos dados DATA recebidos e retidos por streams, a ocultação de credenciais de proxy em erros de URL de proxy inválida, uma proteção contra write request nulo em stream cancelado e o isolamento das chaves de política TLS do Agent em https. As de severidade baixa tratam do vazamento de descendentes negados no fs.watch recursivo e da verificação do destino de heap snapshot, ambas no modelo de permissões e de autoria de RafaelGSS, além do tratamento do callback de params do zlib após destroy. O release também atualiza dependências: brotli 1.2.1, llhttp 9.4.4, sqlite 3.54.1 e undici 8.12.4. Há ainda ajustes de build e crypto para respeitar o nível de API configurado do OpenSSL e corrigir builds com versões mais antigas do OpenSSL 3.0.

Ver todas de CEVIU Web Dev

CEVIU Segurança da Informação

Microsoft detalha 59 reports de bugs no kernel Linux encontrados com o MDASH, entre eles 33 CVEs

No FORGE Lab da Microsoft, a equipe usou o codinome MDASH para escanear um subconjunto de subsistemas do kernel Linux entre o fim de maio e meados de junho de 2026. O esforço de três meses, liderado por um pesquisador em tempo integral e um estagiário, gerou até agora 59 reports públicos upstream e 33 CVEs atribuídos. Em oito desses CVEs foram confirmados exploits funcionais de escalonamento de privilégios para root, e 38 dos reports já tiveram correções incorporadas à mainline. Os scans iniciais produziram 26.502 achados brutos em cerca de duas semanas, mas transformá-los em bugs reproduzíveis, reports upstream e patches levou meses de investigação especializada e colaboração com os maintainers do Linux. Os subsistemas escolhidos incluem networking, filesystems e security modules, sem dependência óbvia de hardware especializado, o que simplificou a validação com QEMU. O scan de código usou principalmente Sonnet 4.6 (71,1% dos tokens), GPT-5.4 (20,1%) e GPT-5.5 (7,1%). Depois de filtrar afirmações de baixa confiança com os níveis de confiança do MDASH e agentes de triagem próprios, restaram 11.769 candidatos. Agentes geradores de PoC tentaram reproduzi-los em QEMU, principalmente com GPT-5.5 (77,3% dos tokens), Opus 4.6 (13,2%) e GPT-5.5-cyber (9,4%). Especialistas revisaram os 621 casos com evidência de PoC. Desses 621 casos, 59 viraram reports (9,5%). Dos demais, 266 (42,8%) compartilhavam causa raiz com outro caso, 163 (26,2%) não foram reportados após a revisão, em sua maioria por impacto de segurança limitado, e 133 (21,4%) já haviam sido reportados ou corrigidos upstream. O primeiro report público saiu em 27 de junho de 2026. Até 1º de setembro, 55 dos 59 estavam nas listas públicas; os outros quatro foram reportados em privado e encaminhados às listas públicas até meados de outubro. O Linux upstream normalmente exige que reports de vulnerabilidade venham com um patch funcional. Os agentes ajudaram a redigir as correções iniciais, mas validação humana, conhecimento dos subsistemas e iterações com os maintainers continuaram essenciais. Até agora, 38 correções foram incorporadas à mainline, metade na primeira submissão e o restante após uma a quatro revisões. Do primeiro patch público até um release da mainline, a mediana foi de 41 dias (máximo de 108). A maioria dos bugs estava no kernel havia anos: a idade média era de 8,1 anos no primeiro report público. Um dos mais antigos, um bug de shift-out-of-bounds em cls_u32 (CVE-2026-74544), existia havia pelo menos 21 anos. Dos 33 CVEs atribuídos até agora, 24 têm classificação High ou superior (CVSS v3.1 de pelo menos 7,0).

Ver todas de CEVIU Segurança da Informação

CEVIU Dados

AlloyDB AI ganha ai.classify e ai.extract para classificar e extrair dados de texto direto em SQL

Bancos de dados transacionais guardam grandes volumes de texto não estruturado, como notas clínicas, avaliações de clientes, tickets de suporte, faturas e descrições de imóveis. Processar esse conteúdo exigia código de aplicação complexo: exportar dados, chamar endpoints de modelos externos, escrever wrappers de prompt, interpretar respostas imprevisíveis, gerenciar retries e atualizar registros. Esse ciclo gera atrito operacional, aumenta a latência das consultas, incha o código, eleva o custo de tokens e cria riscos de compliance ao mover dados sensíveis por várias fronteiras de rede. Para levar o conhecimento de mundo do Gemini ao banco operacional, o AlloyDB AI anunciou o preview de duas funções SQL no query engine, ai.classify e ai.extract. Elas estão na extensão google_ml_integration (versão 1.6.1 ou posterior) no PostgreSQL 18 e permitem classificação e extração estruturada dentro do banco, com SQL padrão. O smart batching para funções de IA (antes chamado de AI Function Acceleration) dá escalabilidade e desempenho para produção. A ai.classify categoriza texto em classes definidas pelo usuário, sem prompt engineering manual. As categorias podem ser uma lista simples de rótulos ou uma lista com nomes e descrições para orientar o modelo. Há classificação single-label (output_mode => 'single'), que atribui a melhor categoria, e multi-label (output_mode => 'multi'), que retorna todas as categorias correspondentes. A função também aceita descrições em arrays 2D, few-shot prompting com exemplos inline e modos de execução para linhas individuais (TEXT), arrays (TEXT[]) e cursores (REFCURSOR). Já a ai.extract converte texto não estruturado em JSON estruturado compatível com o schema desejado, informado como JSON schema padrão ou como lista de campos em texto simples. As instruções de sistema são tratadas internamente, sem templates de prompt ou parsers de resposta. A função tem assinaturas sobrecarregadas para linhas individuais, arrays e batching via cursor. Avaliar IA linha a linha pode deixar as consultas lentas. Por isso, quando ai.classify ou ai.extract são usadas em expressões de cláusulas WHERE, o AlloyDB agrupa automaticamente as entradas em micro-batches otimizados antes de enviá-las aos modelos da Gemini Enterprise Agent Platform. O smart batching acelera a inference em relação à avaliação linha a linha e reduz o gasto total de tokens ao otimizar o overhead do prompt de entrada. Na saúde, as funções convertem notas clínicas em texto livre em registros estruturados com nomes de pacientes, sintomas e medicamentos prescritos, mantendo os dados dentro do banco. Em serviços financeiros, extraem dados de fornecedores, datas de faturas e totais de itens a partir do texto de documentos digitalizados.

Ver todas de CEVIU Dados

CEVIU Smartphones e Acessórios

Apple Watch Series 12 e Ultra 4 passam a avisar no pulso quando a campainha toca e outros sons são detectados

Um recurso de acessibilidade do iPhone, o Sound Recognition, ouve sons importantes ao redor, como campainha, sirene ou alarme, e envia uma notificação quando identifica um deles. Agora ele foi estendido aos novos Apple Watch Series 12 e Apple Watch Ultra 4, e o alerta chega ao pulso mesmo quando o iPhone não está por perto. O recurso é especialmente útil para pessoas surdas ou com deficiência auditiva, mas também tem usos no dia a dia. Quem trabalha com fones com cancelamento de ruído e não quer perder a campainha, por exemplo ao esperar uma entrega, pode contar com o aviso do relógio. O Sound Recognition detecta 15 sons. Os que forem ativados na lista Sounds do iPhone também são detectados pelo Apple Watch quando a opção Detect using Apple Watch está ligada. Se um som não for reconhecido automaticamente, é possível ensinar ao iPhone um Custom Alarm, um Custom Appliance ou uma Custom Doorbell na mesma lista. É preciso ter um Apple Watch Series 12 ou Ultra 4 pareado com um iPhone 11 ou posterior, ou um iPhone SE (2ª geração ou posterior), com iOS 27. Quem já usa o Sound Recognition no iPhone tem o recurso ativado automaticamente no relógio. Para configurar, abra Ajustes no iPhone e toque em Acessibilidade. Na seção Audição, entre em Reconhecimento de Som e Nome, depois em Reconhecimento de Som, ative a chave e ligue Detect using Apple Watch. Em Sounds, selecione os sons desejados, como Doorbell. Também é possível escolher um tom de alerta para cada som. Segundo a Apple, o processamento é feito no Apple Watch e no iPhone, e o recurso não grava nem armazena áudio. Ainda assim, ele não deve ser tratado como sistema de segurança: de acordo com as diretrizes da Apple, não se deve confiar nele em situações com risco de dano ou lesão, em contextos de alto risco ou emergência, nem para navegação.

Ver todas de CEVIU Smartphones e Acessórios

CEVIU Mobilidade Elétrica

Lynk & Co apresenta o 900L, SUV PHEV de sete lugares com bateria de até 70 kWh

A Lynk & Co apresentou o 900L em 10 de novembro, versão de sete lugares do SUV híbrido plug-in topo de linha da marca. O modelo tem baterias de até 70 kWh e bancos da segunda fileira que giram para ficar de frente para a terceira. O lançamento no mercado chinês está previsto para antes do fim de 2026, e o preço ainda não foi divulgado. O 900L é basicamente um 900 de sete lugares, com carroceria um pouco mais longa, dianteira redesenhada e bateria maior. O conjunto combina um motor 2.0 turbo a gasolina de 160 kW (215 cv) com dois motores elétricos e tração integral; o valor do motor a combustão não representa a potência combinada do sistema híbrido. A velocidade máxima informada é de 225 km/h. As baterias são de 55 kWh e 70 kWh, com autonomia elétrica informada de 245 km e 320 km, respectivamente, no ciclo WLTC. As células de lítio ternárias vêm de uma joint venture entre CATL e Geely. O SUV mede 5.280 mm de comprimento, 1.999 mm de largura e 1.810 mm de altura, com entre-eixos de 3.170 mm. Em relação ao 900 atual, a carroceria é 40 mm mais longa e o entre-eixos cresce 10 mm. Por fora, há conjunto de iluminação dianteira revisado, maçanetas semiocultas, sensor lidar acima do para-brisa e barra de luz traseira com o logotipo da marca iluminado. Por dentro, o layout passa de 2+2+2 no 900 de seis lugares para 2+2+3. Os dois bancos individuais da segunda fileira têm rotação elétrica de 180 graus e 550 mm de deslocamento longitudinal. O banco da terceira fileira tem 1.210 mm de largura, com 150 mm de ajuste longitudinal, aquecimento e massagem. O habitáculo traz duas telas de 30 polegadas e sistema de som Harman Kardon de 31 alto-falantes. Os bancos da segunda fileira oferecem massagem de 22 pontos com oito modos, apoios de perna aquecidos e apoios de braço elétricos. Os passageiros traseiros também contam com mesas dobráveis e um compartimento que pode resfriar ou aquecer o conteúdo. A Lynk & Co lançou o 900 de seis lugares em abril de 2025 e adicionou uma versão de cinco lugares em abril de 2026. A linha usa a arquitetura SPA Evo, desenvolvida para híbridos grandes. A apresentação ocorre em meio à queda nas vendas da marca: foram 21.958 veículos vendidos globalmente em outubro, 45,4% a menos que um ano antes, embora o volume tenha subido 18,7% em relação a setembro. No acumulado dos dez primeiros meses de 2026, foram 218.075 unidades, queda de 22,6% na comparação anual.

Ver todas de CEVIU Mobilidade Elétrica

CEVIU Startups, Tecnologia e Programação

Como a SmileID escalou a verificação de identidade para mais de 18.000 tipos de dispositivos Android com CameraX

Apps de verificação de identidade para bancos e registro de chips precisam de capturas faciais nítidas e em alta resolução para detectar spoofing e deepfakes. Para quem desenvolve câmeras no Android, o desafio comum é capturar frames bons o bastante para liveness e anti-spoofing sem derrubar aparelhos com pouca memória. Para a SmileID, SDK de verificação de identidade líder na África, o problema é maior por causa da diversidade de hardware. O Android responde por 85% do mercado-alvo da empresa, que inclui smartphones de entrada com processadores muito limitados, modelos regionais pouco conhecidos e terminais de ponto de venda (POS) customizados e reforçados. Antes do CameraX, a empresa lidava com previews esticados, orientações de sensor rotacionadas, crashes por falta de memória (OOM) e bugs específicos de OEMs. Segundo a SmileID, a migração dos SDKs Android para o CameraX transformou esses obstáculos em vantagem de negócio. Com as APIs legadas Camera1 e Camera2, de baixo nível, os resultados eram inconsistentes: fabricantes reportavam a orientação do sensor de formas diferentes, pedir um tamanho de frame em aparelhos de entrada distorcia o preview e inviabilizava a verificação biométrica, e processar imagens brutas em dispositivos com 1 GB de RAM ou menos causava crashes. Com isso, o crescimento anual de adoção do SDK ficava limitado a 2-3x, e muitas verificações recorriam ao upload de fotos estáticas por uma API REST de alta latência, em vez de liveness em tempo real no dispositivo. A SmileID reconstruiu seus SDKs móveis com o CameraX, usando os casos de uso Preview, que exibe o feed proporcional da câmera, e ImageAnalysis, que processa frames localmente em tempo real, detecta liveness e rosto no enquadramento e extrai a selfie verificada. Para capturar detalhes nítidos sem causar OOM, a empresa adicionou a API ResolutionSelector à configuração do ImageAnalysis, que permite pedir uma resolução-alvo e definir uma regra de fallback quando o aparelho não suporta o tamanho exato. Combinada com STRATEGY_KEEP_ONLY_LATEST, a FALLBACK_RULE_CLOSEST_HIGHER_THEN_LOWER prioriza a nitidez e a FALLBACK_RULE_CLOSEST_LOWER_THEN_HIGHER limita o uso de memória. O resultado foi um aumento de 4x na resolução das selfies capturadas, com a região recortada do rosto comprimida no dispositivo para manter o tamanho do upload igual ao do sistema anterior.

Ver todas de CEVIU Startups, Tecnologia e Programação

CEVIU Robótica Humanoide

Boston Dynamics põe rodas no Atlas para levar atuadores ao limite em testbed de pesquisa

Estágio: Pesquisa. Em texto no blog da Boston Dynamics, Xiaoyu (Andy) Wu, engenheiro de controle da equipe do Atlas, com mais de uma década de experiência em controle de motores elétricos e na eletrônica de potência que os aciona, descreve um experimento: o que acontece quando se colocam rodas em um humanoide conduzido por um controlador aprendido. A equipe trocou os pés do Atlas para descobrir, o que permitiu levar os atuadores, e os modelos deles, ao limite. Segundo Wu, as rodas não eram o objetivo, e sim levar a atuação ao limite. Ele cita o giro de 360 graus, feito a partir de captura de movimento (mocap) de um humano, com uma biblioteca de trajetórias e o trajectory targeting training pipeline, que funcionou de primeira. Nos deslocamentos laterais com salto (side dashes), o treinamento descobriu sozinho como usar as rodas para rolar. O treino foi feito em simulação, e a transferência para o hardware ocorreu, nas palavras dele, de forma praticamente perfeita. O próximo passo é melhorar a resposta da policy a atuadores com falha e investigar comportamentos emergentes de reinforcement learning nesses casos. A Boston Dynamics afirma que o Atlas com rodas não é um produto, e sim um research testbed. A empresa diz que, com anos de dados de clientes de Spot e Stretch, sabe que robôs no mundo real enfrentam desafios difíceis de recriar em laboratório. O objetivo era verificar com que fidelidade um whole-body controller aprendido funciona com atuadores reais operando nos limites de desempenho. As rodas foram escolhidas porque exigem torque e velocidade altos de forma contínua, sob carga real. A conversão foi simples: um adaptador customizado fixa uma roda de patinete comum ao atuador de tornozelo existente.

Ver todas de CEVIU Robótica Humanoide