

A Apache DataFusion lança a versão 1.1.0 do Comet, focando em expandir a execução nativa do Spark. Destaques incluem a introdução de gravações experimentais no Iceberg e a integração com o Celeborn para shuffle nativo, prometendo ganhos substanciais de performance. A atualização também aborda um ponto crítico de falha, a pressão de memória off-heap, com melhorias em contabilidade e logging, visando reduzir encerramentos inesperados de containers e garantir maior estabilidade operacional em ambientes de processamento de dados.

A WHOOP, empresa de tecnologia vestível, implementou um pipeline de Change Data Capture (CDC) self-service revolucionário. A solução permite que equipes de aplicação repliquem centenas de tabelas Postgres para o data warehouse de forma eficiente. O sistema foi projetado para otimizar o acesso a alterações brutas, desacoplando-o da materialização de tabelas – um processo mais lento e oneroso. Além disso, a ferramenta automatiza a evolução do esquema e a propriedade dos dados. A principal lição aprendida foi que a escalabilidade do CDC é maximizada quando a integração é impulsionada pela publicação e a responsabilidade operacional permanece alinhada ao serviço de origem, garantindo maior agilidade e controle.
Um estudo recente conduzido por um desenvolvedor no ecossistema PostgreSQL avaliou 179 recomendações de índices, revelando um impacto misto na performance de consultas. Embora 72% das implementações de índices tenham resultado em uma aceleração de pelo menos 15% nas consultas, um dado alarmante aponta que 18% das recomendações testadas, na verdade, degradaram o desempenho, com algumas consultas sofrendo uma desaceleração de mais de duas vezes. Essa análise sublinha a criticidade da validação empírica de índices antes de sua implantação em ambientes de produção, destacando que nem toda otimização sugerida se traduz em ganho real, podendo inclusive gerar gargalos significativos.
Dados de séries temporais vão muito além de simples valores e timestamps. Unidades de medida, proveniência, derivações e o tratamento de exceções são cruciais para um entendimento completo e correto. Ferramentas como JSON-LD e RDF surgem como soluções para tornar esse contexto explícito e consultável, elevando o nível de validação e interoperabilidade dos dados. A recomendação é clara: embora medições em massa devam ser armazenadas em formatos tabulares ou bancos de dados de séries temporais otimizados, uma camada de grafos é essencial para gerenciar metadados, semântica e detectar anomalias de forma eficiente. Isso garante que a "inteligência" de seus dados não se perca no volume.
Em um teste surpreendente, George Fraser, CEO da Fivetran, demonstrou que um iPhone 17 Pro, utilizando o DuckDB, superou clusters Databricks na maioria das cargas de trabalho TPC-H. Embora o iPhone possua recursos de CPU e memória consideravelmente inferiores, os resultados indicam uma mudança de paradigma: muitas operações de analytics de negócios não exigem a complexidade e o custo de sistemas distribuídos, podendo ser otimizadas e executadas de forma mais eficiente em máquinas únicas com engines como DuckDB ou Polars, redefinindo o processamento de dados e a IA.
Para garantir a confiabilidade de agentes de dados, que lidam com modelos e prompts em constante evolução, é crucial implementar testes de regressão, e não apenas demonstrações. Uma abordagem eficaz envolve a criação de um conjunto de "golden-questions" associadas a snapshots de dados imutáveis. Os resultados são avaliados com base nas execuções reais, integrando-se diretamente ao pipeline de Integração Contínua (CI). Gerenciar essas modificações nos agentes como lançamentos de software, com execuções armazenadas, limites de categoria e "hard safety gates", assegura a estabilidade e a qualidade dos dados.
O Polars 2.0 foi lançado, trazendo avanços significativos para o processamento de dados. A nova versão otimiza a execução de consultas, oferece suporte a SQL de primeira classe e introduz o tipo de dado Map, expandindo suas capacidades de modelagem. Destaca-se também a implementação de streaming com <i>spill-to-disk</i> por padrão, permitindo o processamento de grandes volumes de dados sem sobrecarregar a memória do sistema. Benchmarks indicam que o Polars 2.0 supera o desempenho de ferramentas como DuckDB e DataFusion em operações SQL, enquanto seu sistema de verificação de tipo mais rigoroso auxilia desenvolvedores e agentes de IA na identificação precoce de falhas.
A Google DeepMind apresentou o AlphaProtein Novo, uma inovadora ferramenta de IA capaz de projetar enzimas completamente novas. Essas enzimas sintéticas demonstram potencial significativo na criação de ingredientes farmacêuticos e na degradação de poluentes plásticos. Com a capacidade de superar o desempenho de enzimas naturais em diversas tarefas, o AlphaProtein Novo abre novas fronteiras para a pesquisa em medicina, química e remediação ambiental, prometendo impactos transformadores em escala industrial.
A HiringCafe realizou um benchmark comparativo entre a ferramenta Jev, a nova Decisions API da OpenAI e o Gemini 3.1 Flash-Lite, focando na correspondência de vagas a buscas e currículos. Os resultados indicaram que Jev demonstrou superioridade na precisão e eficácia, superando as outras soluções de IA nos testes. Este estudo ressalta a importância da escolha de ferramentas de IA otimizadas para tarefas específicas, especialmente em processos de recrutamento e seleção baseados em dados.
O Pinterest inovou com o lançamento do Metrics Board, uma plataforma centralizada que revoluciona a criação e gestão de métricas. A ferramenta automatiza a geração, verificações de qualidade, documentação e publicação de métricas, garantindo maior confiabilidade e agilidade. Atualmente, o Metrics Board gerencia mais de 98% das métricas de experimentação do Pinterest, reduzindo o tempo de desenvolvimento de semanas para dias. Além disso, a plataforma provê aos agentes de IA acesso a um ecossistema de métricas confiáveis e bem definidas, facilitando a tomada de decisões orientadas por dados.
A MotherDuck, em uma recente demonstração, revelou cinco aplicações práticas de seu modelo Jev IA para classificação de texto diretamente via SQL. Entre os exemplos estão a avaliação de desempenho de agentes de IA, análise de sentimento de consumidores, pontuação de chamadas de vendas e a categorização automática de vagas de emprego. O Jev se destaca por fornecer respostas pré-definidas acompanhadas de pontuações de confiança, oferecendo um processamento até 20 vezes mais rápido que chamadas LLM convencionais, o que barateia e democratiza a análise de texto em larga escala no ambiente de dados.
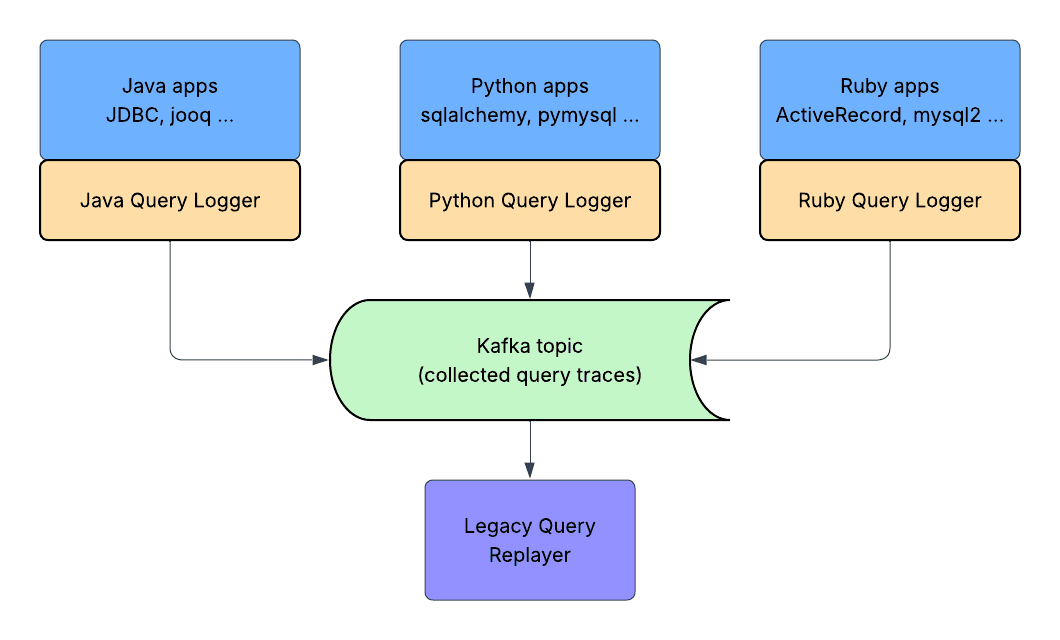
O Airbnb deu um salto na validação de performance de seus bancos de dados, especialmente MySQL, ao desenvolver um sistema capaz de capturar e replicar cargas de trabalho de produção. A nova abordagem minimiza a dependência de benchmarks sintéticos, permitindo que consultas reais sejam registradas com baixo impacto e reproduzidas fielmente, mantendo a ordem e o timing originais. Essa inovação é crucial para identificar regressões sutis em atualizações, migrações e planejamentos de capacidade, oferecendo uma visibilidade sobre o comportamento do sistema que testes convencionais não conseguiriam.
A recém-lançada versão 1.12.0 do Apache Iceberg promete elevar as capacidades da plataforma, incorporando suporte robusto para funcionalidades da versão 3, como tipos Variant e geoespaciais, linhagem de linha, vetores de exclusão, metadados criptografados e operações de catálogo REST. Contudo, a atualização exige cautela, visto que descontinua o suporte a plataformas e APIs legadas. Profissionais de dados devem planejar testes rigorosos de compatibilidade antes de implementá-la em ambientes de produção para evitar interrupções.
O Amazon Aurora PostgreSQL agora revoluciona a interação com Data Lakes ao permitir consultas diretas a tabelas Apache Iceberg e Parquet armazenadas no Amazon S3. Essa funcionalidade dispensa a complexidade de pipelines ETL ou reverse-ETL, otimizando o acesso a dados. Impulsionado pelo engine DuckDB, a novidade suporta a sintaxe padrão do PostgreSQL, com recursos como predicate pushdown e column pruning. Isso garante eficiência na análise de dados operacionais e históricos sem custos adicionais de licenciamento para o Aurora, promovendo uma arquitetura de dados mais ágil e acessível.
A Cloudflare acaba de lançar o Clef e o Clef-flash, modelos de Sistema 1 de código aberto que, de maneira análoga ao Jev, são capazes de converter entradas de texto ou imagem em decisões e probabilidades. Essa capacidade pode ser aplicada em diversas frentes, como no roteamento automático de tickets de suporte, na classificação de websites e na determinação de quando um agente de IA deve escalar uma consulta para um humano. Ambos os modelos são executáveis via Workers AI ou localmente, e a Cloudflare já oferece suporte para o fine-tuning, permitindo adaptações a tarefas específicas de cada usuário.
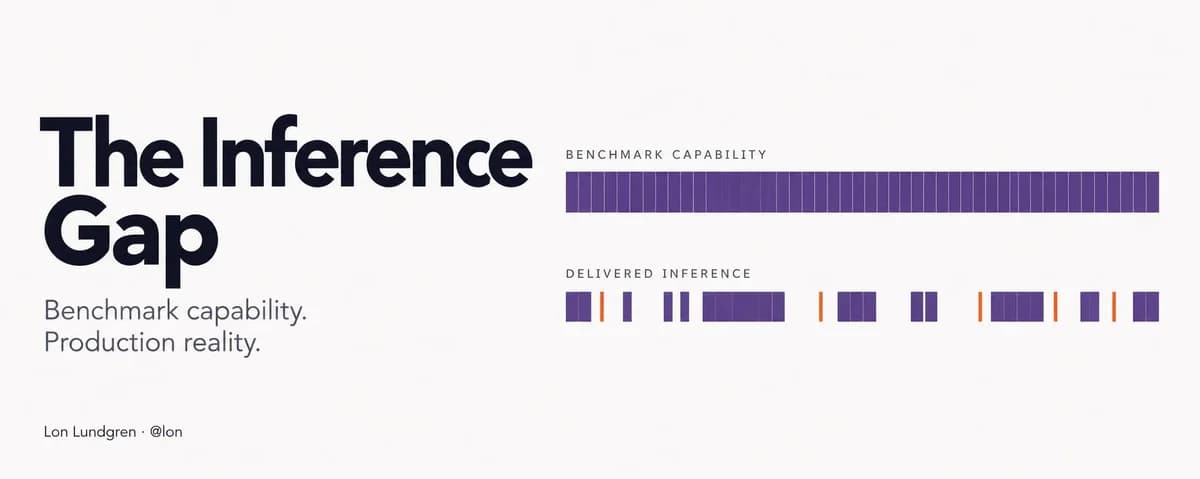
Uma análise aprofundada de 43.261 chamadas ao modelo Fable 5, realizada durante seis semanas, revelou uma discrepância significativa entre o desempenho esperado de LLMs em benchmarks e sua entrega efetiva em produção. O estudo indicou que, mesmo com o modelo nominalmente constante, o 'orçamento de raciocínio' alocado a cada inferência variava drasticamente, resultando em muitas invocações com capacidade de pensamento reduzida ou inexistente. Este fenômeno, apelidado de 'lacuna de inference', sugere que as otimizações para ambiente produtivo podem comprometer a capacidade de raciocínio sequencial que é crucial para os benchmarks, impactando a qualidade das respostas para os usuários finais.
A Datadog introduziu o Distributed DataFusion, uma extensão inovadora que capacita o Apache DataFusion a executar consultas complexas em múltiplas máquinas. A solução oferece um poder computacional superior para queries interativas exigentes, ao mesmo tempo em que preserva a eficiência em consultas mais leves, evitando sobrecargas desnecessárias. Em testes de produção, queries complexas demonstraram uma aceleração de até 10 vezes, sem incremento no custo total. A Datadog disponibilizou o Distributed DataFusion como um framework open-source, incentivando a adaptação por outras equipes às suas respectivas fontes de dados e infraestruturas, evidenciando seu compromisso com a comunidade de engenharia de dados.
O LinkedIn consolidou três sistemas distintos de busca e análise de metadados de métricas em um único índice baseado em ClickHouse, evidenciando uma estratégia robusta para otimização de observabilidade. Atualmente, a plataforma processa mais de 150.000 consultas por minuto sobre 13 bilhões de métricas, mantendo uma latência média de apenas 68 milissegundos por consulta. A migração foi executada de forma transparente, por trás de um gateway já existente, resultando em uma impressionante redução de cerca de um quinto no uso de memória em comparação com a configuração anterior. Este avanço demonstra a capacidade do ClickHouse em lidar com volumes massivos de dados e consultas complexas, reforçando seu papel em arquiteturas de dados escaláveis.
Para atender às demandas de escala extremas, o LinkedIn desenvolveu o Northguard, uma nova arquitetura que desacopla a ordenação, replicação e o posicionamento de dados, aprimorando a eficiência na movimentação e recuperação de informações. Esse projeto surgiu da limitação do modelo de partição do Kafka em contextos de volume massivo. Complementarmente, a plataforma introduziu o Xinfra, uma camada de compatibilidade que isolou os clientes das mudanças de backend, garantindo uma transição fluida e transparente para as aplicações durante a reestruturação da infraestrutura. A iniciativa destaca a viabilidade de reescritas complexas de infraestrutura quando a migração é gerenciada de forma a não impactar os usuários finais.
Gigantes da tecnologia, Microsoft e Google, juntamente com mais de 60 fornecedores de dados e IA, unem forças para apoiar o Apache Ossie. Esta iniciativa visa padronizar o intercâmbio de modelos semânticos através de esquemas JSON/YAML, permitindo que definições de datasets, métricas e relacionamentos sejam portáveis entre diferentes plataformas de Business Intelligence. O objetivo é eliminar a redundância na modelagem semântica e mitigar o "metric drift", garantindo maior consistência e eficiência no ecossistema de dados corporativos.




