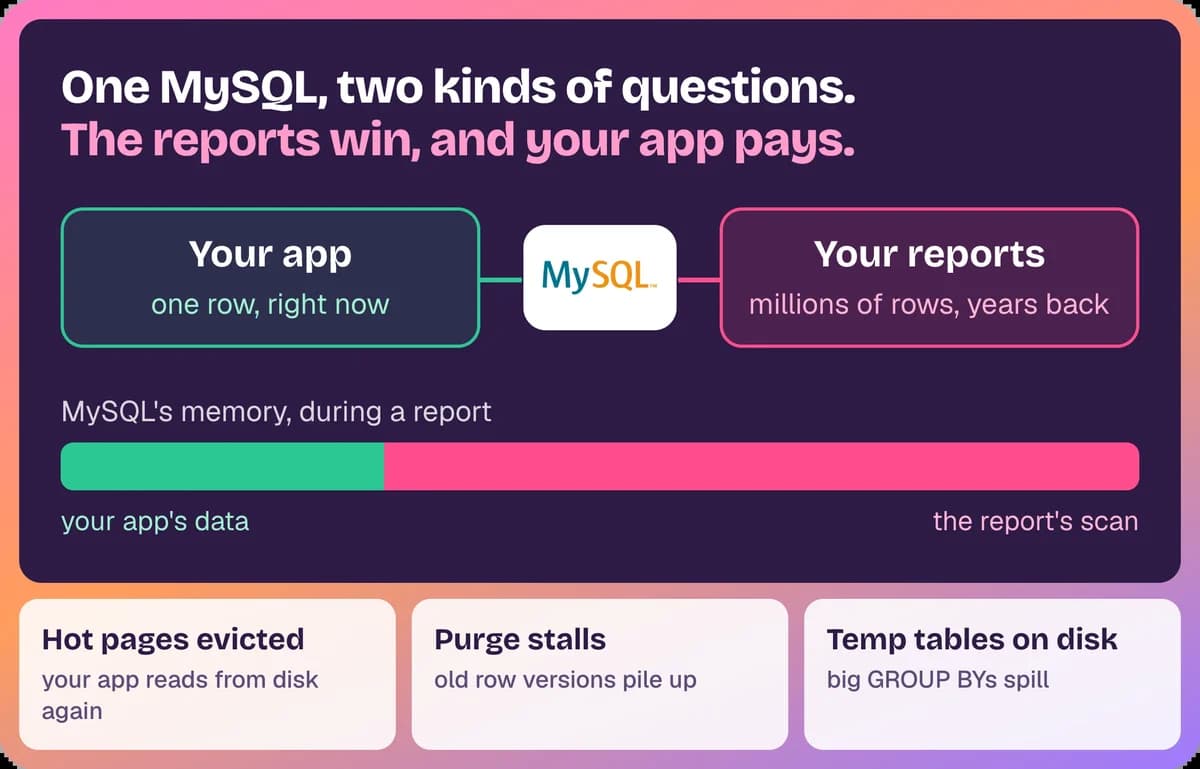
Agregações de string intensivas são frequentemente um gargalo de performance em bancos de dados devido à repetição de operações de hashing e comparação de valores. O DuckDB demonstrou como a substituição de colunas de texto por chaves substitutas inteiras, utilizando tabelas de dimensão, pode otimizar significativamente o agrupamento. Essa técnica não apenas eleva a eficiência do processamento, mas também alivia a pressão sobre a memória e reduz o risco de 'spill' para disco, sublinhando a importância da normalização de strings de baixa cardinalidade em grandes análises de dados onde o desempenho é crucial.
A Cloudflare acaba de lançar o Clef e o Clef-flash, modelos de Sistema 1 de código aberto que, de maneira análoga ao Jev, são capazes de converter entradas de texto ou imagem em decisões e probabilidades. Essa capacidade pode ser aplicada em diversas frentes, como no roteamento automático de tickets de suporte, na classificação de websites e na determinação de quando um agente de IA deve escalar uma consulta para um humano. Ambos os modelos são executáveis via Workers AI ou localmente, e a Cloudflare já oferece suporte para o fine-tuning, permitindo adaptações a tarefas específicas de cada usuário.
O Amazon Aurora PostgreSQL agora revoluciona a interação com Data Lakes ao permitir consultas diretas a tabelas Apache Iceberg e Parquet armazenadas no Amazon S3. Essa funcionalidade dispensa a complexidade de pipelines ETL ou reverse-ETL, otimizando o acesso a dados. Impulsionado pelo engine DuckDB, a novidade suporta a sintaxe padrão do PostgreSQL, com recursos como predicate pushdown e column pruning. Isso garante eficiência na análise de dados operacionais e históricos sem custos adicionais de licenciamento para o Aurora, promovendo uma arquitetura de dados mais ágil e acessível.
A Anthropic revelou os primeiros resultados das modificações implementadas para aprimorar a escrita do Claude Opus 5.5. Dados apontam uma redução de 99,6% no uso excessivo de travessões, além de uma queda de aproximadamente 50% em outros maneirismos estilísticos conhecidos como 'Claudismos', em comparação com a versão Opus 5. A experiência sublinha a importância de uma metodologia de avaliação que se concentra na anotação precisa de trechos problemáticos e na análise de padrões retóricos recorrentes, em detrimento de abordagens baseadas em frases banidas ou métricas vagas. Essa granularidade no feedback é crucial para o refinamento da geração de texto por modelos de IA.
O Splink, biblioteca de código aberto para ligação e deduplicação de registros, avança com a versão 5, permitindo ligação probabilística em tarefas que envolvem bilhões de linhas. Uma demonstração de predição processou 10 bilhões de comparações em 8,5 minutos, utilizando uma instância de 192 v-CPUs e o próximo motor DuckDB 2.0. A nova versão otimiza o treinamento com amostragem em blocos (chunked sampling) e oferece APIs de predição incremental para integrar novos registros sem reprocessamento completo, reforçando sua capacidade para grandes volumes de dados.
A Turbopuffer anunciou que a versão V3 de sua plataforma descontinuará o uso do índice vetorial ANN como sua estrutura de armazenamento primária em bancos de dados vetoriais. Essa mudança estratégica visa aprimorar a eficiência, mitigando a duplicação de dados e evitando reescritas onerosas. A nova abordagem permitirá que funcionalidades cruciais, como busca por texto completo, filtragem avançada, agregações e a própria busca vetorial, operem com configurações de armazenamento e tamanhos de bloco otimizados para suas cargas de trabalho específicas, prometendo maior flexibilidade e performance.
Embora os Query Hints possam resolver problemas de planos de execução no SQL fixando escolhas, essa prática gera uma dependência frágil com índices e a estrutura de dados. Uma alternativa mais robusta e adaptável é gerenciar o controle do plano externamente à query, otimizando as informações disponíveis para o otimizador com ferramentas como gerenciamento de planos e `CREATE STATISTICS`. Essa abordagem permite que o sistema se ajuste dinamicamente às mudanças nos dados, garantindo a resiliência e a performance das operações.
O particionamento de dados (sharding) por ID de inquilino, embora eficaz, pode ser comprometido quando um único "inquilino baleia" sobrecarrega um shard, conforme evidenciado por experiências como a do Slack com seus workspaces empresariais. Estratégias para mitigar este problema incluem o escalonamento vertical, o isolamento desses grandes inquilinos em shards dedicados ou, de forma mais granular, a implementação do sharding em nível de tabela. Ao optar por chaves de sharding específicas para cada tabela, é possível manter os padrões de acesso mais frequentes em um único shard, garantindo maior eficiência e distribuição de carga otimizada.
A Segurança em Nível de Linha (RLS) no PostgreSQL, quando bem implementada, pode ter impacto mínimo na performance, especialmente com verificações de tenant indexadas. Contudo, políticas de RLS mal concebidas podem degradar drasticamente o desempenho de consultas, transformando operações sub-milissegundo em segundos. Armadilhas comuns incluem buscas de associação por linha, o uso de funções auxiliares VOLATILE e funções de consulta não-leakproof, que impedem o otimizador do PostgreSQL de aproveitar plenamente os índices.
A otimização de custos em plataformas de streaming de dados é crucial, indo além do volume de dados processado. Fatores como número de requisições, cópias redundantes de mensagens, serialização e tráfego entre zonas de disponibilidade frequentemente representam as maiores despesas. Para mitigar esses gastos, recomenda-se agrupar produtores e consumidores, eliminar tópicos intermediários, utilizar payloads colunares e compressão. Além disso, a alocação de recursos de baixa latência deve ser estratégica, focada apenas onde a carga de trabalho exige, e o design do estado, junto à visibilidade da atribuição de custos por pipeline, é fundamental para o controle financeiro.
A engenharia de dados atravessa uma transformação fundamental, migrando de ferramentas operadas manualmente para uma infraestrutura otimizada para agentes autônomos. O novo foco não está apenas na geração de SQL ou pipelines, mas em converter com segurança as entregas geradas por IA em resultados de produção confiáveis. A arquitetura proposta engloba cinco camadas essenciais: Intenção, Controle, Semântica, Harness e Runtime. Essa evolução exige que as equipes de dados mudem o foco da criação de scripts e DAGs para o desenvolvimento de Skills reutilizáveis, Políticas robustas e loops de execução contextualmente ricos, garantindo automação fidedigna.
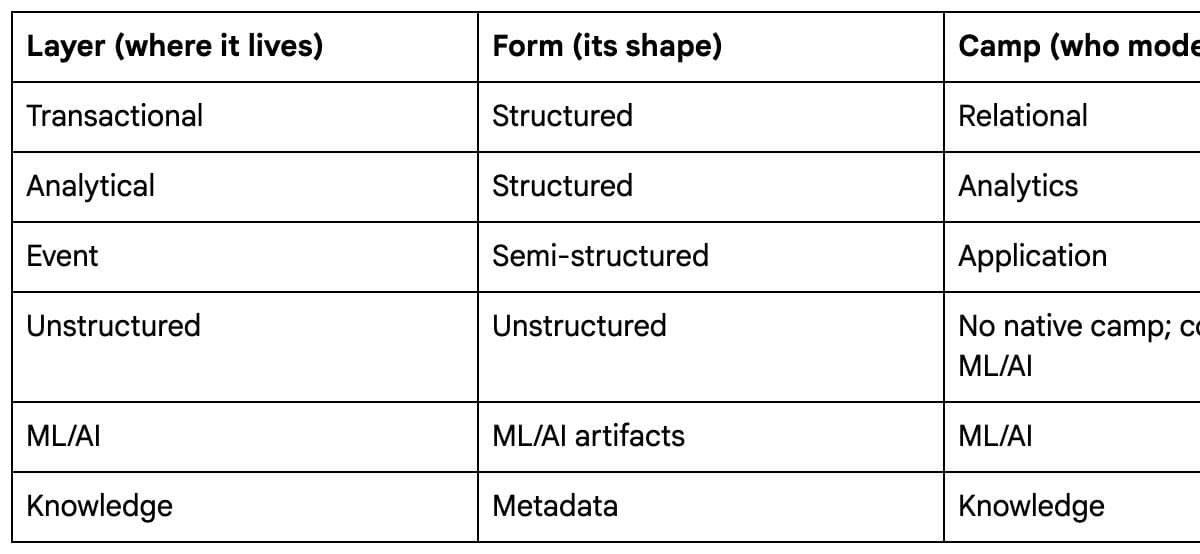
A modelagem de dados contemporânea se divide em cinco vertentes principais: relacional, analítica, de aplicação, para ML/IA e de conhecimento/ontologia. Embora cada uma aborde desafios específicos, todas apresentam limitações que, se ignoradas, podem comprometer a integridade e a confiança dos dados. Um exemplo comum é o uso de JSON para catálogos de produtos, que, ao mesmo tempo em que serve à aplicação, pode prejudicar severamente a capacidade analítica, modelos de IA e a governança, resultando em pipelines frágeis e dashboards inconsistentes. O cenário atual exige que as arquiteturas de dados abranjam e integrem esses cinco campos simultaneamente, tornando a compreensão compartilhada entre as diferentes abordagens de modelagem mais relevante do que a aderência isolada a qualquer tradição específica.
A Omni, após uma rigorosa avaliação comparativa de 16 configurações de modelos de IA da OpenAI e Anthropic, anunciou a escolha do GPT-6 Sol como seu modelo padrão para clientes. O modelo da OpenAI demonstrou notável eficiência e precisão, atingindo um desempenho de 92% em suas análises mais exigentes. Além da alta performance, o custo-benefício foi um fator decisivo, registrando apenas US$0,23 por questão, otimizando as capacidades de analytics da plataforma.
A implementação de uma camada semântica robusta demonstrou ser crucial para aprimorar a precisão de LLMs em tarefas analíticas. Estudos recentes indicam que modelos equipados com essa camada alcançaram uma acurácia de 91%, um salto significativo comparado aos 39% obtidos sem ela. As falhas observadas não estavam na capacidade aritmética dos modelos, mas sim na interpretação de convenções de negócio implícitas, como a definição de clientes. Isso reforça a importância de regras explícitas e validação humana contínua para garantir a eficácia e a confiabilidade das camadas semânticas na era da IA.
O DBTrail acaba de lançar uma solução de réplica analítica de código aberto para bancos de dados MySQL, prometendo otimizar o processamento de dados para análise. A ferramenta atua lendo diretamente o binlog do MySQL, armazenando as tabelas convertidas em arquivos Parquet em um bucket de escolha do usuário. Para consultas e análises subsequentes, a réplica utiliza o DuckDB, viabilizando uma arquitetura eficiente para inteligência de dados.
O DuckDB acaba de lançar a versão 1.5.6, uma atualização focada em manutenção que entrega importantes correções de segurança, eliminando bugs e falhas, além de otimizações de performance. Contudo, as expectativas se voltam para a futura versão 2.0, atualmente em desenvolvimento. Testes internos revelam que esta nova iteração pode alcançar uma velocidade até seis vezes superior à 1.5.6 em cargas de trabalho Windows TPC-H específicas. A equipe, no entanto, adverte que esses ganhos de performance não serão universalmente aplicáveis a todas as operações, indicando otimizações direcionadas.
A OpenAI tem se destacado no cenário de IA não apenas por seus modelos inovadores, mas também pela robustez de sua arquitetura de dados. A empresa centraliza metadados abrangentes para preencher lacunas de contexto, garantindo a integridade e relevância das informações. Além disso, a otimização de seu sistema de orquestração de dados é notável: uma reescrita do Airflow em Rust resultou em uma redução de 35 vezes na latência de agendamento, mesmo diante de mais de 70.000 tarefas executadas simultaneamente. Essa eficiência é crucial para o rápido desenvolvimento e operação de suas soluções de IA.
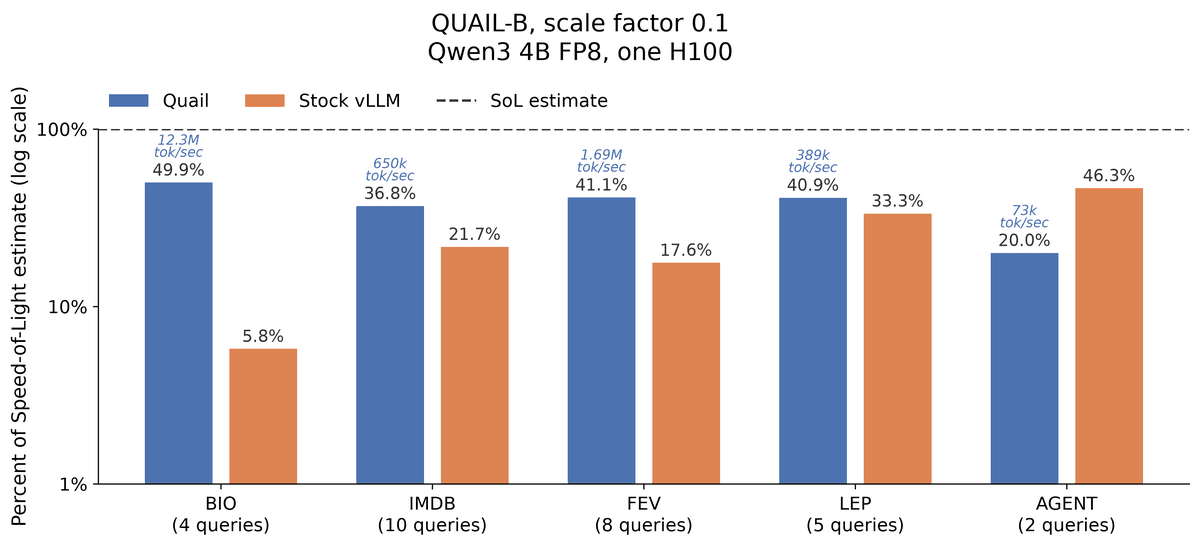
O Quail, um novo motor AI-SQL de código aberto, promete revolucionar o processamento de queries ao integrar otimização de plano de execução com inferência de LLMs. Testes indicam que ele é, em média, 1,84x mais rápido que o vLLM ajustado, alcançando até 14x mais velocidade em cenários específicos. Sua arquitetura inovadora foi projetada para minimizar o desperdício do KV-cache e o overhead de escalonamento da GPU, resultando em operações de filtragem e junções de LLMs em larga escala mais eficientes e econômicas.
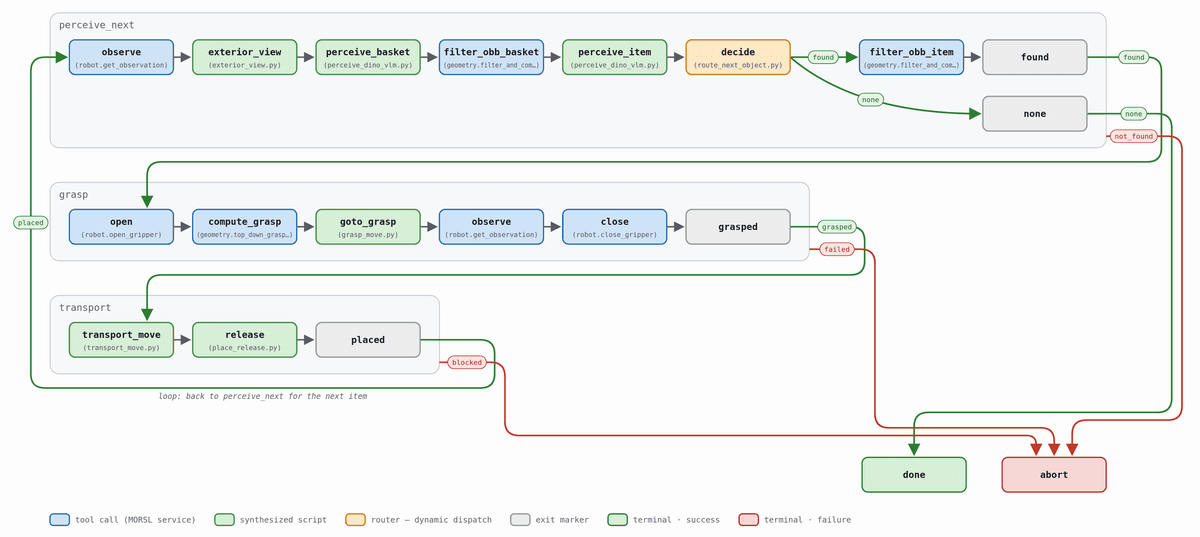
A otimização de robôs da Harness Robotics alcançou um marco significativo ao empregar agentes de codificação para criar um controlador baseado em Graph-as-Policy. Esta inovação resultou em um aumento notável de 5.27x no throughput simulado e elevou a taxa de sucesso de 67% para 96%. A eficácia da abordagem reside na reconfiguração inteligente de habilidades robóticas existentes, sem a necessidade de modificações complexas ou dependência de demonstrações humanas, destacando o potencial da IA na engenharia de sistemas autônomos.
O Pinterest implementou uma camada de finalização robusta em sua pipeline de Change Data Capture (CDC), que é arquitetada sobre Kafka, Flink, Spark e Iceberg. Essa nova funcionalidade permite que processos a jusante identifiquem com precisão quando uma partição de dados horária está apta para consumo seguro. A inovação reside no uso de checkpoints do Flink, que capturam estatísticas de tempo de evento, transformando-as em metadados de snapshot do Iceberg e um watermark não regressivo. Esse mecanismo fornece um sinal claro sobre a completude e frescor dos dados, otimizando a qualidade e a governança sem a necessidade de um serviço de coordenação adicional.