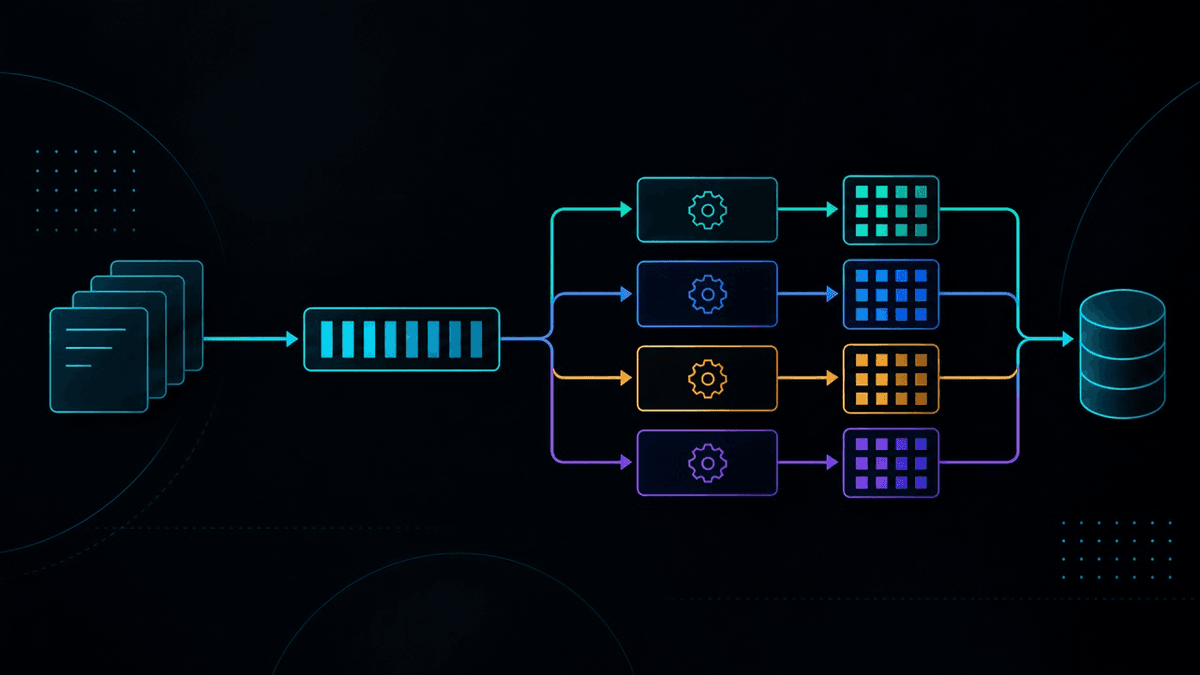
A WHOOP demonstrou um avanço significativo na otimização de suas cargas de trabalho de inferência de IA em batch, reduzindo o tempo de processamento de uma simulação interna de 15,8 milhões de tarefas de mais de dois meses para meros seis dias. A melhoria foi impulsionada pela eliminação de chamadas HTTP por tarefa, carregamento direto do modelo nos workers e ajustes na CPU dos pods. Detalhes técnicos da implementação incluem a resolução de deadlocks em bibliotecas nativas, com a adoção do método 'spawn' para superar problemas de fork do Python, e a garantia de idempotência em retentativas através do encadeamento de estado via SQS e gravações atômicas no S3. Tais estratégias ressaltam a importância de uma arquitetura robusta para o escalonamento de IA.
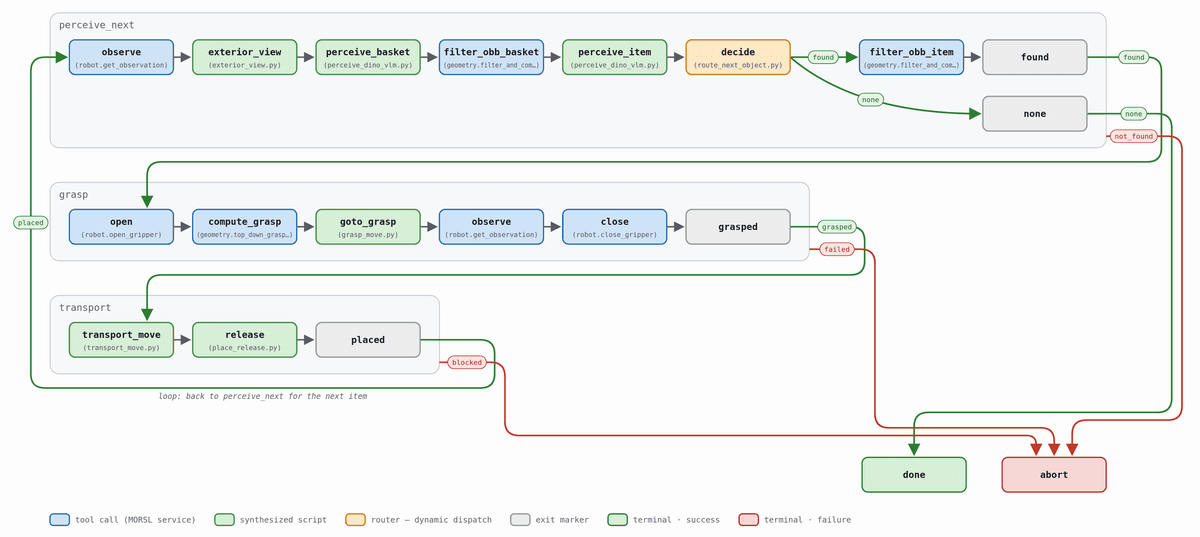
A otimização de robôs da Harness Robotics alcançou um marco significativo ao empregar agentes de codificação para criar um controlador baseado em Graph-as-Policy. Esta inovação resultou em um aumento notável de 5.27x no throughput simulado e elevou a taxa de sucesso de 67% para 96%. A eficácia da abordagem reside na reconfiguração inteligente de habilidades robóticas existentes, sem a necessidade de modificações complexas ou dependência de demonstrações humanas, destacando o potencial da IA na engenharia de sistemas autônomos.
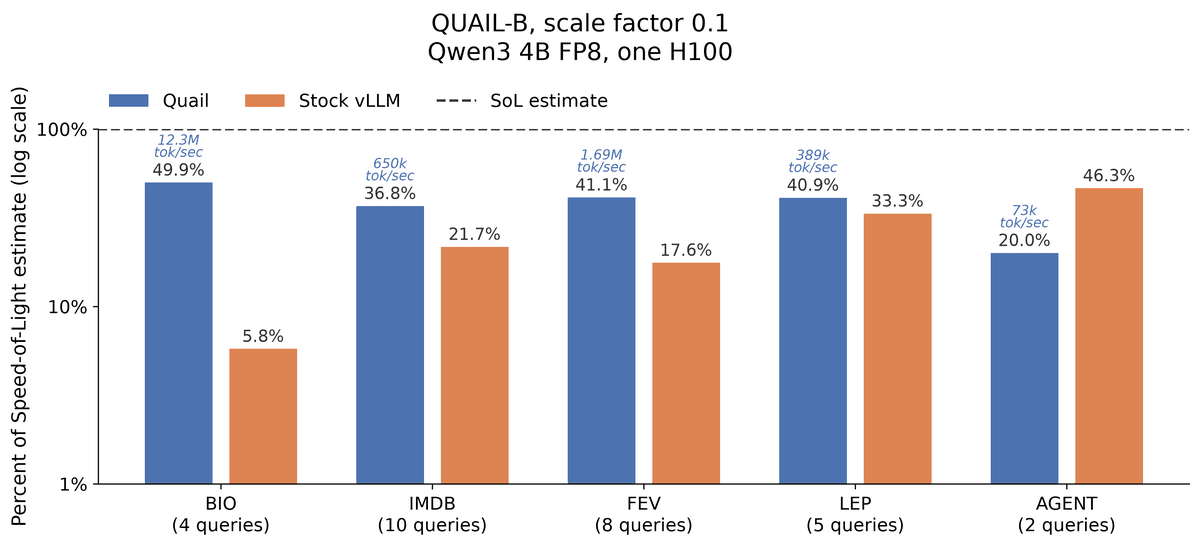
O Quail, um novo motor AI-SQL de código aberto, promete revolucionar o processamento de queries ao integrar otimização de plano de execução com inferência de LLMs. Testes indicam que ele é, em média, 1,84x mais rápido que o vLLM ajustado, alcançando até 14x mais velocidade em cenários específicos. Sua arquitetura inovadora foi projetada para minimizar o desperdício do KV-cache e o overhead de escalonamento da GPU, resultando em operações de filtragem e junções de LLMs em larga escala mais eficientes e econômicas.
Ao longo de dez anos, a replicação lógica do PostgreSQL transformou a movimentação de dados customizada em funcionalidades SQL essenciais. Recursos como filtros de linha, listas de colunas, alvos particionados, aplicação de streaming e paralela, além de prevenção de loops mais robusta, foram incorporados, impactando diretamente padrões de migração e a escalabilidade de arquiteturas hub-and-worker. Esta retrospectiva oferece um checklist valioso para equipes que gerenciam slots de replicação, failover, roteamento de escrita e evolução de esquema, consolidando o Postgres como pilar fundamental em infraestruturas de dados.
A OpenAI tem se destacado no cenário de IA não apenas por seus modelos inovadores, mas também pela robustez de sua arquitetura de dados. A empresa centraliza metadados abrangentes para preencher lacunas de contexto, garantindo a integridade e relevância das informações. Além disso, a otimização de seu sistema de orquestração de dados é notável: uma reescrita do Airflow em Rust resultou em uma redução de 35 vezes na latência de agendamento, mesmo diante de mais de 70.000 tarefas executadas simultaneamente. Essa eficiência é crucial para o rápido desenvolvimento e operação de suas soluções de IA.
O Pinterest implementou uma camada de finalização robusta em sua pipeline de Change Data Capture (CDC), que é arquitetada sobre Kafka, Flink, Spark e Iceberg. Essa nova funcionalidade permite que processos a jusante identifiquem com precisão quando uma partição de dados horária está apta para consumo seguro. A inovação reside no uso de checkpoints do Flink, que capturam estatísticas de tempo de evento, transformando-as em metadados de snapshot do Iceberg e um watermark não regressivo. Esse mecanismo fornece um sinal claro sobre a completude e frescor dos dados, otimizando a qualidade e a governança sem a necessidade de um serviço de coordenação adicional.
A Netflix revelou sua abordagem para a gestão de identidade em jobs Spark, especificamente em ambientes de computação gerenciada. A gigante do streaming detalha a transição de roles de execução da nuvem para uma identidade de workload internamente confiável. Esse processo envolve a verificação de um payload de metadados assinado e uma prova de identidade AWS, culminando na emissão de certificados de curta duração para mTLS. Tal padrão não só desvincula a autorização do provedor de nuvem da confiança da aplicação, como também confere à plataforma uma identidade de workload mais resiliente e limites de acesso mais facilmente auditáveis.
O projeto Apache Fluss anuncia o lançamento da versão 1.0, marcando um avanço significativo para ecossistemas de dados em tempo real. A atualização introduz um gateway HTTP stateless em Rust, otimizado para gerenciar metadados, operações de tabela e escrita em lote. Destacam-se o acesso nativo em Python e a integração aprimorada com plataformas como Flink, Spark, Hudi e Paimon. Novas funcionalidades incluem Time-to-Live (TTL) para linhas e logs, predicate pushdown, alta disponibilidade do coordenador e robustas ferramentas de limpeza e proteção de recursos. Com estas inovações, o Fluss consolida-se como uma solução madura para cargas de trabalho de lakehouse em produção, essencial para aplicações de IA.
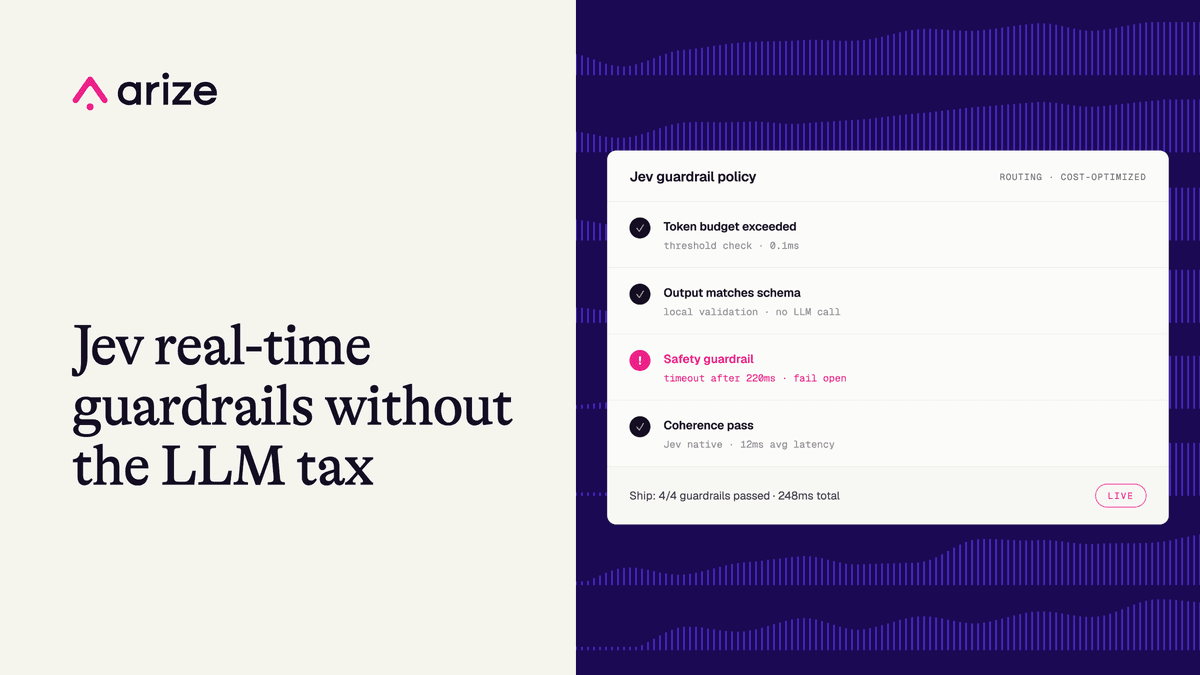
O Jev da TypeSafe apresenta uma solução robusta para guardrails de IA, utilizando um modelo de decisão especializado para validar entradas, respostas e chamadas de ferramentas de Large Language Models (LLMs) antes da execução. A inovação promete maior segurança e controle sobre as operações de IA. Testes realizados pela Arize evidenciaram a eficácia do Jev, que não só replicou as decisões do GPT-5.4 nano, mas também demonstrou um desempenho notável, operando de 15 a 18 vezes mais rápido e com um custo por chamada até 14 vezes menor. Essa otimização de performance e custo é crucial para a escalabilidade e adoção de LLMs em ambientes de produção.
A MotherDuck inova ao introduzir a função `prompt_jev`, possibilitando que usuários de SQL realizem classificação e pontuação de texto em escala analítica. Essa funcionalidade dispensa o treinamento de modelos ou o processamento complexo de respostas de LLMs. Em testes de performance, Jev demonstrou superioridade, alcançando 89% de acurácia em 100.000 linhas em apenas 40 segundos, a um custo de US$ 0,50, superando significativamente a velocidade, o custo e a acurácia de outros LLMs avaliados.
O dbt v2 marca uma evolução significativa ao integrar o DuckDB de forma nativa, eliminando a necessidade de adaptadores externos. Impulsionado pelo motor Fusion, desenvolvido em Rust, a nova versão expande seu alcance com suporte a DuckLake e catálogos Iceberg REST, além de exportar metadados de projetos em formato Parquet. Destaque para a capacidade de análise SQL pré-execução, que identifica incompatibilidades de tipos e colunas, otimizando o fluxo de trabalho e a qualidade dos dados. Projetos existentes podem começar a migração testando o novo parser v2.
A Concurrence tem se destacado na governança de sua IA clínica ao processar anualmente cerca de 1.2 trilhão de tokens de entrada, utilizando a plataforma Databricks. A solução unificada permite à empresa consolidar dados de pacientes, estados de agentes, testes, avaliações e controles de acesso. O Unity Gateway é a peça central dessa arquitetura, viabilizando acesso controlado a modelos e ferramentas de IA aprovados, o que é crucial para rastrear o uso, assegurar a conformidade regulatória e escalar com segurança suas operações de IA, tanto para agentes clínicos quanto de codificação.
O Apache Cassandra 5 representa um avanço significativo, eliminando limitações da versão 3.11. Entre as inovações, destacam-se a indexação de armazenamento anexada, compactação unificada, busca vetorial nativa e agendamento de reparos integrado. Já o Cassandra 6 eleva ainda mais o patamar, introduzindo metadados de cluster ordenados e transações entre partições. Contudo, o particionamento e o design da carga de trabalho permanecem cruciais para a otimização de performance e escalabilidade.
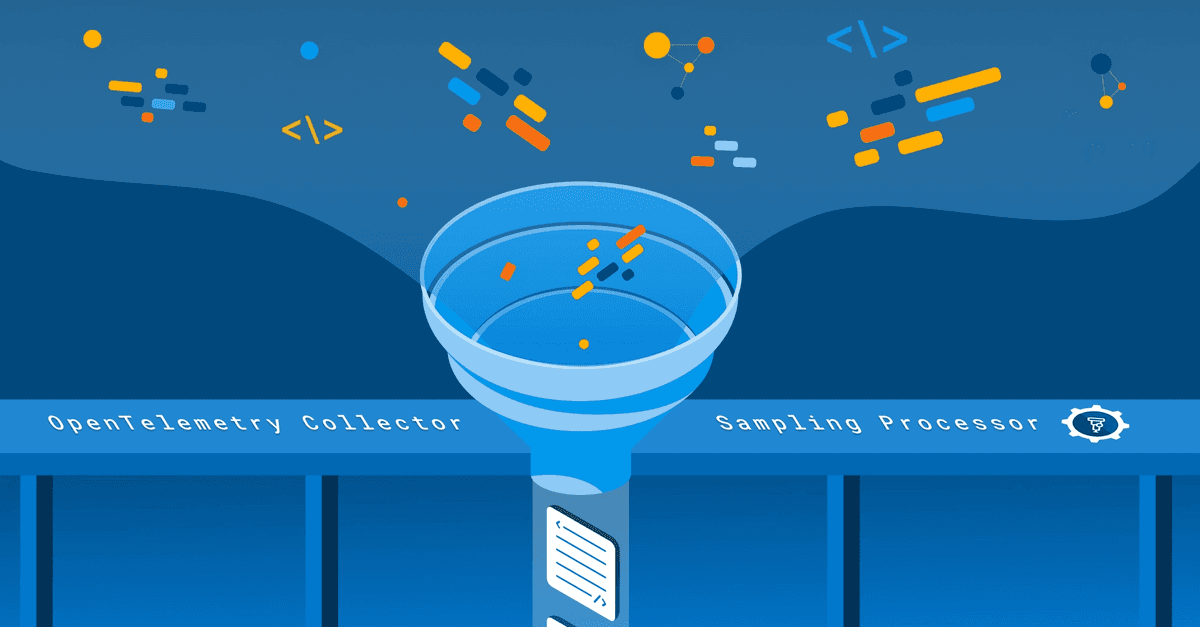
Enquanto a amostragem tradicional de taxa fixa frequentemente falha ao capturar traços críticos durante incidentes e a amostragem de cauda convencional distorce pesos estatísticos, surge uma inovação no OpenTelemetry Collector. O novo sampler de cauda adaptativo armazena traços em buffer, aplicando regras ordenadas e anexando limites de probabilidade W3C, o que permite o rebalanceamento das contagens posteriores. Esta metodologia se ajusta dinamicamente por rota e serviço, otimiza o uso de memória sob alta carga e está progredindo para a fase alpha em seu desenvolvimento.
A Common Crawl, referência em dados abertos da web, liberou os web graphs correspondentes aos meses de julho, agosto e setembro de 2026. Este novo conjunto de dados agrega um volume significativo de informações, compreendendo 245,8 milhões de hosts e 133,2 milhões de domínios. A iniciativa oferece uma base de dados robusta para pesquisadores e analistas explorarem a estrutura da internet e identificarem tendências em escala global.
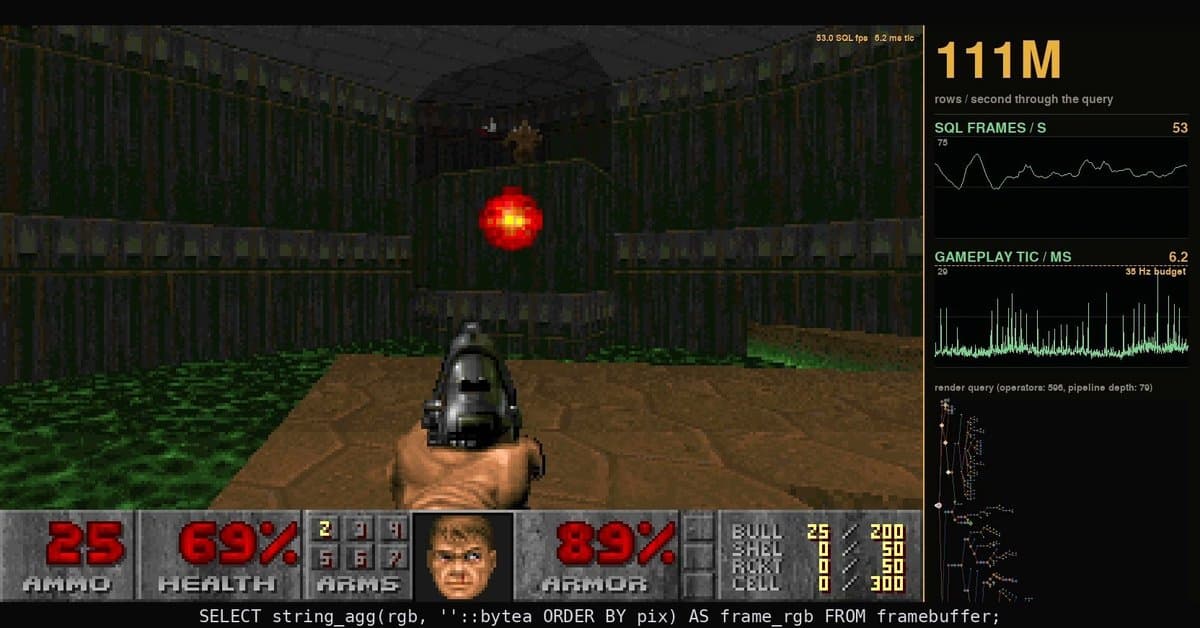
A CedarDB inovou ao portar a lógica e o renderizador do clássico Doom quase inteiramente para SQL. A façanha permite que o jogo execute em seu loop original de 35 Hz, atingindo até 60 FPS. Este experimento audacioso demonstra a capacidade do modelo baseado em conjuntos do SQL de lidar com lógica complexa em tempo real, aproveitando recursos de banco de dados como transações, controle de acesso e estado compartilhado, o que se mostra ideal para a experiência multiplayer inerente ao jogo.
O Polars, aclamada ferramenta de processamento de dados, acaba de integrar um profiler de queries de código aberto para cargas de trabalho locais. Essa novidade permite que engenheiros e analistas de dados otimizem o desempenho de suas operações, identificando gargalos e aprimorando a execução de consultas diretamente em seus ambientes de desenvolvimento. A funcionalidade promete refinar pipelines de dados, garantindo maior eficiência e rapidez no processamento.
Sistemas de Transações Online de Alta Vazão (OLTP) exigem mais do que meros pools de conexão. O TigerBeetle demonstra uma abordagem de codesign, focando na modelagem de transferências atômicas e agregação de saldos sem varreduras. O processamento em lote é automático, e a utilização de identificadores ordenados por tempo prioriza a validação rápida de idempotência. Essa metodologia se mostra mais eficiente que a simples escalabilidade de clientes, sublinhando que a inteligência na arquitetura é chave para desempenho superior em cenários de alta demanda transacional.
Uma auditoria minuciosa da Horizon, que examinou mais de 5.000 tarefas de benchmark de IA em 20 diferentes conjuntos de dados, identificou 29 falhas críticas que comprometem a validade dessas avaliações. Entre os problemas encontrados estão respostas antecipadamente vazadas, testes incompletos, avaliadores suscetíveis à manipulação e soluções de referência equivocadas. Essas deficiências frequentemente resultam na superestimação das capacidades dos modelos de IA, distorcendo a percepção de sua performance real quando os métodos de teste não são rigorosos e confiáveis.
A Cloudflare demonstrou uma engenharia de dados notável ao economizar mais de 100 TB de RAM em seu proxy HTTP, Pingora. A empresa alcançou essa marca por meio de um redesenho inteligente da representação do hash-ring e da otimização da ordenação e implementação do hashing consistente. Em escala global, os pontos virtuais tradicionais para distribuição de carga consomem memória excessiva. A migração foi realizada em fases controladas, minimizando a oscilação do cache e garantindo a capacidade de rollback, um case de sucesso na aplicação de princípios matemáticos para eficiência operacional em infraestrutura de dados.