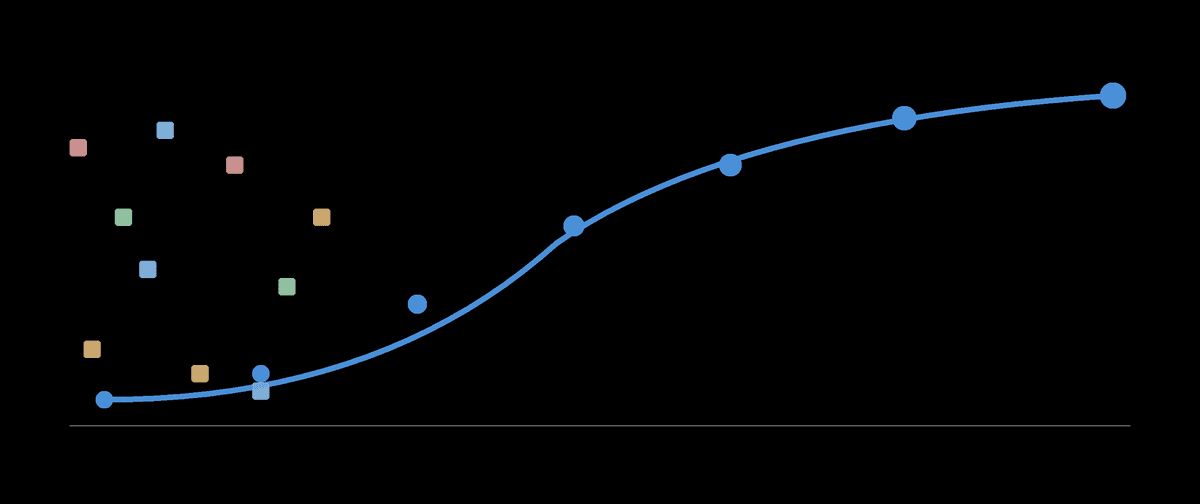
No universo do processamento de dados, os modelos 'System One' atuam como classificadores ágeis e generalistas, executando decisões simples e paralelas sem gerar extensas saídas. Para otimizar seu uso, destacam-se duas estratégias principais: a definição de metas em camadas para tarefas em tempo real, garantindo agilidade e relevância contextual; e a aplicação de comparações em formato de torneio, metodologia que aprimora a seleção da melhor opção a partir de um vasto conjunto de possibilidades, elevando a precisão analítica.
A inclusão de um índice no PostgreSQL, especialmente para cláusulas ORDER BY, pode, surpreendentemente, degradar o desempenho de queries. Isso ocorre quando as linhas relevantes para o filtro estão localizadas muito adiante na estrutura indexada. Para mitigar o problema, é essencial analisar as 'Rows Removed by Filter' e realizar testes com dados representativos. Uma solução eficaz é a criação de índices compostos que abranjam tanto a condição de filtro quanto a de ordenação, garantindo que o otimizador escolha o plano de execução mais eficiente.
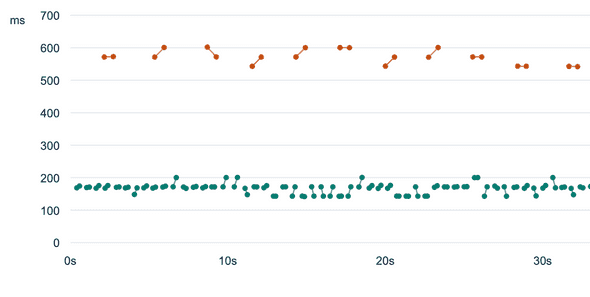
Uma investigação sobre a inconsistência de latência em consultas de hypertable PostgreSQL revelou que a lentidão intermitente ocorria devido à alternância para planos genéricos por parte das instruções preparadas JDBC. Na ausência dos valores de parâmetros, o planejador do PostgreSQL falhava em excluir blocos antigos, resultando em um tempo de planejamento excessivo que se estendia por segundos. A depuração, que incluiu o registro detalhado da fase de vinculação, expôs a raiz do problema. A solução encontrada envolveu a desativação das instruções preparadas do lado do servidor e a redução do número de blocos, restabelecendo a previsibilidade da latência e otimizando a performance do banco de dados.
A ferramenta Jev surge como uma solução para aprimorar a extração de dados estruturados de declarações 10-K, atuando como uma camada de verificação ágil e de baixo custo. Sua funcionalidade principal é validar valores candidatos identificados por outras ferramentas, selecionando o dado correto e atribuindo um nível de confiança calibrado. Este método evita os tradicionais ciclos de geração e parseamento, que frequentemente carecem de confiabilidade, e direciona casos ambíguos para modelos mais robustos ou para intervenção humana, otimizando o processo de engenharia de dados.
Um atributo de *span* com alta cardinalidade pode elevar as séries métricas, mesmo com volumes de *traces* e amostragem estáveis. Embora a amostragem reduza o armazenamento de *traces*, ela não limita as combinações de *labels* distintas geradas pelas métricas de *span* na origem. É crucial gerenciar identificadores em *traces*, agrupá-los antes da agregação de métricas e estabelecer limites de cardinalidade e expiração. Essa prática evita que um único *deployment* transforme uma dimensão temporária em um aumento de custo permanente para a observabilidade.
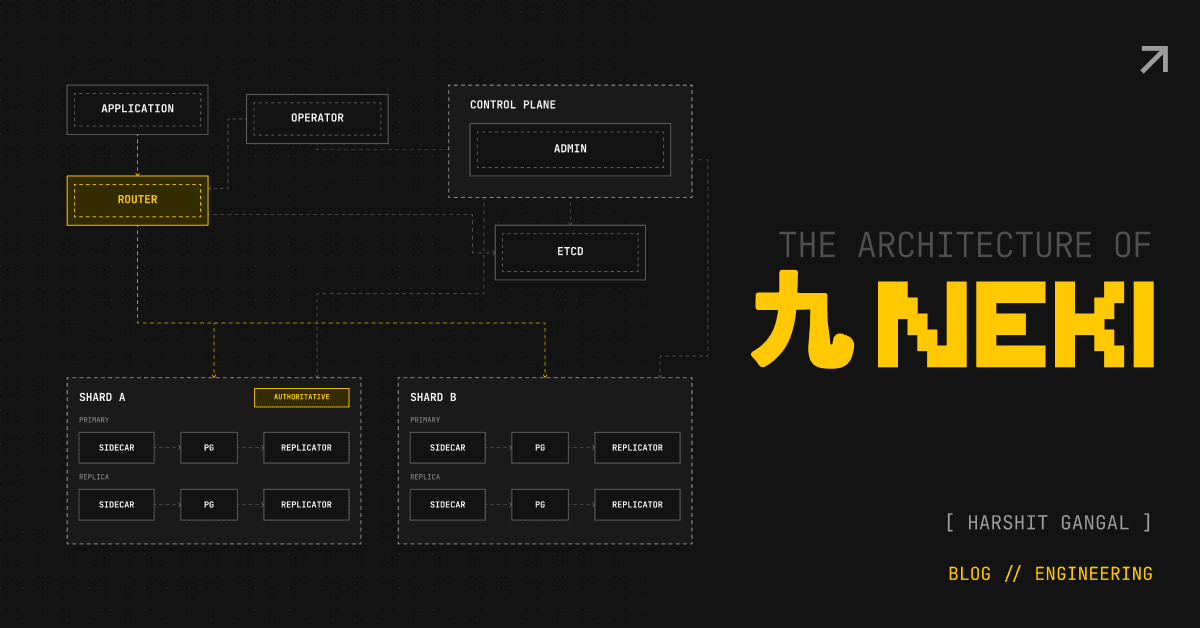
O Neki, solução da PlanetScale, implementa sharding horizontal para PostgreSQL padrão, abstraindo a complexidade de conexões distribuídas para as aplicações. Com roteadores, sidecars, replicação e failover automatizado, o Neki gerencia consultas e assegura alta disponibilidade. A plataforma também se destaca por permitir resharing de dados, movimentação de tabelas e alterações de schema online, minimizando o downtime.
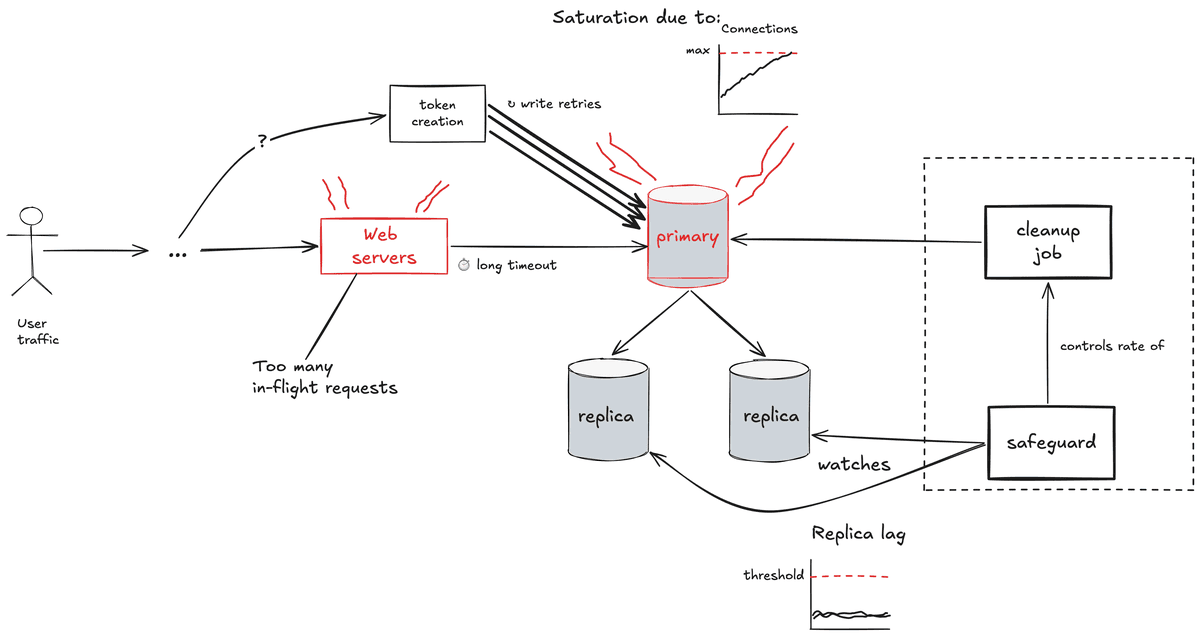
Uma recente interrupção no GitHub demonstrou as complexidades da robustez de sistemas distribuídos. O incidente começou com uma tarefa de limpeza de rotina, que, inesperadamente, saturou um banco de dados primário compartilhado. O ponto crítico foi que os sistemas de monitoramento não refletiram a gravidade da situação, exibindo o cluster como saudável ao focar apenas no atraso das réplicas, em vez da saturação real. A falha foi amplificada por tempos limite de requisição estendidos e múltiplas retentativas, que, em conjunto, transformaram uma questão de saturação de banco de dados em uma interrupção em cascata de larga escala, sublinhando a importância de uma visibilidade completa e estratégias de retentativa bem definidas em arquiteturas de dados.
O Dbt Charts emerge como uma ferramenta open-source inovadora, baseada em YAML, para a criação de dashboards. Sua proposta é permitir que tanto analistas de dados quanto agentes de IA construam visualizações governadas por código, dispensando as interfaces de ferramentas de BI tradicionais. Essa abordagem garante dashboards auditáveis, versionados junto aos modelos dbt e validados proativamente, identificando consultas problemáticas ou visualizações ineficazes antes da implementação. A ferramenta promete maior controle e transparência na geração de insights.
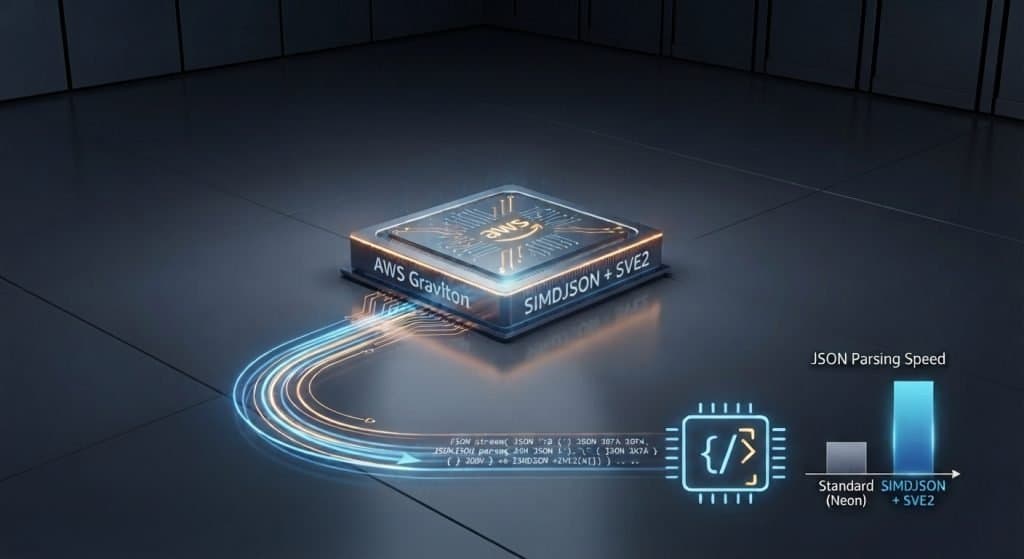
A ingestão de dados em formato JSON, um gargalo frequente em pipelines de dados, acaba de ganhar um impulso significativo. Uma nova implementação da biblioteca simdjson, agora, tira proveito da instrução SVE2 da arquitetura ARM para classificar caracteres estruturais de forma mais eficiente. Testes em processadores Graviton 4 e 5 demonstraram um aumento de 3-9% no throughput de indexação. Embora o ganho total no parser possa ser mais modesto, esta otimização ressalta o impacto de melhorias direcionadas via SIMD, mesmo em sistemas já altamente otimizados para processamento de dados.
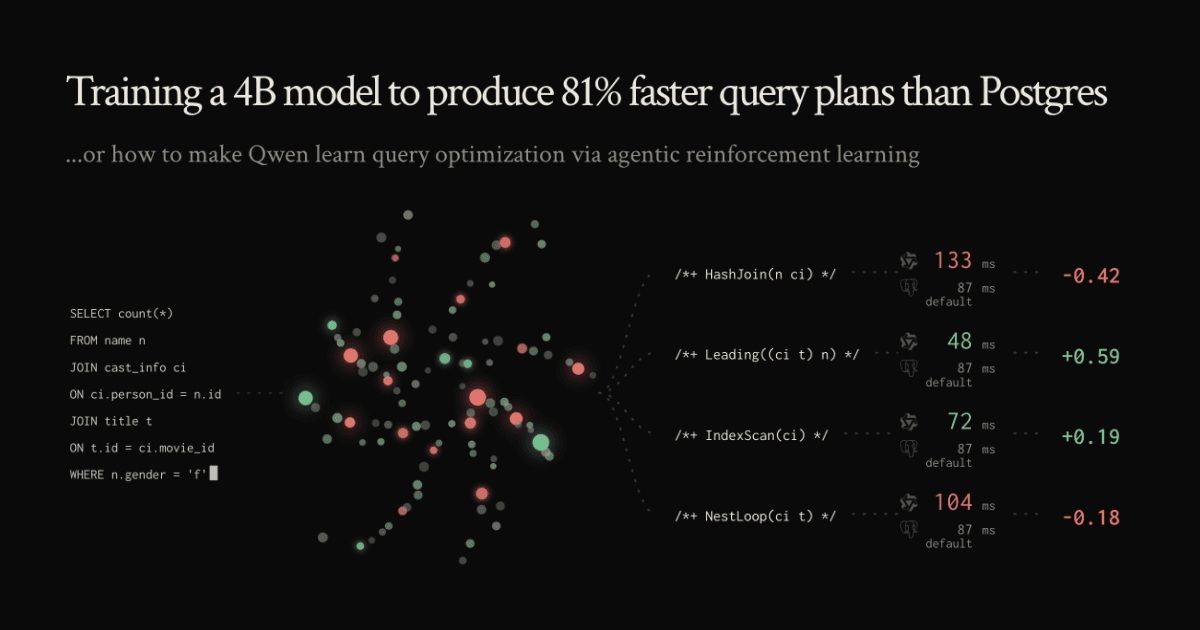
Um modelo Qwen de 4 bilhões de parâmetros, aprimorado com fine-tuning supervisionado e aprendizado por reforço, demonstrou capacidade notável para gerar planos de query PostgreSQL mais eficientes. Testado em 113 queries complexas com múltiplas junções, o modelo obteve um aumento médio de velocidade de 1,81x nos planos otimizados em comparação com as configurações padrão do PostgreSQL, além de uma redução de 44,7% na latência total da carga de trabalho. Este feito ressalta o potencial da IA, mesmo em modelos menores, para aprender e aplicar estratégias avançadas de otimização de banco de dados, utilizando feedback direto do tempo de execução para refinar suas abordagens.
O Redis, conhecido por sua agilidade, pode sofrer gargalos de performance devido à sua arquitetura single-thread. Operações de alto custo como KEYS, FLUSHALL, DEL extensos ou leituras ilimitadas de coleções são notórias por bloquear clientes e gerar picos de latência inesperados, mesmo com CPU e rede aparentemente estáveis. Para diagnosticar esses problemas, ferramentas como SLOWLOG e LATENCY são essenciais. Soluções incluem a substituição de varreduras completas por comandos SCAN baseados em cursor, uso de UNLINK para grandes exclusões, fragmentação de chaves superdimensionadas e a desativação de comandos perigosos em ambientes de produção.
O lançamento do PyIceberg 0.12.0 traz funcionalidades significativas para o ecossistema Apache Iceberg. As melhorias incluem a adição de visualizações de catálogo REST e retries de commit conscientes de conflitos, aprimorando a resiliência e a interoperabilidade. A atualização também introduz varreduras de anexação incrementais e suporte aos tipos de dados de geometria e geografia do Iceberg v3, além do uso inicial da File Format API. Correções de precisão em pruning de partição, deletion vectors, manifests e timestamps, juntamente com a compatibilidade com Python 3.14 e otimizações em CI/CD e segurança, fortalecem sua prontidão para ambientes de produção de Dados.
A migração de centenas de dashboards legados representa um desafio para muitas empresas. Em vez de simplesmente replicar cada um, especialistas em dados sugerem que a prioridade deve ser a portabilidade das métricas, definições e lógicas de negócio subjacentes, que comprovadamente entregam valor. A estratégia é focar em dashboards mais acessados e, para consultas pontuais, utilizar a análise baseada em IA, alimentada pelo mesmo contexto de dados governado, garantindo consistência e eficiência.
Sistemas de busca baseados em IA frequentemente enfrentam o desafio de gerar resultados diversos e úteis sem redundância. A exploração de múltiplas abordagens por modelos de IA é, contudo, um processo lento e custoso. Para contornar esse gargalo, o Google desenvolveu a técnica Retrieve-for-Train, que permite a um modelo menor pré-aprender estratégias de exploração. Isso resulta na produção simultânea de buscas complementares, ampliando a cobertura dos resultados e reduzindo a latência da geração de queries em 12 a 20 vezes, otimizando significativamente a eficiência da busca em IA.
O PostgreSQL 19 chega com uma funcionalidade promissora para o gerenciamento de desempenho de bancos de dados: o `pg_plan_advice`. Esta ferramenta inovadora permite serializar e aplicar guias de plano de execução, detalhando a ordem de junção, tipos de varredura, métodos de junção e estratégias de paralelismo. Com o `pg_stash_advice`, é possível aplicar esses conselhos de forma seletiva por ID de query, garantindo que as otimizações sejam estáveis e reproduzíveis, inclusive em ambientes de CI/CD. Contudo, a atenção deve ser redobrada: a fixação de planos deve ser criteriosa, priorizando decisões comprovadas, pois a dinâmica das distribuições de dados e estatísticas pode impactar o desempenho ao longo do tempo.
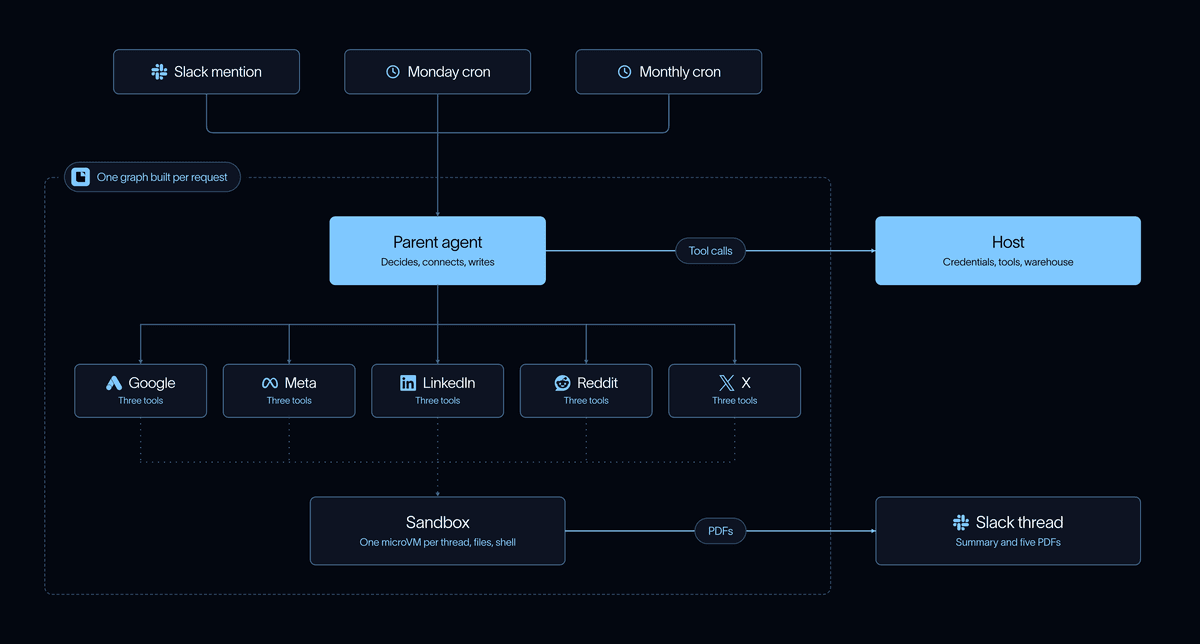
A LangChain desenvolveu um Agente de Mídia Paga inovador, projetado para analisar dados de campanhas, recomendar otimizações e implementar ações aprovadas. A ferramenta visa otimizar o desempenho do marketing digital, impulsionando a mídia paga para representar até 20% do pipeline de marketing e, crucialmente, diminuir o custo por lead qualificado. A arquitetura do agente se baseia na utilização de modelos de IA para decisões estratégicas, código para cálculos precisos e salvaguardas, com aprovação humana essencial para ações de maior impacto, garantindo eficiência e controle.
Antes de adotar um Large Language Model (LLM) para classificação de texto, é crucial avaliar a performance de modelos clássicos, mais ágeis e econômicos, em relação aos dados rotulados, volume e taxa de erro aceitável. Um experimento prático com tickets de suporte demonstrou que a precisão de um modelo TF-IDF pode saltar de 40% para 60% ao aumentar o volume de treinamento de 2 para 10 exemplos por categoria. Contudo, ambiguidades de intenção persistiram, sugerindo que uma estratégia híbrida, onde LLMs apoiam na rotulagem inicial ou casos complexos e modelos clássicos gerenciam as operações rotineiras, pode otimizar a eficiência e a acurácia.
Um fluxo de trabalho inovador, centrado no terminal, promete revolucionar a análise e limpeza de dados. Ao integrar agentes de IA com o DuckDB, essa abordagem oferece um caminho ágil e seguro para o processamento de informações, dispensando a necessidade de ferramentas complexas ou a sobrecarga de camadas semânticas. A combinação resulta em um sistema robusto, capaz de entregar insights rápidos e confiáveis, otimizando a manipulação de grandes volumes de dados diretamente da linha de comando.
A equipe do DuckDB lançou um plugin inovador para o Claude Code, transformando a maneira como a IA interage com arquivos de dados. Anteriormente, o Claude Code dependia de scripts Python e inferência para análise, um processo que agora é otimizado com a integração à CLI do DuckDB. Este aprimoramento permite que o Claude Code trate arquivos locais, remotos e até tabelas Iceberg autenticadas como objetos diretamente consultáveis. O plugin oferece funcionalidades robustas, incluindo conversão de formatos, armazenamento de objetos, manipulação de dados espaciais e busca em documentação, além de recurso de recall de sessão, simplificando drasticamente o processamento e análise de dados.
A Airbnb transformou a análise de conversas de suporte com a criação do Insight Miner. A ferramenta, baseada em um 'agent harness', automatiza fluxos de trabalho de extração, incorporação e clusterização de dados. Além disso, aprimora prompts, identifica casos complexos e facilita a rotulagem contrastiva, resultando na redução de investigações de meses para dias. O sistema também oferece rastreabilidade e suporte a múltiplos idiomas, permitindo que especialistas auditem evidências e se concentrem em hipóteses e melhorias metodológicas.