
Análise da Interrupção no GitHub: Falha em Cascata Revela Falhas de Monitoramento e Retentativas Excessivas
Aprofundamento CEVIU
Aprofundamento
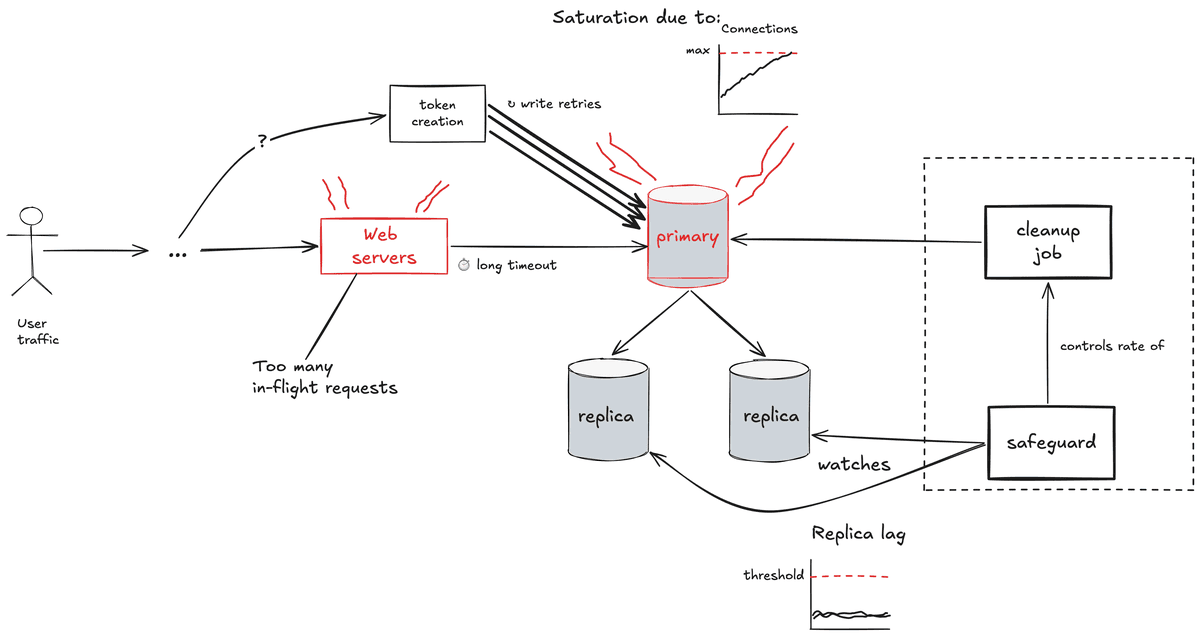
Este incidente ilustra desafios clássicos em gerenciamento de dados e confiabilidade de sistemas distribuídos. Uma tarefa interna de limpeza de dados, que escrevia em um cluster de banco de dados primário compartilhado, saturou o sistema. O ponto crítico foi que o monitoramento do GitHub avaliou a saúde do banco de dados apenas pelo atraso das réplicas, sem considerar a carga crescente no nó primário, que atingiu seu limite de conexões (max_connections). Isso gerou uma "gray failure", onde o sistema parecia saudável, mas estava falhando para os usuários.
A situação piorou com configurações de timeout estendidas e loops de retentativa agressivos de um processo de criação de tokens. Em vez de falhar rapidamente, as requisições ficaram presas, esgotando os recursos dos servidores web. As retentativas incessantes mantiveram o banco de dados saturado, impedindo a recuperação e transformando um problema localizado em uma interrupção generalizada, mostrando como a interação entre componentes pode catalisar falhas em cascata em arquiteturas de dados complexas.
O que mudou
Apesar de cada incidente ter uma causa raiz diferente, notamos uma recorrência nos padrões de amplificação das falhas no GitHub. A cobertura anterior do CEVIU, como a de 19 de agosto de 2026, já apontava problemas com "efeito cascata de retries" em incidentes de autoscaling. Agora, vemos a mesma dinâmica, mas em um cenário de saturação de banco de dados. Isso indica que, embora as vulnerabilidades iniciais mudem (de autoscaling a jobs de limpeza), a forma como os sistemas do GitHub respondem a essas pressões (timeouts longos, retentativas excessivas e monitoramento incompleto) continua a ser um desafio persistente em suas arquiteturas de dados.
Por que isso importa
Este incidente é um lembrete vívido da importância de uma observabilidade completa e de estratégias robustas em engenharia de confiabilidade. Para equipes de dados, engenharia e analytics, a lição é dupla: garantir que os pipelines de dados, mesmo os de limpeza, não sobrecarreguem sistemas críticos, e que os sistemas de monitoramento capturem a saúde real dos componentes, não apenas métricas secundárias. A falha ressalta que "gray failures" são um risco sério em ambientes distribuídos, onde métricas aparentemente boas escondem problemas graves.
Reforça também que timeouts e retentativas, embora essenciais, precisam ser calibrados para evitar "retry storms" e saturação de recursos, um desafio contínuo na construção de sistemas escaláveis e resilientes.
Linha do tempo
GitHub Aborda as Recentes Indisponibilidades e Detalha Plano de Recuperação
GitHub Actions Enfrenta Falha Histórica e Expõe Limites de Escalabilidade
GitHub.com Enfrenta Interrupções Devido a Falha de Configuração e Efeito Cascata de Retries
GitHub.com Enfrenta Incidente de Quase Oito Horas com Múltiplos Serviços Afetados
GitHub e a Complexidade do Autoscaling: Lições de uma Interrupção Recente
Análise da Interrupção no GitHub: Falha em Cascata Revela Falhas de Monitoramento e Retentativas Excessivas
Perguntas frequentes
O que é uma "gray failure"?
Uma "gray failure" acontece quando os sistemas internos de monitoramento de uma plataforma indicam que tudo está funcionando normalmente, mas, na realidade, os usuários estão enfrentando problemas. O monitoramento não capta a condição real de falha, levando a uma falsa sensação de segurança operacional.
Como a saturação do banco de dados levou à falha em cascata no GitHub?
Um job de limpeza sobrecarregou o banco de dados primário, que esgotou suas conexões. Timouts longos fizeram com que requisições presas consumissem recursos de servidores web, enquanto retentativas constantes de um serviço de criação de tokens mantiveram o banco saturado, impedindo a recuperação e espalhando a falha.
Qual o papel do monitoramento inadequado neste incidente?
O monitoramento focou apenas no atraso das réplicas do banco de dados, que permanecia baixo. Ele não detectou a saturação do nó primário, dando uma visão distorcida da saúde do sistema. Isso impediu uma detecção precoce do problema real, agravando a situação.
Por que as retentativas (retries) podem agravar uma interrupção?
Retentativas são úteis para falhas transitórias. Contudo, em situações de saturação ou falha persistente, elas podem sobrecarregar ainda mais um sistema já em dificuldade, criando um "retry storm" que impede a recuperação e amplifica o impacto da interrupção.
Fontes
- surfingcomplexity.blogfonte original
- Categoria
- CEVIU Dados
- Publicado
- 21 de setembro de 2026
- Editoria
- CEVIU Dados