Segundo a nota dos autores, este é o segundo ensaio da série sobre a próxima economia, parte de uma nova plataforma que hospeda vozes independentes para explorar um futuro com AGI. O texto reflete as visões dos autores, não as da OpenAI ou de seus colegas. Os dois autores tinham 24 anos quando começaram a gerenciar suas próprias equipes na OpenAI. Eles descrevem que, ao entrar no mercado de trabalho, já contam com "funcionários" de IA que trabalham dia e noite, inclusive em fins de semana e feriados, e que são bons no trabalho braçal. Esses subordinados ainda cometem erros, mas estão melhorando, e os autores dizem estar aprendendo a gerenciá-los. Para eles, a gestão desceu até o seu degrau na hierarquia. O ensaio apresenta três cenários ilustrativos sobre onde a IA se encaixa na firma. No primeiro, abaixo de nós, cada pessoa mantém seu cargo e passa a gerenciar uma camada de trabalho de IA, de assistentes a miniempresas inteiras que respondem a cada indivíduo. No segundo, ao lado de nós, a IA entra no organograma como uma espécie de colega, trabalhando diretamente para gestores e executivos humanos e assumindo funções cada vez mais amplas. No terceiro, entre nós, a IA fica entre humanos acima e abaixo, coordenando e monitorando o trabalho, aplicando a visão de um executivo e reconhecendo as contribuições de cada trabalhador. Os autores afirmam que nenhum cenário se concretizará exatamente como descrito, mas acreditam que aspectos dos três se realizarão, e que todos já ocorrem de forma sutil. O foco não é a automação total, e sim uma economia em transição e como serão as firmas híbridas à medida que a IA melhora e se integra às organizações. Na visão deles, IA mais capaz é mais adotável: as firmas precisam aprender as tecnologias, mas a mão de obra aprende a firma e consegue se integrar sozinha. O ensaio analisa o que as três novas classes de organograma significam para a burocracia, a autonomia dos trabalhadores, o tamanho das firmas e a disparidade salarial. No primeiro cenário, o organograma humano permanece igual, mas ganha um porão de agentes de IA abaixo de cada colaborador. No início, são um ou dois agentes por pessoa, mais como estagiários ansiosos que precisam de supervisão. Conforme os modelos melhoram, os agentes assumem mais tarefas com menos supervisão e passam a se coordenar entre si.
CEVIU IA
Lançamentos, inovações e pesquisas para profissionais de IA, machine learning e ciência de dados
2925 notícias
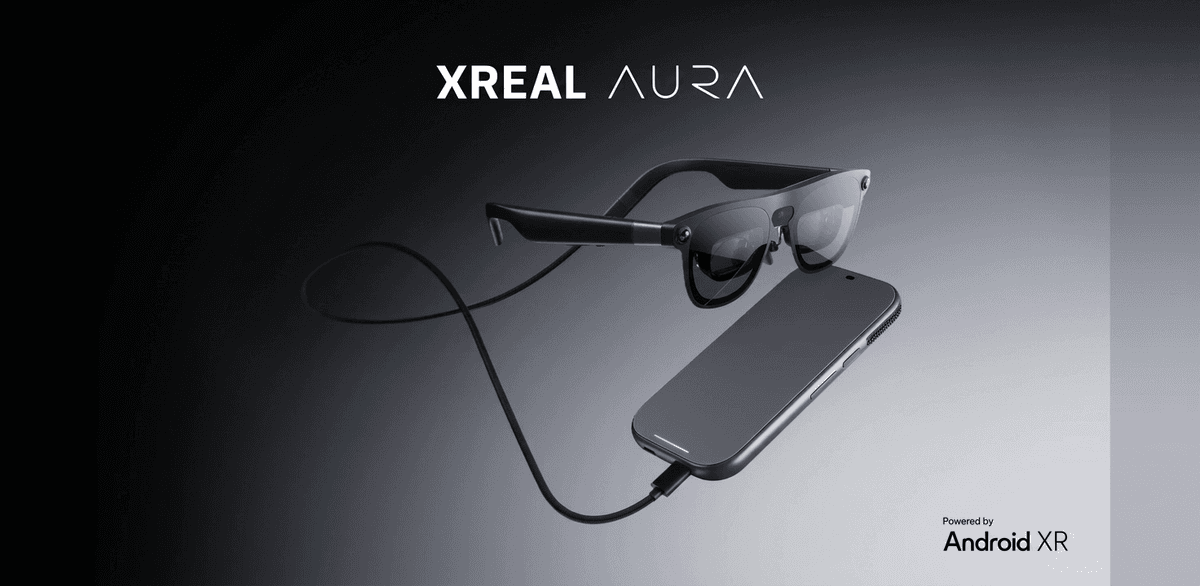
O Google afirma que hoje marca o lançamento do XREAL AURA, um conjunto inédito de óculos XR com fio construído sobre o Android XR, sistema operacional com IA que combina informações digitais ao mundo real. Segundo o texto, o Android XR já está disponível em headsets e chegará em breve aos óculos. O dispositivo usa arquitetura split-compute para spatial computing, tem display optical see-through com campo de visão de 70 graus e armação com menos de 95 g. Há suporte nativo a apps corporativos da Google Play Store, e a entrada DisplayPort (DP-in) permite conectar laptops de diferentes plataformas e levar seus aplicativos ao ambiente espacial. A gestão usa o framework Android Enterprise, com Managed Google Play, Android zero-touch enrollment e modo de dispositivo totalmente gerenciado. Na segurança, entram o Google Play Protect contra malware, phishing e ransomware, a segurança da plataforma Android e o Device Trust. Entre os casos de uso citados estão monitores virtuais, assistência remota de especialistas na manutenção de equipamentos, visualização de informações complexas sobre espaços físicos, design e simulação de produtos em 3D e uso de voz para levar dados do mundo físico a sistemas de registro.
O Google DeepMind anunciou o Gemini 4 Carbon, descrito pela empresa como seu modelo mais forte, com capacidades de cibersegurança e de long horizon no estado da arte. Segundo a empresa, o Carbon ocupa o 1º lugar na versão v5.0 do Artificial Analysis Intelligence Index, com 59 pontos. O modelo traz ganhos em coding e tarefas agentic, além de resultados relevantes para defesa em cibersegurança: 88,2% no SEC-bench Pro (busca de vulnerabilidades), 54,8% no ExploitGym (exploração) e 71,0% no CWE-bench (correção). Em benchmarks internos, o Carbon gera código seguro com mais de 2x de aumento na taxa de sucesso em relação ao Gemini 4 Argon, lançado duas semanas antes, e apresenta menores taxas de misalignment e fabricação em ambientes de coding ao vivo com as equipes da empresa. No WebDev Arena, subiu 89 pontos de Elo e chegou ao 4º lugar (1769). O rollout será gradual. A empresa participa do processo voluntário do governo dos EUA para testes pré-lançamento e, a partir desta semana, disponibiliza o Carbon a um grupo restrito de cyber defenders, ampliando depois o acesso a parceiros de confiança pelo Fairwind Program. O acesso para desenvolvedores, empresas e consumidores nas superfícies de produto virá assim que possível, após ajustes nos guardrails. O preço de lançamento será o mesmo introdutório do Argon: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com tokens de entrada em cache 95% mais baratos. Segundo o Google DeepMind, o modelo foi projetado para problemas de engenharia de longo horizonte e fluxos agentic prolongados, e internamente chegou a rodar por dias em tarefas como encontrar a causa raiz e corrigir bugs sutis em grandes codebases e sistemas de baixo nível. A empresa cita ainda que o time do Chrome observou desempenho mais de 10X melhor que o de outro modelo frontier de outro laboratório na geração de patches de alta qualidade, e que a Wiz viu o Carbon liderar benchmarks de web penetration testing. O Carbon usa o mesmo stack de segurança em camadas do Argon, que combina treinamento do modelo, defesas contra uso indevido em tempo real, resiliência a prompt injection e monitoramento de chain-of-thought, com foco adicional em alignment.
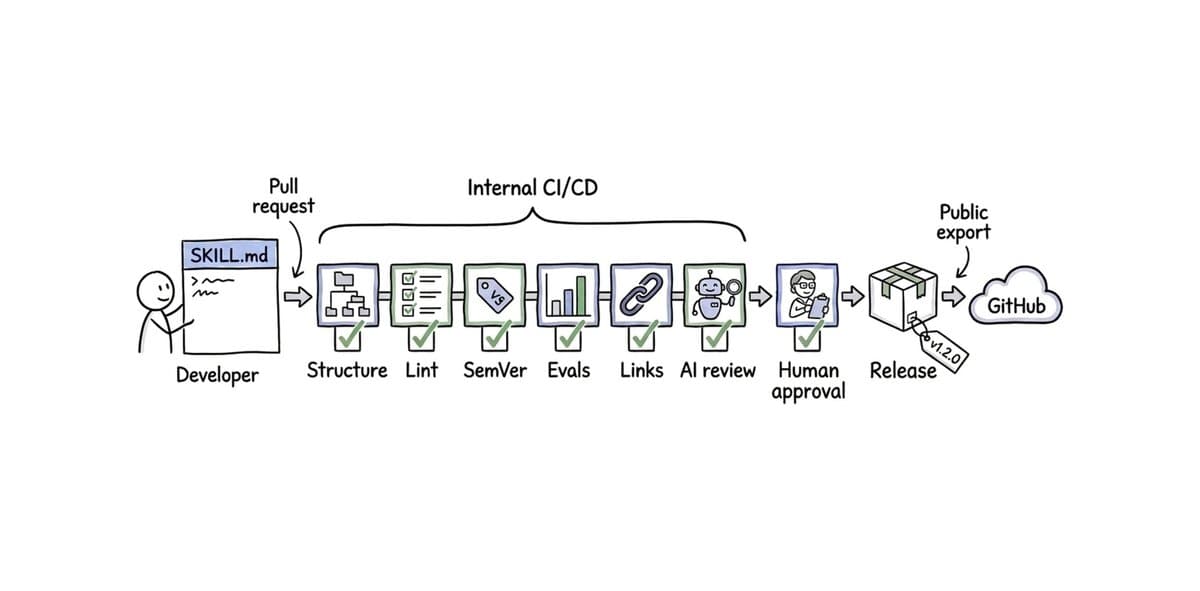
Em continuação ao post anterior sobre os bastidores do Google Agent Skills (origem do projeto, qualidade em escala e governança), o Lead Developer Relations Engineer descreve o que foi construído desde então: os quality gates automatizados que toda mudança precisa passar, o agente de IA de revisão que inspeciona a qualidade das skills e as lições aprendidas. Segundo o autor, é possível adotar gates e regras de revisão semelhantes em repositórios de skills próprios. Desde o último post, o repositório passou de 15 mil para mais de 21 mil estrelas no GitHub e reúne mais de 170 skills de times do Google, distribuídas em várias plataformas de IA. Para um desenvolvedor individual, criar uma skill é simples: basta escrever um SKILL.md, definir instruções e testar manualmente. Em escala, esse fluxo deixa de funcionar, já que edições sem validação podem introduzir bugs sutis. A filosofia central é tratar a skill como produto vivo, não como documentação. Ela orienta o loop de raciocínio, a escolha de ferramentas e o caminho de execução do agente, e uma frase mal posicionada pode gerar flags de comando inválidas, loops infinitos ou desperdício de tokens. Por isso, toda edição de instrução é uma mudança de comportamento. Daí vêm três requisitos: semantic versioning estrito, com bump de versão a cada mudança comportamental; validação determinística automatizada por linters e validadores antes da revisão humana ou por IA; e evidência de avaliação obrigatória, com relatório que compara a skill com a versão anterior ou, se for nova, com um agente sem a skill. Ao enviar uma mudança ao repositório interno, um pipeline de CI/CD é acionado. Antes da exportação para o GitHub, a skill precisa passar por seis gates automatizados e receber aprovação humana de um especialista: conformidade estrutural (layout de diretórios, arquivos permitidos e taxonomia), linters (frontmatter, nomes de pastas e regras de Markdown), semantic versioning, suíte de avaliação válida com relatório atualizado, validação de links e o agente de IA de revisão, que verifica padrões de qualidade e design. As regras incluem: nome da pasta igual ao nome nos metadados, limites de tamanho para SKILL.md e descrição, campos obrigatórios do frontmatter, lista restrita de arquivos e diretórios permitidos, formatação de Markdown e README.md e index.json atualizados. Cada skill declara uma versão semântica no frontmatter do SKILL.md, e as verificações confirmam que ela seja uma string entre aspas, pois o YAML interpreta valores sem aspas, como 2.0, como números, causando erros de parsing.
A Microsoft afirma que, para competir, é preciso ser multi-model e ter um bom harness, mas que construir um que funcione bem entre vários modelos e superfícies é difícil: é preciso equilibrar desempenho, qualidade e custo, e ainda mantê-lo. Segundo a empresa, a engenharia do GitHub desenvolveu um harness multi-model, adotado em toda a Microsoft. O Microsoft Copilot harness alimenta Copilot Code, Copilot Studio, o app GitHub Copilot, a CLI, o VS Code e outros produtos. Agora ele passa a ser oferecido pelo Microsoft Foundry, de forma totalmente gerenciada, para construir agentes que raciocinam, usam ferramentas e executam tarefas complexas e de longa duração, sem trocar o harness nem o restante da stack ao mudar de modelo. O texto define o harness como tudo o que existe em torno do modelo: a camada de orquestração que entrega ao agente instruções, contexto, ambiente de execução e controles. Ele suporta padrões abertos como MCP, agent skills e agent plugins. Segundo a Microsoft, foi projetado para ser rápido, eficiente em tokens e previsível, e funciona com mais de 20 frontier models, além de bring your own key, roteando o trabalho para o modelo mais adequado a cada tarefa. A empresa diz ter portado o runtime para Rust, o que reduziu o overhead de sessão e o time-to-first token, e afirma que o harness opera em escala de milhões de usuários e centenas de casos de uso reais. O SDK está disponível para download, ou o harness pode rodar na nuvem, gerenciado pelo Foundry. Nesse modelo, a Microsoft executa o agent loop e o sandbox, com governança e otimização embutidas, enquanto o cliente define instruções, skills, ferramentas e a escolha do modelo. A plataforma segue aberta e interoperável, permitindo usar outros harnesses e frameworks.
A Meta detalhou, em post de engenharia, a próxima geração do Andromeda, mecanismo de retrieval de anúncios personalizados, e como o co-design entre modelo, sistema e hardware de GPU amplia a eficiência dessa etapa. Em produção, o sistema atribui score a todos os anúncios elegíveis com desempenho de modelo próximo ao do ranking, na escala do retrieval, e seleciona os melhores candidatos a mais de um bilhão de anúncios por segundo. Segundo o post, é um novo benchmark de throughput para modelos de retrieval, com ganho de 100x sobre o Andromeda de 2024. Para os anunciantes, o desempenho melhora automaticamente: o sistema combina anúncios em um pool maior de candidatos dentro do mesmo orçamento de latência. Desde 2025, o Andromeda entregou aumento de 2,4% nas conversões no Facebook. O retrieval é a primeira etapa do pipeline de recomendação de anúncios: reduz, em milissegundos, um enorme conjunto de anúncios elegíveis a um pequeno grupo de bons candidatos, que o ranking, mais custoso, avalia em detalhe. Historicamente, a modelagem profunda do ranking era cara demais para a escala do retrieval. Partindo da base do lançamento de 2024 no NVIDIA GH200 Grace Hopper Superchip, o post mostra como o co-design leva desempenho próximo ao do ranking a essa escala. O deployment de 2024 reimplementou o retrieval de ponta a ponta, com hardware de IA customizado, indexação hierárquica e operadores nativos de GPU para um modelo sob medida, ampliando a capacidade do modelo em quatro ordens de grandeza. Desde então, ferramentas de IA generativa para criativos ajudaram anunciantes a criar centenas de milhões de novos anúncios, elevando o pool de candidatos a uma escala sem precedentes. Avaliá-lo com um modelo mais preciso e throughput muito maior exige avanços conjuntos em modelo, arquitetura de sistema e uso de hardware. Como o retrieval tem ROI desproporcional sobre ganhos de qualidade, pequenas melhorias no modelo podem gerar grandes ganhos de valor para o anunciante. Manter essa evolução com custo de compute sustentável exige ir além da arquitetura de rede neural profunda otimizada para GPU de 2024, ampliando o desempenho sem aumento proporcional de custos. O sistema de 2024 avalia dezenas de milhões de anúncios por segundo por GPU; a nova demanda é de bilhões por segundo por placa. Nessa escala, a largura de banda de memória ao movimentar tensores de anúncios pela hierarquia de memória vira o gargalo. Tensores intermediários entre kernels de GPU respondem por terabytes por segundo de tráfego de memória, e o envio de anúncios entre hosts de CPU locais e aceleradores remotos satura o link de rede. Isso pede um co-design de sistema que unifique essas cargas fragmentadas e distribuídas em um único pipeline de GPU. Por fim, o post trata de levar cada componente do pipeline aos limites da geração atual de hardware.

NVIDIA lança Nemotron 3.5 Transcribe e Granary v2 para transcrição multilíngue controlada por prompt
A NVIDIA apresentou o Nemotron 3.5 Transcribe, modelo open-weight controlado por prompt que converte fala gravada em texto, já disponível no Hugging Face e no ModelScope. Em um único checkpoint, reúne transcrição, atribuição de falantes (diarization), tradução e perguntas e respostas sobre áudio: transcreve 40 idiomas, traduz 31 deles de ou para o inglês e atribui falantes em 13. Processa gravações de até uma hora e identifica até oito falantes. Os desenvolvedores podem guiar a saída com linguagem natural, escolher onde o áudio é processado e adaptar o reconhecimento a vocabulário de domínio e sotaques. O modelo roda em uma única GPU NVIDIA, do DGX Spark a sistemas de data center Blackwell. Segundo a NVIDIA, o modelo é o primeiro entre os open-weight no Open ASR Leaderboard do Hugging Face em inglês, com WER médio de 5,33%, e aparece na fronteira de acurácia por parâmetros ativos da Artificial Analysis. Em atribuição de falantes, registra a menor taxa de erro no leaderboard de diarization em 21 idiomas da David AI e ocupa o primeiro lugar na comparação de 14 sistemas do VoiceArena. No multilíngue, o WER médio é de 4,62% em sete idiomas. O Granary v2 traz dados multilíngues, disponíveis no Hugging Face e no ModelScope, e um pipeline de curadoria reutilizável. Com as ferramentas de fine-tuning do NeMo Speech, estende o controle por prompt ao treinamento. Em um estudo de caso médico, o fine-tuning reduziu em 45,8% o WER em falantes não vistos no treino, em relação ao melhor prompt. O suporte a idiomas varia por tarefa, e as perguntas e respostas sobre áudio são treinadas em inglês. O modelo também gera timestamps por palavra. A NVIDIA recomenda conferir nomes, trocas de falante e respostas com a gravação.
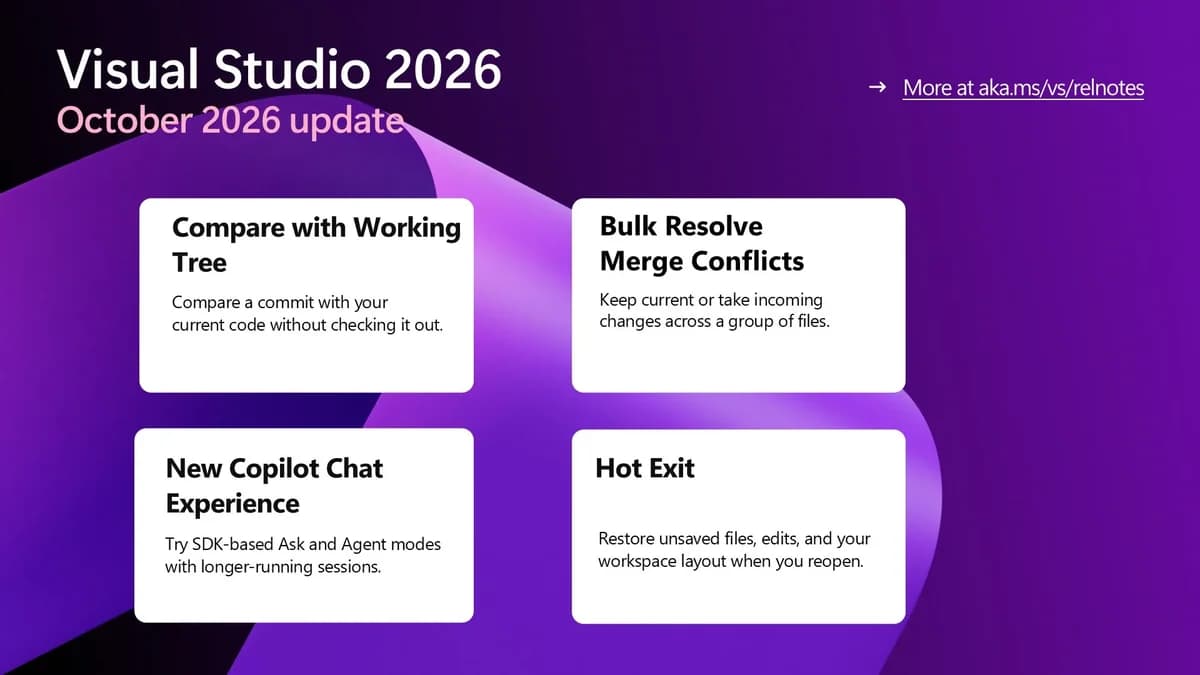
A atualização de outubro do Visual Studio já está disponível e inclui a comparação direta de commits com o código do desenvolvedor. A versão também traz uma nova experiência do Copilot Chat, voltada a melhorar fluxos de trabalho com agentes, e a opção de Hot Exit, que preserva trabalho não salvo.
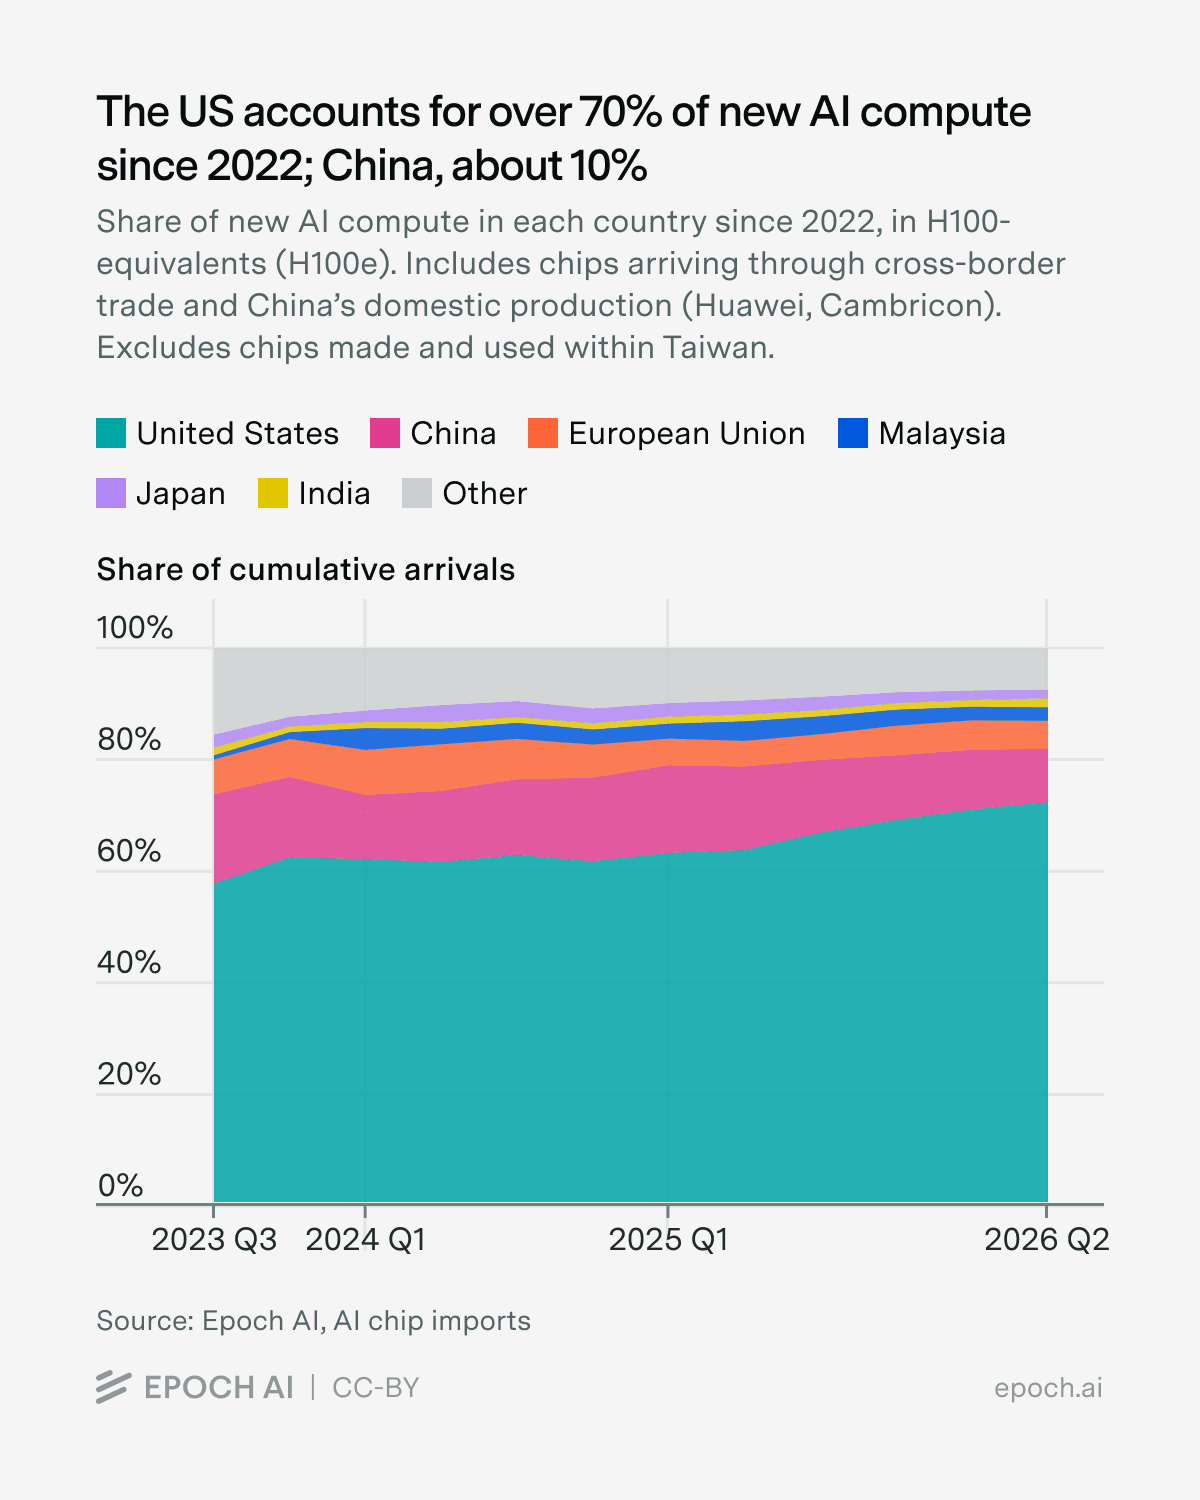
O AI Chip Imports explorer estima a chegada de compute de IA por país desde 2022 e amplia o mapeamento da cadeia de suprimentos global de chips de IA. A ferramenta complementa os dados já existentes sobre componentes de chips de IA, vendas e data centers. Juntos, esses recursos dão uma visão detalhada de como o compute de IA é alocado e controlado no mundo.
O Gemini Robotics Embodied Reasoning 2 já está disponível no Google Cloud. O modelo reúne raciocínio espaço-temporal avançado e planejamento de longo horizonte voltados a robôs.
O Genie 4 é um world model que gera ambientes interativos e fotorrealistas, com áudio sincronizado e edição baseada em prompts em tempo real. O modelo mantém simulações consistentes por até dois minutos, o dobro da duração do Genie 3, e traz melhorias na física e no realismo dos personagens.
FrontierCode 2.0 amplia cobertura, endurece critério de mergeability e aumenta o escopo das tarefas
O FrontierCode 2.0 traz cobertura mais ampla, padrões mais altos de mergeability e tarefas de maior escopo, mantendo em grande parte a metodologia do FrontierCode 1.0. O benchmark agora admite comportamentos surpreendentes, desde que aceitáveis. As tarefas vêm de mais repositórios e abrangem mais categorias, e os critérios de avaliação passam a exigir requisitos mais extensos de correção e de design. As soluções de referência modificam, em média, 67% mais arquivos e 89% mais linhas de código do que no FrontierCode 1.1, em codebases 25% maiores.
StreamVibe-VL: modelo de visão e linguagem infere intenções implícitas do usuário em vídeo contínuo
O StreamVibe-VL é um modelo de visão e linguagem que infere as intenções implícitas do usuário a partir de observações contínuas e se adapta conforme essas intenções mudam. O trabalho foi publicado no arXiv.
A Anthropic enfrenta o desafio de equilibrar iniciativas ousadas de safety com decisões operacionais decepcionantes. O CEO Dario Amodei defendeu as estratégias caras e voltadas para safety da empresa, mas persistem preocupações sobre alignment, governança e os riscos potenciais do desenvolvimento de IA. A cultura interna reflete tanto esforços ambiciosos quanto sinais preocupantes de uma abordagem empresarial convencional. Isso alimenta o debate sobre o compromisso da empresa com a safety de IA e suas responsabilidades globais.
A Liquid AI lançou o LFM3, uma família de modelos open weight de texto, visão, áudio, omni e decisão, construída sobre um backbone tri-híbrido compartilhado, a partir da faixa de 2B de parâmetros. O modelo de texto de 1.7B supera o antecessor de 2.6B com 35% menos parâmetros, cabe em cerca de 1 GB com precisão de 4 bits e oferece janela de contexto de 256K para agentes que rodam no dispositivo. O LFM3-VL-2B adiciona entrada de vídeo e iguala o Gemma 4 12B em 62 benchmarks de visão. Todos os modelos da família podem passar por fine-tuning em uma única GPU.
A Meta pretende ampliar o desenvolvimento de infraestrutura da Nvidia, e as duas empresas avaliam trabalhar juntas em outras áreas, como o monitoramento do comportamento de agentes.
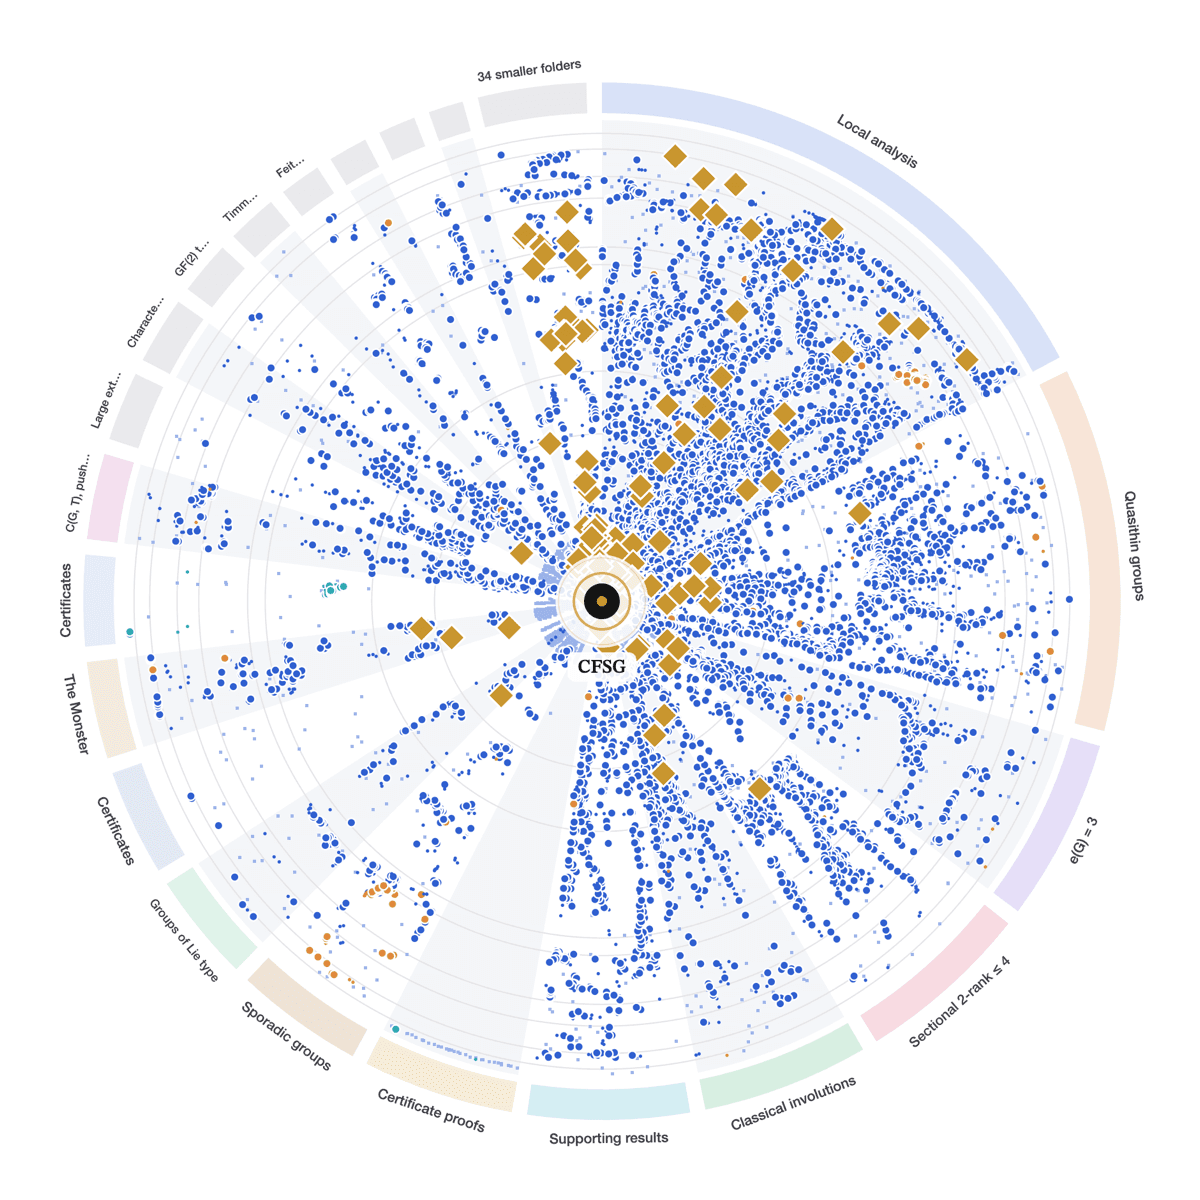
A Axiom Math divulgou a primeira prova completa verificada por computador da Classificação dos Grupos Simples Finitos (CFSG). A prova original é considerada a mais longa já escrita por humanos: cerca de 15 mil páginas, em mais de 500 artigos assinados por aproximadamente 100 matemáticos. Engenheiros e matemáticos da empresa coordenaram enxames de dezenas de agentes de IA ao longo de 24 dias, em um projeto que gerou cerca de 43,1 milhões de linhas de código no assistente de provas Lean.
A Anthropic firmou parcerias com seis organizações farmacêuticas e de biotecnologia para explorar como o Claude pode acelerar o desenvolvimento de medicamentos, da pesquisa inicial até a preparação de ensaios clínicos. A empresa também lançou programas internos de descoberta de medicamentos voltados a doenças raras da infância. Nesses programas, o Claude executa uma parte substancial do trabalho científico e operacional.
Pesquisadores desenvolveram uma nova forma de permitir que large language models integrem fatos novos e melhorem o raciocínio sem catastrophic forgetting e sem os knowledge cutoffs estáticos. O sleep framework dá aos LLMs um ciclo de vida periódico e contínuo, no qual eles aprendem de forma contínua e consolidam um contexto frágil de curto prazo em parâmetros estáveis de longo prazo. Ao alternar entre interação ativa e consolidação de memória offline, os modelos conseguem adquirir fatos novos continuamente, reter conhecimento de contexto longo de até 10M de tokens e melhorar o raciocínio complexo.
A Anthropic adquiriu a Mithril Medicine, biotech de uma pessoa só comandada por Cody Tranbarger. A startup foi fundada para desenvolver curas para doenças usando IA. Com a aquisição, a Mithril poderá seguir tocando seus programas com mais recursos, e Tranbarger poderá iniciar vários outros. O objetivo é escalar a nova forma de trabalho da startup e colocá-la nas mãos de toda a indústria biofarmacêutica, em todo o mundo.