
Classificação de Texto: Equilibrando Modelos Clássicos e LLMs na Rotulagem de Dados
Aprofundamento CEVIU
Aprofundamento
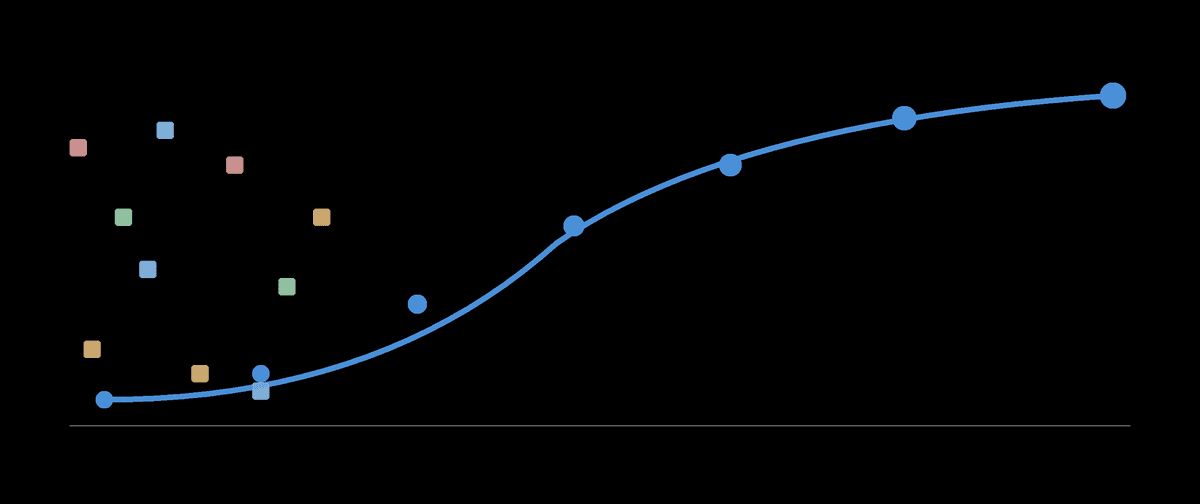
A classificação de texto, fundamental em pipelines de dados para roteamento de tickets e feedback, exige uma análise criteriosa da arquitetura e modelagem dos sistemas. O experimento prático com tickets de suporte demonstra a eficácia dos modelos clássicos, como TF-IDF combinado com regressão logística. Mesmo com um volume limitado de dados, a precisão desses modelos pode ter um salto considerável, passando de 40% para 60% ao aumentar os exemplos de treinamento por categoria de dois para dez. Isso sublinha a importância de acumular um volume inicial de dados rotulados antes de escalar para soluções mais complexas.
No entanto, o estudo também evidencia as limitações dos modelos clássicos diante de ambiguidades semânticas. Casos que exigem compreensão de intenção, e não apenas a frequência de termos, persistem como desafios. Aqui, a capacidade de raciocínio contextual dos Large Language Models (LLMs) complementa o processamento, atuando na rotulagem inicial ou na resolução de situações complexas que os modelos baseados em vocabulário não conseguem decifrar. Essa arquitetura híbrida otimiza tanto a acurácia quanto a eficiência operacional.
O que mudou
A cobertura anterior do CEVIU já explorava a importância estratégica dos LLMs, como na matéria 'Usando LLMs para Ampliar a Rotulagem Humana e Melhorar a Relevância da Busca no Dropbox Dash' de 2 de março de 2026, que mostrou seu papel na aceleração da rotulagem. Artigos como 'A Escolha Estratégica de LLMs: Equilibrando Poder e Custo em Desenvolvimento' de 3 de setembro de 2026 e 'Roteamento Inteligente de Modelos: Uma Estratégia para Otimizar Custos de LLMs' de 15 de setembro de 2026 já indicavam a busca por estratégias mais eficientes no uso de LLMs. A notícia atual evolui essa discussão ao apresentar dados empíricos concretos. Ela não apenas valida a necessidade de otimização de custos e performance, mas quantifica o limiar em que modelos clássicos são suficientes e onde os LLMs se tornam indispensáveis para resolver ambiguidades estruturais, transformando a teoria em uma diretriz prática baseada em evidências.
Por que isso importa
Para engenheiros e cientistas de dados, esta análise é crucial na tomada de decisões de arquitetura e otimização de custos. Adotar uma estratégia híbrida permite um balanço entre a economia e a velocidade dos modelos clássicos para tarefas rotineiras, e a inteligência contextual dos LLMs para os desafios mais complexos. Isso se traduz em redução de custos operacionais, especialmente em volume elevado de requisições, onde chamadas de API constantes a LLMs seriam proibitivas. Além disso, melhora a qualidade da classificação em cenários ambíguos, resultando em maior acurácia e, consequentemente, em uma melhor experiência para o usuário ou cliente final.
Linha do tempo
Usando LLMs para Ampliar a Rotulagem Humana e Melhorar a Relevância da Busca no Dropbox Dash
A Complexidade da IA: Quando um Agente Não é a Resposta Ideal
Avaliação de LLMs: Estratégias Essenciais para Implantação em Produção
A Escolha Estratégica de LLMs: Equilibrando Poder e Custo em Desenvolvimento
Roteamento Inteligente de Modelos: Uma Estratégia para Otimizar Custos de LLMs
Consenso de Juízes LLM: Confiança ou Falsa Segurança na Avaliação de Modelos de IA
Classificação de Texto: Equilibrando Modelos Clássicos e LLMs na Rotulagem de Dados
Perguntas frequentes
Por que não usar apenas LLMs para classificação de texto?
LLMs, embora poderosos, geram custos por requisição e introduzem latência de rede. Para alto volume de dados com padrões claros, modelos clássicos são mais econômicos e rápidos, com inferência em submilisegundos e custo marginal zero após o treinamento.
Quando modelos clássicos são mais adequados para classificação de texto?
Modelos clássicos são ideais para volumes de dados significativos e tarefas de classificação com menos ambiguidade. Sua performance melhora consideravelmente com um número moderado de exemplos rotulados, sendo a escolha mais eficiente para operações rotineiras e sensíveis a custo e latência.
O que é uma estratégia híbrida para classificação de texto?
Uma estratégia híbrida combina o melhor dos dois mundos: utiliza LLMs para rotulagem inicial de dados, para resolver casos ambíguos ou em cenários de dados limitados. Em paralelo, modelos clássicos gerenciam a classificação de alto volume, garantindo eficiência e custo-benefício para as operações diárias.
Como a quantidade de dados rotulados afeta a performance dos modelos clássicos?
A acurácia de modelos clássicos aumenta rapidamente com os primeiros exemplos rotulados, mas apresenta retornos decrescentes. Mais dados ajudam a corrigir erros por 'escassez de dados', mas não resolvem erros estruturais ligados à intenção, que exigem uma compreensão mais profunda do texto.
Fontes
- towardsdatascience.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 17 de setembro de 2026
- Editoria
- CEVIU Dados