
Consenso de Juízes LLM: Confiança ou Falsa Segurança na Avaliação de Modelos de IA
Aprofundamento CEVIU
Aprofundamento
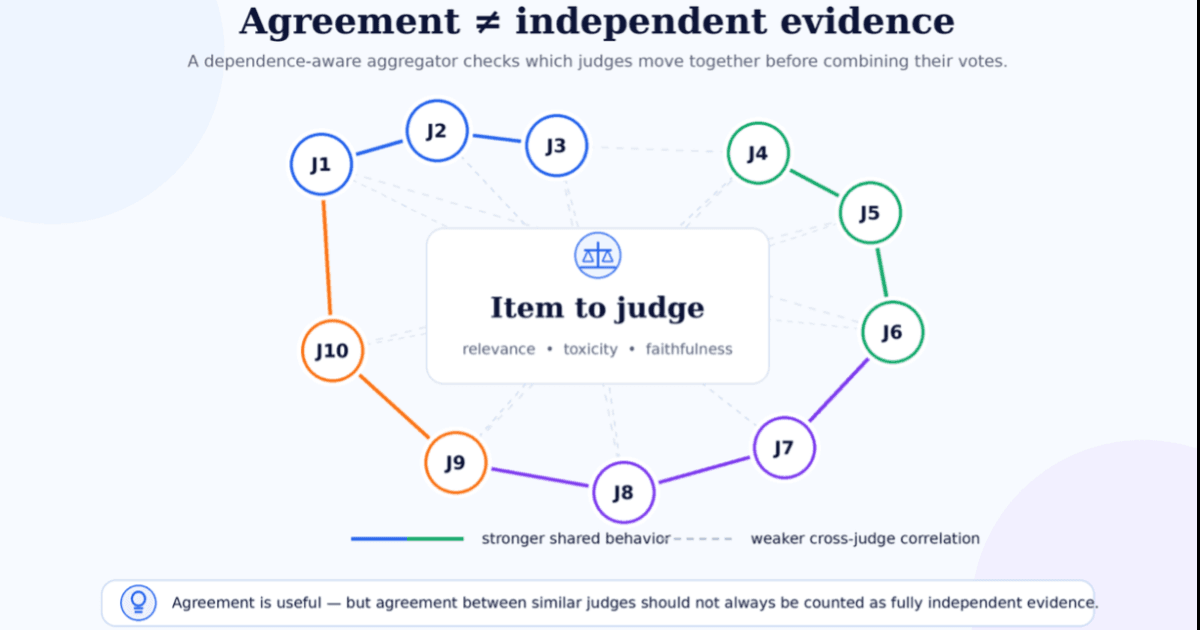
A ideia de usar Large Language Models (LLMs) como juízes na avaliação de outros modelos de IA, conhecida como LLM-as-a-judge, é poderosa. No entanto, ela carrega um desafio crítico. Quando vários LLMs concordam, pode parecer um sinal de validação robusta. A pesquisa recente alerta que essa concordância pode ser uma falsa segurança, especialmente se os modelos compartilham a mesma arquitetura, prompts ou vieses de treinamento.
O problema reside na premissa de que os erros dos juízes são independentes, algo que não se aplica bem a LLMs com origens ou configurações semelhantes. O novo método aborda isso tratando o painel de juízes como uma rede. Ele usa modelos de Ising, uma ferramenta da física estatística, para aprender não só a habilidade individual de cada juiz, mas também as correlações e dependências entre eles. Este processo não supervisionado otimiza a agregação dos resultados, descontando redundâncias e valorizando a diversidade genuína de opiniões, o que resultou em melhorias de 9% a 14% na precisão da avaliação em comparação com métodos tradicionais.
O que mudou
O CEVIU noticiou, em 18 de junho de 2026, o estudo “Consórcio de quatro LLMs alcança 86,2% de concordância unânime na detecção de vulnerabilidades”. Naquele momento, a alta concordância unânime era vista como um indicador de sucesso e robustez na aplicação de LLMs em tarefas de segurança. A pesquisa atual, porém, muda essa perspectiva. Ela sugere que a concordância não é suficiente por si só; é crucial que essa concordância venha de juízes verdadeiramente independentes.
O que mudou é a nossa compreensão da métrica de 'concordância'. Antes, a unanimidade era valorizada. Agora, a comunidade de desenvolvimento deve questionar a origem dessa concordância. Modelos que erram da mesma forma devido a vieses compartilhados não agregam valor independente, mesmo que concordem. A nova abordagem oferece um caminho para distinguir entre uma concordância genuína e uma falsa, aprofundando a complexidade da avaliação de IA.
Por que isso importa
Para quem trabalha com desenvolvimento de software e inteligência artificial, a capacidade de avaliar modelos de forma precisa é essencial. Uma avaliação falha leva a decisões erradas sobre quais modelos usar, onde otimizar ou como mitigar riscos de segurança. O novo método oferece um caminho para uma validação mais confiável, permitindo que as equipes de engenharia compreendam melhor as verdadeiras capacidades e limitações dos seus LLMs.
Isso impacta diretamente a qualidade do software, a segurança e a experiência do desenvolvedor (DX), já que ferramentas de avaliação mais eficazes significam ciclos de desenvolvimento mais rápidos e produtos finais mais robustos. Entender a dependência entre os juízes LLM é um passo crítico para construir sistemas de IA em que podemos realmente confiar.
Linha do tempo
CEVIU questiona enviesamento de ganhos de raciocínio em IA por expansão do corpus de treinamento.
CEVIU aborda lacunas entre julgamento humano e juízes LLM em avaliações de IA no mundo real.
CEVIU discute o framework Universal de Verificação 'LLM-as-a-Judge'.
CEVIU noticia consórcio de LLMs com alta concordância na detecção de vulnerabilidades.
CEVIU apresenta G-Eval, uma nova abordagem para avaliação de texto gerado por LLMs.
CEVIU analisa a saturação de benchmarks de LLMs como desafio para avaliação de modelos de IA.
Pesquisa questiona se consenso de juízes LLM é confiança ou falsa segurança.
Perguntas frequentes
O que é o conceito de "LLM-as-a-judge"?
É um framework onde um Large Language Model (LLM) é utilizado para avaliar as saídas de outros modelos ou sistemas de IA. Este método automatiza tarefas de avaliação que tradicionalmente exigiriam julgamento humano, como a análise da qualidade de um texto gerado, atribuindo pontuações ou julgamentos para auxiliar no desenvolvimento e otimização de IA.
Por que a votação majoritária tradicional é insuficiente para avaliar juízes LLM?
A votação majoritária, mesmo ponderada pela precisão histórica, assume que os erros dos juízes são independentes. No contexto de juízes LLM, isso é muitas vezes otimista. Modelos podem compartilhar vieses, prompts ou arquiteturas semelhantes, levando a erros correlacionados. Isso cria uma falsa sensação de consenso e mascara as fragilidades reais do sistema de avaliação.
Como os modelos de Ising são aplicados para melhorar a avaliação de juízes LLM?
Os modelos de Ising são utilizados para modelar as relações de dependência entre os juízes LLM. Eles permitem que o sistema aprenda não apenas a confiabilidade individual de cada juiz, mas também as correlações pareadas entre eles. Isso ajuda a descontar concordâncias redundantes e a identificar uma diversidade genuína de perspectivas, resultando em uma agregação de resultados mais precisa.
Qual o impacto dessa nova abordagem para desenvolvedores de LLMs?
A nova abordagem oferece uma avaliação mais precisa e confiável, crucial para o avanço dos LLMs. Ela permite que os desenvolvedores identifiquem vieses compartilhados e entendam onde os modelos realmente diferem ou falham. Isso melhora a depuração, a otimização e a construção de modelos de IA mais robustos e com maior qualidade, impactando positivamente a experiência do desenvolvedor.
Fontes
- amazon.sciencefonte original
- Categoria
- CEVIU Web Dev
- Publicado
- 15 de setembro de 2026
- Editoria
- CEVIU Web Dev