
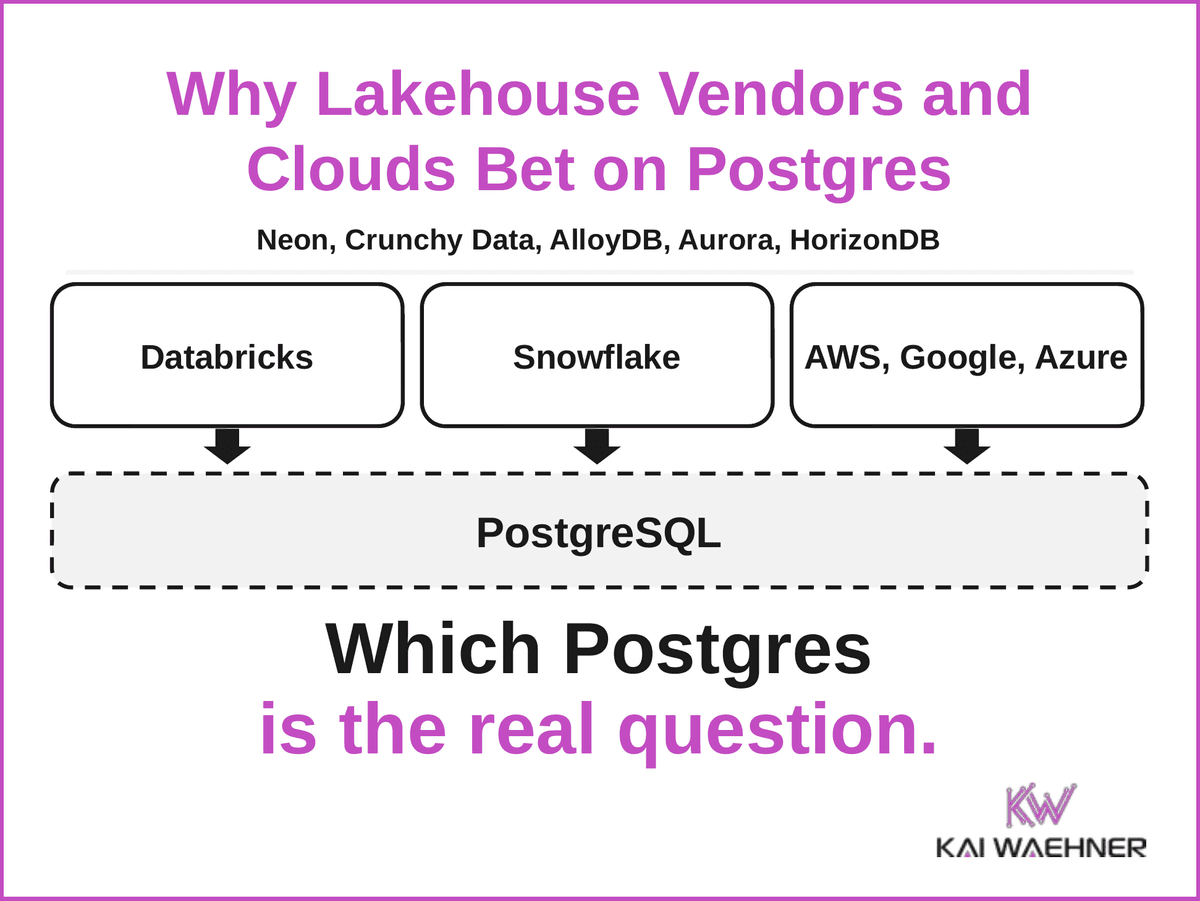
Por que fornecedores de lakehouse e clouds apostaram no Postgres para aplicações de IA
Aprofundamento CEVIU
Aprofundamento
A tese do texto é direta: Databricks, Snowflake, Google, Amazon e Microsoft escolheram o mesmo banco por baixo, o Postgres, com estratégias distintas. A Databricks pagou cerca de 1 bilhão de dólares pela Neon, de Postgres serverless com storage e compute separados. A Snowflake pagou cerca de 165 milhões de dólares pela Crunchy Data, conhecida por operar o Postgres de verdade em ambientes regulados. O Google adicionou compute separado para agentes no AlloyDB, que desliga quando o agente termina, além de consultas federadas ao BigQuery. A Amazon embutiu o DuckDB no Aurora PostgreSQL para ler Iceberg e Parquet no S3. A Microsoft anunciou o HorizonDB.
O autor separa quatro camadas de compatibilidade: protocolo de rede, dialeto SQL, ecossistema de extensões e engine de storage. Quanto mais fundo o produto vai, mais do ecossistema funciona sem mudança. Extensões como pgvector e pg_lake definem qual camada você precisa, e a camada define o custo de saída. O texto também lembra a outra aposta: Oracle, SAP, IBM, OceanBase, SingleStore e TiDB embutem vetores e analítica em engines próprios, e a Microsoft joga nos dois lados (HorizonDB e SQL Server 2025).
O que mudou
A cobertura do CEVIU mostra que a aposta vinha sendo montada aos poucos. Em 13 de agosto de 2026, o CEVIU noticiou "Databricks Adquire Electric para Potencializar Agentes de IA com Bancos de Dados Locais de Alta Velocidade", com o PGlite (Postgres em WASM) dentro de sandboxes de agentes. Em 3 de setembro de 2026, veio "AWS Adquire DuckLabs para Impulsionar Análise de Dados no S3 e Agentes de IA", que conecta com o DuckDB embutido no Aurora. Em 30 de setembro de 2026, "Lakebase Aprimora Postgres com Pesquisa Vetorial e Full-Text Avançada em Nuvens" trouxe as extensões lakebase_vector e lakebase_text, disponíveis na AWS e no Azure. A matéria atual junta essas peças numa leitura de mercado.
Por que isso importa
Para quem desenha pipelines e plataformas de dados, a leitura é que "Postgres" na proposta comercial não basta como critério. Vale perguntar qual camada de compatibilidade o fornecedor entrega e quais extensões seu workload usa hoje. Para sistemas de registro já em Oracle, SAP ou Db2, o texto sugere ler o dado onde ele mora, sem copiar para um Postgres novo. A escolha segue o workload, não a moda.
Linha do tempo
SAP adquire a Dremio, apostando em dados corporativos prontos para IA.
Databricks anuncia a compra da Electric para levar o PGlite a sandboxes de agentes.
AWS adquire a DuckLabs para influenciar o desenvolvimento do DuckDB.
Lakebase chega à disponibilidade geral com busca vetorial e full-text na AWS e no Azure.
Análise mostra por que lakehouses e clouds convergiram no Postgres para IA.
Perguntas frequentes
Por que tantos fornecedores escolheram o Postgres para IA?
Segundo a análise, qualquer fornecedor pode construir sobre ele, a maioria dos desenvolvedores já o conhece e o modelo de extensões permitiu à comunidade adicionar vetores e analítica mais rápido do que um único fornecedor faria. Isso reduz a barreira de adoção.
Quanto Databricks e Snowflake pagaram por Neon e Crunchy Data?
A Databricks pagou cerca de 1 bilhão de dólares pela Neon. A Snowflake pagou cerca de 165 milhões de dólares pela Crunchy Data. O texto atribui o prêmio à combinação de compatibilidade com arquitetura moderna.
Todo serviço com rótulo Postgres é equivalente?
Não. A compatibilidade tem quatro camadas: protocolo, dialeto SQL, ecossistema de extensões e engine de storage. Quanto mais fundo o produto vai nelas, mais do ecossistema funciona sem alteração, e isso afeta o custo de sair da oferta.
Postgres é sempre a melhor opção para aplicações de IA?
Não. Um banco vetorial dedicado atende bilhões de embeddings, e um lakehouse escaneia petabytes de histórico. Para escala global ou alto volume de escrita, o texto cita Oracle, SQL Server, SAP HANA, Db2, OceanBase, SingleStore e TiDB como alternativas.
Fontes
- kai-waehner.defonte original
- Categoria
- CEVIU Dados
- Publicado
- 12 de novembro de 2026
- Editoria
- CEVIU Dados