
Lakebase Aprimora Postgres com Pesquisa Vetorial e Full-Text Avançada em Nuvens
Aprofundamento CEVIU
Aprofundamento
A chegada do Lakebase para PostgreSQL na AWS e Azure redefine a forma como equipes de plataforma e DevOps abordam a busca em bancos de dados. Esta solução não é uma simples adição de funcionalidades. É uma arquitetura reprojetada que integra busca vetorial avançada, via lakebase_vector, e busca full-text de última geração, com lakebase_text (BM25), diretamente no Postgres. Isso elimina a complexidade e os gargalos de desempenho que historicamente exigiam sistemas de busca separados com pipelines ETL.
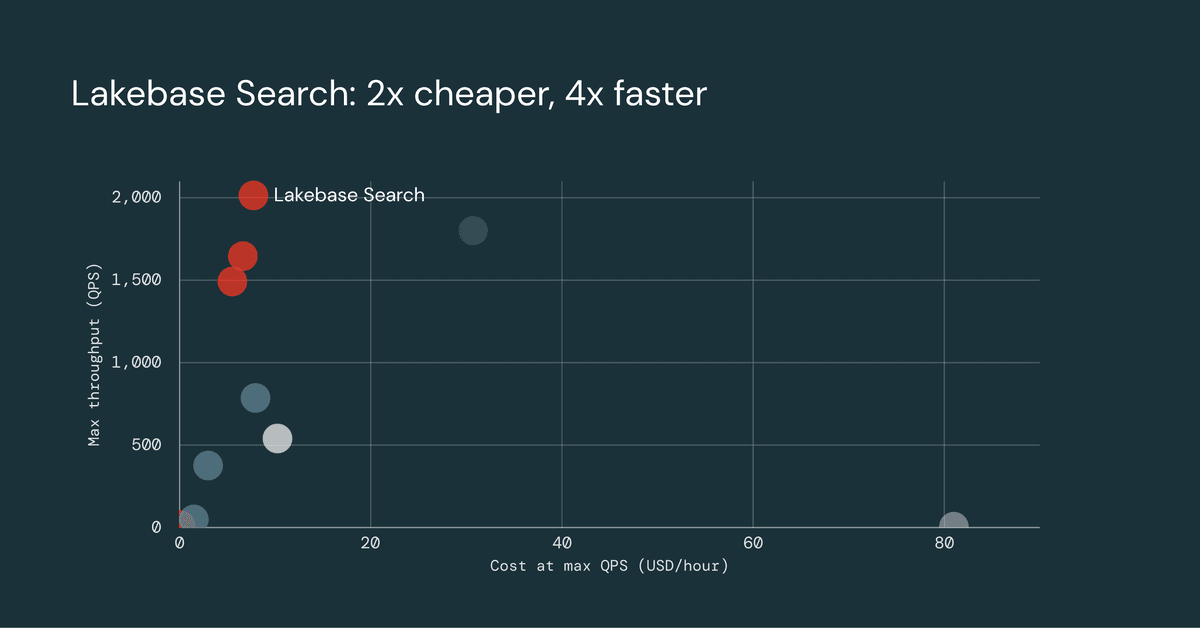
Tecnicamente, o Lakebase se destaca pela dissociação do armazenamento da computação. Enquanto o `pgvector` tradicional luta com a necessidade de manter todo o índice em memória para performance, o Lakebase armazena dados duráveis em object storage na nuvem e usa RAM e NVMe locais como caches ephemerais. A extensão lakebase_vector otimiza isso com o uso de clusterização IVF hierárquica e quantização binária (RaBitQ), permitindo que consultas acessem apenas os blocos de dados necessários. O resultado são custos operacionais até quatro vezes menores que o `pgvector` em cenários de nuvem e um throughput duas vezes maior em benchmarks de 100 milhões de vetores. Para a busca full-text, lakebase_text implementa o algoritmo BM25, superando o `tsvector` padrão do Postgres ao considerar o contexto de relevância de todo o corpus e otimizar o acesso a blocos de dados, o que é crucial para agentes de IA que demandam alta precisão e baixa latência.
O que mudou
A cobertura anterior do CEVIU News, como a de 17 de setembro de 2026, com a notícia sobre a Extensão TIN para PostgreSQL, já sinalizava um movimento para otimizar a busca full-text no Postgres. O TIN oferecia uma gama de queries robustas, enquanto o lakebase_text agora traz especificamente o algoritmo BM25, focando na relevância e na integração nativa com a busca vetorial para queries híbridas. Além disso, no campo da busca vetorial, a notícia de 4 de abril de 2026, sobre o AlloyDB IA, já mostrava o interesse em trazer embeddings e busca vetorial para o PostgreSQL.
O Lakebase representa uma evolução significativa ao resolver os principais desafios de escala e custo do `pgvector`, uma solução amplamente utilizada. Onde o `pgvector` atinge limites de memória e manutenção de índice, o lakebase_vector introduz uma arquitetura serverless e separada de armazenamento e computação. Isso significa que, enquanto outras soluções introduzem capacidades de IA e busca, o Lakebase foca em fazer isso de forma extremamente performática e custo-efetiva em larga escala, atendendo às demandas dinâmicas dos agentes de IA.
Por que isso importa
Para engenheiros de plataforma e equipes de DevOps, esta solução é um divisor de águas na gestão de dados para aplicações de IA. O Lakebase permite consolidar cargas de trabalho OLTP e de busca em um único banco de dados Postgres, simplificando a arquitetura e reduzindo a complexidade operacional. Sua natureza serverless e o pagamento por uso eliminam a necessidade de provisionamento manual e gestão de infraestrutura, resultando em otimização de custos e maior agilidade.
A capacidade de realizar buscas vetoriais e full-text com alta performance e baixa latência, diretamente no banco de dados, facilita o desenvolvimento de agentes de IA e aplicações RAG (Retrieval-Augmented Generation). Isso melhora a experiência do desenvolvedor, que agora pode usar SQL para todas as operações, garantindo governança e segurança por meio das regras do banco de dados.
Linha do tempo
AlloyDB IA amplifica PostgreSQL com funções de IA
Apache Hudi revoluciona Lakehouses com Busca Vetorial Nativa
Chdb Extende PostgreSQL para Importações e Exportações de Alta Performance com Armazenamento em Nuvem
Nova Extensão TIN Revoluciona Busca Full-Text no PostgreSQL
Lakebase Aprimora Postgres com Pesquisa Vetorial e Full-Text Avançada em Nuvens
Perguntas frequentes
O que é a busca vetorial em bancos de dados?
A busca vetorial permite encontrar itens (documentos, imagens, áudios) que são semanticamente similares a uma consulta. Isso é feito convertendo-os em vetores numéricos de alta dimensão (embeddings) e calculando a distância entre esses vetores. Quanto menor a distância, maior a similaridade semântica.
Qual a principal vantagem do Lakebase sobre o pgvector para busca vetorial?
O Lakebase supera o `pgvector` em escalabilidade e custo ao desacoplar armazenamento e computação. Ele não exige que todo o índice vetorial resida na RAM, utilizando técnicas como clusterização IVF e quantização binária. Isso resulta em maior throughput, menor custo e melhor desempenho para grandes volumes de dados.
Como a separação de armazenamento e computação beneficia o Lakebase?
Essa separação permite que o Lakebase opere de forma serverless, escalando para zero quando ocioso e cobrando apenas pelo uso da consulta. Dados duráveis ficam em armazenamento de baixo custo, e a computação é provisionada sob demanda, otimizando custos e garantindo performance sem a necessidade de manter recursos caros sempre ativos.
Para quais tipos de aplicações o Lakebase Search é mais indicado?
O Lakebase Search é ideal para aplicações que exigem alta performance em busca semântica e full-text, especialmente aquelas baseadas em agentes de IA e RAG. Sua arquitetura é projetada para lidar com padrões de recuperação de dados 'bursty' (com picos) e para consolidar workloads operacionais e de busca em um único ambiente, simplificando a stack de dados.
Fontes
- databricks.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 30 de setembro de 2026
- Editoria
- CEVIU DevOps