
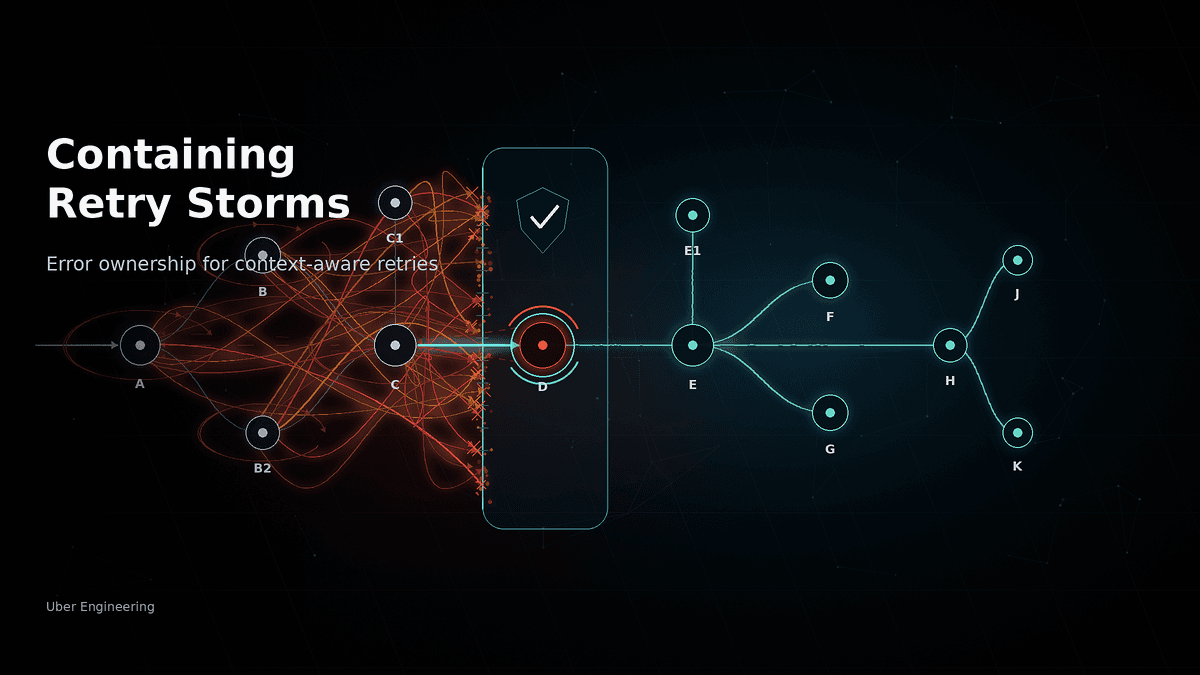
Uber Fortalece Service Mesh Contra 'Tempestades de Retries'
Aprofundamento CEVIU
Aprofundamento
A implementação do 'error ownership' pela Uber no seu service mesh representa um avanço significativo na engenharia de confiabilidade para arquiteturas de microsserviços. Em vez de simplesmente limitar retries de forma genérica, o sistema agora consegue determinar a causa raiz de um erro, distinguindo entre falhas que surgem no próprio serviço e aquelas que são meramente propagadas de uma dependência. Essa inteligência permite um controle muito mais granular e eficaz, evitando que um problema localizado se transforme em uma 'tempestade de retries' que derruba múltiplos serviços.
Para quem trabalha com DevOps e engenharia de plataforma, essa abordagem ressalta a importância de construir infraestruturas de plataforma que não apenas roteiem o tráfego, mas também entendam o contexto da interação entre serviços. É uma evolução de uma abordagem reativa para uma proativa, onde a rede de serviços se torna mais consciente e resiliente, abstraindo a complexidade do tratamento de erros para os desenvolvedores e garantindo a estabilidade em cenários de alta carga ou falha.
O que mudou
A Uber evolui sua estratégia de gerenciamento de tráfego e confiabilidade. Em fevereiro de 2026, o CEVIU News publicou sobre o Global Rate Limiter (GRL) da Uber, um sistema unificado que gerencia milhões de RPCs por segundo, integrado ao service mesh. Enquanto o GRL foca em controlar o volume de requisições para evitar sobrecarga, o novo mecanismo de 'error ownership' adiciona uma camada de inteligência crucial na identificação e contenção de erros.
Antes, retries eram aplicados de forma mais uniforme. Com o 'error ownership', o service mesh sabe quando um erro vem da origem real ou se é apenas um sintoma de uma falha em cascata. Isso impede que serviços saudáveis amplifiquem o problema, diferentemente de retries cegos. O que era uma medida de controle de tráfego evolui para uma estratégia sofisticada de isolamento de falhas, focando na prevenção de 'tempestades de retries' e na redução do impacto em dependências críticas.
Por que isso importa
Em ambientes de microsserviços, a capacidade de identificar rapidamente a causa de falhas e evitar que elas se espalhem é vital para a experiência do usuário e a saúde operacional. O 'error ownership' da Uber serve como um modelo para empresas que buscam construir sistemas distribuídos mais robustos. Ele mostra como a inteligência no service mesh pode reduzir drasticamente o tempo de resposta a incidentes e mitigar perdas.
Reduzir o raio de propagação de falhas de 25 para 3 'saltos' e evitar milhões de retries desnecessários não é apenas uma melhoria técnica. Significa menos indisponibilidade, mais confiança do cliente e menores custos operacionais para as equipes de SRE e DevOps, que podem focar em problemas reais em vez de apagar incêndios causados por amplificação de falhas.
Linha do tempo
Incidente na Uber onde o sistema de 'error ownership' evitou 9,5 milhões de retries desnecessários.
CEVIU News cobre o sistema Global Rate Limiter (GRL) da Uber, integrado ao service mesh.
CEVIU News reporta sobre o RADAR da Databricks para detecção de 'falhas cinzentas'.
Uber aprimora seu service mesh com o mecanismo de 'error ownership' para combater 'tempestades de retries'.
Perguntas frequentes
O que é uma 'tempestade de retries'?
Uma 'tempestade de retries' ocorre quando um serviço dependente tenta reprocessar agressivamente requisições que falharam em um serviço subjacente. Se o serviço subjacente já está com problemas, essas tentativas adicionais podem sobrecarregá-lo ainda mais, criando um ciclo vicioso que amplifica a falha e pode derrubar outros serviços na cadeia de chamadas.
Como funciona o mecanismo de 'error ownership'?
O 'error ownership' permite que os serviços dentro do service mesh identifiquem a origem de um erro. Ele distingue se a falha foi gerada pelo próprio serviço ou se foi herdada de uma dependência. Com essa informação, o sistema de retry pode decidir de forma inteligente se deve ou não tentar novamente a requisição, evitando retries desnecessários que sobrecarregariam serviços já em dificuldade.
Qual o papel do service mesh nesse contexto?
O service mesh é a camada de infraestrutura onde a lógica de 'error ownership' e a decisão de retries são implementadas. Ele atua como um plano de controle e dados que intercepta e gerencia o tráfego entre microsserviços. Ao integrar essa inteligência diretamente no mesh, a Uber garante que a proteção contra 'tempestades de retries' seja aplicada de forma consistente em toda a sua vasta arquitetura de serviços.
Por que retries genéricos não são suficientes em arquiteturas complexas?
Em arquiteturas complexas, retries genéricos podem agravar falhas. Se um serviço está lento devido a uma falha interna, retentativas apenas aumentam a carga, acelerando a degradação. O 'error ownership' resolve isso, permitindo retries apenas quando há uma chance real de sucesso, ou seja, quando o erro é transitório e não indica um colapso iminente do serviço.
Fontes
- uber.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 30 de setembro de 2026
- Editoria
- CEVIU DevOps