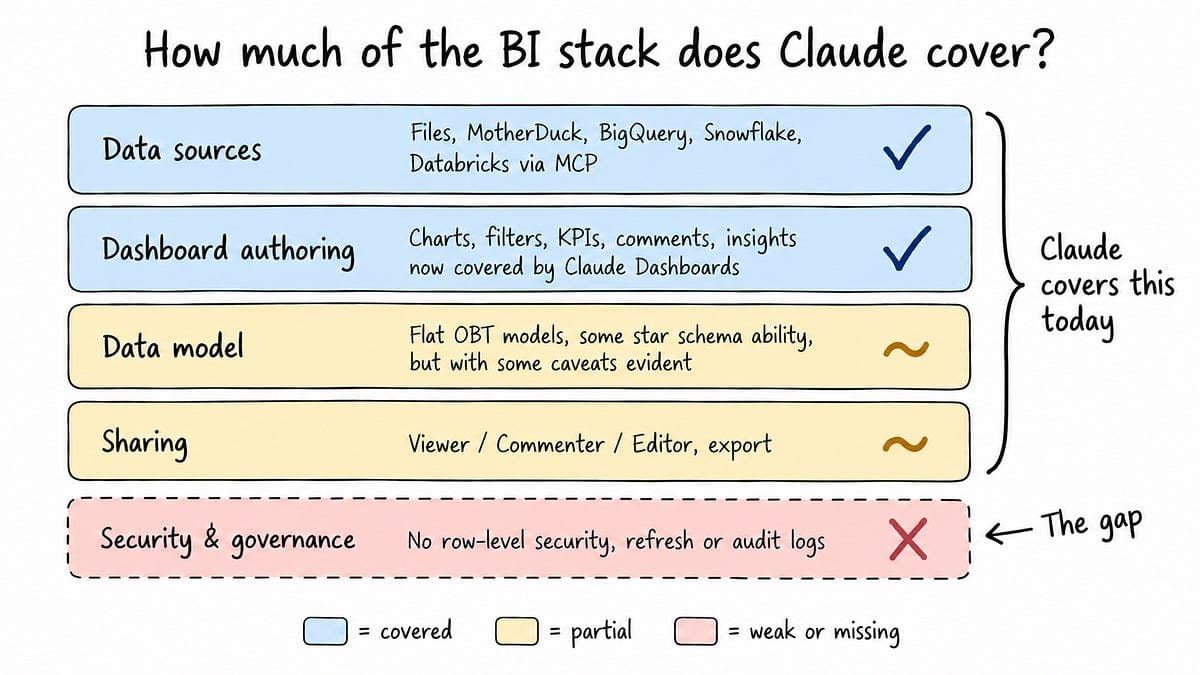
O novo beta do Claude Dashboards da Anthropic promete revolucionar a criação de painéis analíticos, permitindo que os usuários gerem dashboards completos sem a necessidade de construir gráficos manualmente. Embora a ferramenta ofereça rastreabilidade detalhada dos dados, funcionalidades essenciais para o ambiente corporativo, como segurança em nível de linha, atualização automática e logs de auditoria, ainda não foram implementadas. Para os profissionais de BI, a mensagem é clara: priorizem modelagem de dados, SQL e design, em vez de se prenderem a funcionalidades superficiais de ferramentas.
O Pinterest transformou sua abordagem de personalização, trocando um pipeline de clustering de palavras-chave por um LLM de 4 bilhões de parâmetros. Esse modelo, meticulosamente ajustado, agora converte o histórico de atividades dos usuários em "jornadas" (metas ativas) altamente ranqueadas e contextualizadas. A implementação, que utiliza a destilação de modelo (teacher-model distillation), garantiu que a solução fosse escalável e eficiente, resultando em um engajamento significativamente maior nas notificações da plataforma, tudo isso mantendo rigorosos filtros de segurança e mecanismos de feedback contínuo.
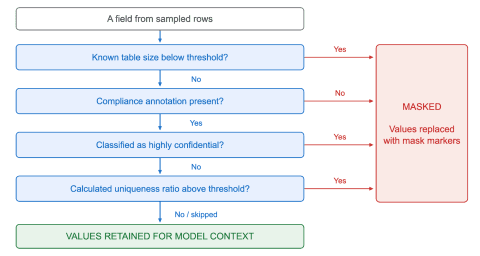
A Elastic está na vanguarda da otimização de agentes de IA, desenvolvendo um inovador 'context engine'. O objetivo é combater o desperdício comum de tokens, onde agentes frequentemente consomem recursos valiosos ao interpretar esquemas de tabelas e campos repetidamente. Essa nova abordagem promete uma redução de até 71% no consumo de tokens, melhorando a eficiência e o custo-benefício em operações que dependem intensamente de processamento de linguagem natural e inferência de dados.
O DuckDB CLI, em sua versão 2.0, agora é capaz de detectar o uso por agentes de IA, ativando um "modo agente" que otimiza a saída de dados. Esta funcionalidade visa reduzir o consumo de tokens e aprimorar a interação de IAs com o banco de dados. Ao identificar a IA, a ferramenta adota uma saída compacta, sinaliza resultados truncados, interrompe consultas descontroladas e padroniza erros em formato JSON, facilitando o processamento. Testes rigorosos com 132 execuções TPC-H demonstraram uma redução de aproximadamente 60% no volume de tokens lidos pelos agentes, sem comprometer a precisão das respostas.
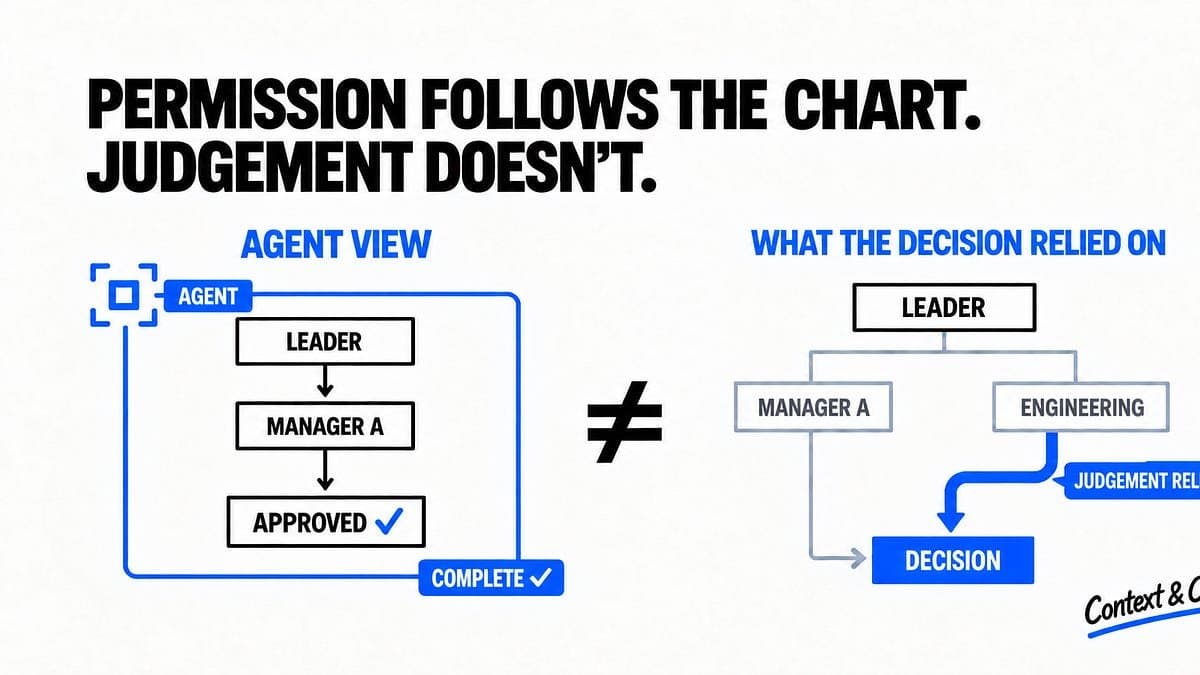
Muitas vezes, agentes empresariais tomam decisões problemáticas, mesmo com permissões formais. Isso ocorre quando registros ignoram indivíduos cujo julgamento impacta os resultados. O Authority Resolution Framework diferencia direitos documentados, permissões de sistema, aprovações, influência informal e o mandato de um agente. A inconsistência entre esses pontos indica problemas de governança. É crucial identificar e resolver essas lacunas de autoridade antes que a automação transforme pontos cegos organizacionais em ações confiantes, com potencial de erro amplificado. Esta abordagem se torna vital para garantir a integridade dos processos e a confiabilidade das decisões, especialmente em ambientes automatizados onde a falta de clareza pode levar a consequências indesejadas.
Análises aprofundadas no PostgreSQL revelam gargalos comuns que degradam o desempenho de consultas. Casos como deduplicação excessiva, materialização ineficiente de CTEs, ordenação aleatória sem necessidade, extração de colunas redundantes e o uso de expressões não indexadas são apontados como vilões. A boa notícia é que ajustes pontuais no SQL ou a implementação estratégica de índices podem transformar a performance, garantindo processamento mais rápido e eficiente para seus dados.
No PostgreSQL, a organização física dos dados de cada relação se dá através de arquivos no diretório `base/`, identificados por tablespace, banco de dados e um `relfilenode` único. Além disso, 'forks' como `_fsm` e `_vm` são criados, e arquivos TOAST gerenciam dados grandes. É importante notar a flexibilidade entre a identidade lógica da tabela e seu armazenamento físico: comandos como `VACUUM FULL` ou `REINDEX` podem alterar o `relfilenode` sem mudar a tabela em si. Para relações com grande volume de dados, o PostgreSQL as segmenta automaticamente em múltiplos arquivos para otimizar a gestão.
O LinkedIn desenvolveu uma camada de contexto de dados para guiar usuários e agentes de IA na seleção e interpretação de conjuntos de dados. A iniciativa visa aumentar a confiança e eficiência na análise de informações. Integrando perfis gerados por LLMs e anotações colaborativas, a plataforma elevou a taxa de respostas aceitáveis de seus agentes de analytics de 25,9% para 79,5% em testes. Além disso, o tempo médio de resposta foi drasticamente reduzido, passando de 10,7 para 4,7 minutos, demonstrando um avanço significativo na qualidade e agilidade das operações de dados.
A fase beta do PostgreSQL 19 tem gerado discussões acaloradas na comunidade de desenvolvedores e administradores de bancos de dados. Recentemente, entre oito e dez recursos considerados importantes foram removidos do ciclo de desenvolvimento, mesmo alguns estando em estágios avançados de implementação. Essa medida levanta questionamentos sobre as prioridades e o processo de tomada de decisão para as próximas versões do PostgreSQL, um pilar essencial para inúmeras infraestruturas de dados globais. Os desenvolvedores e usuários acompanham de perto os desdobramentos para entender o impacto dessas decisões na estabilidade e evolução da plataforma.
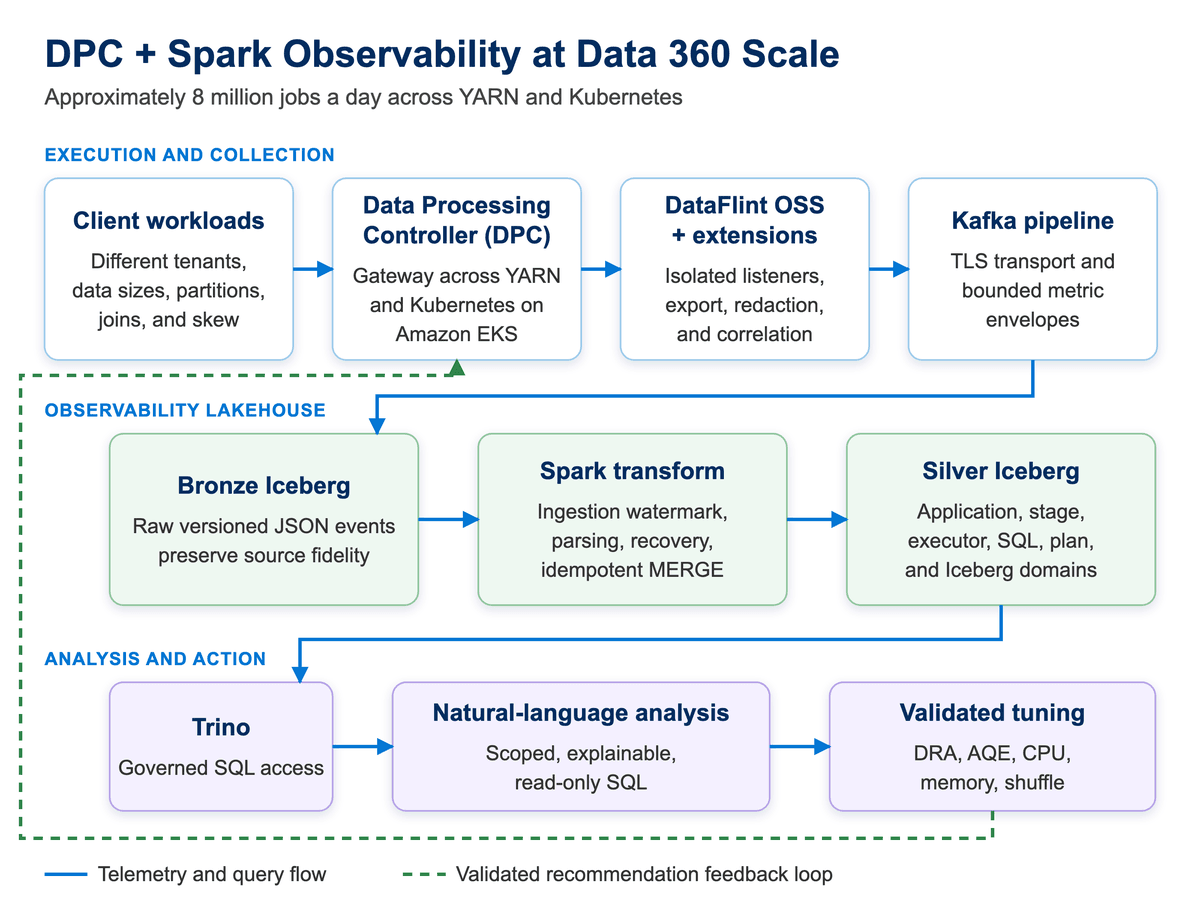
A Salesforce, ao gerenciar aproximadamente 8 milhões de jobs Spark por dia, enfrentava um desafio comum: executores ociosos em suas cargas de trabalho. A equipe de engenharia da empresa descobriu que alguns processos mantinham os executors inativos por mais de 90% do tempo. Para combater isso, implementaram uma estratégia de dimensionamento de cargas de trabalho baseada no uso real, resultando em uma expressiva redução de 31% nos custos semanais de compute. Notavelmente, essa otimização foi alcançada sem impactar negativamente o tempo de execução, a taxa de falhas ou o número de reprocessamentos, evidenciando a eficácia da abordagem em um ambiente de dados de alta escala.
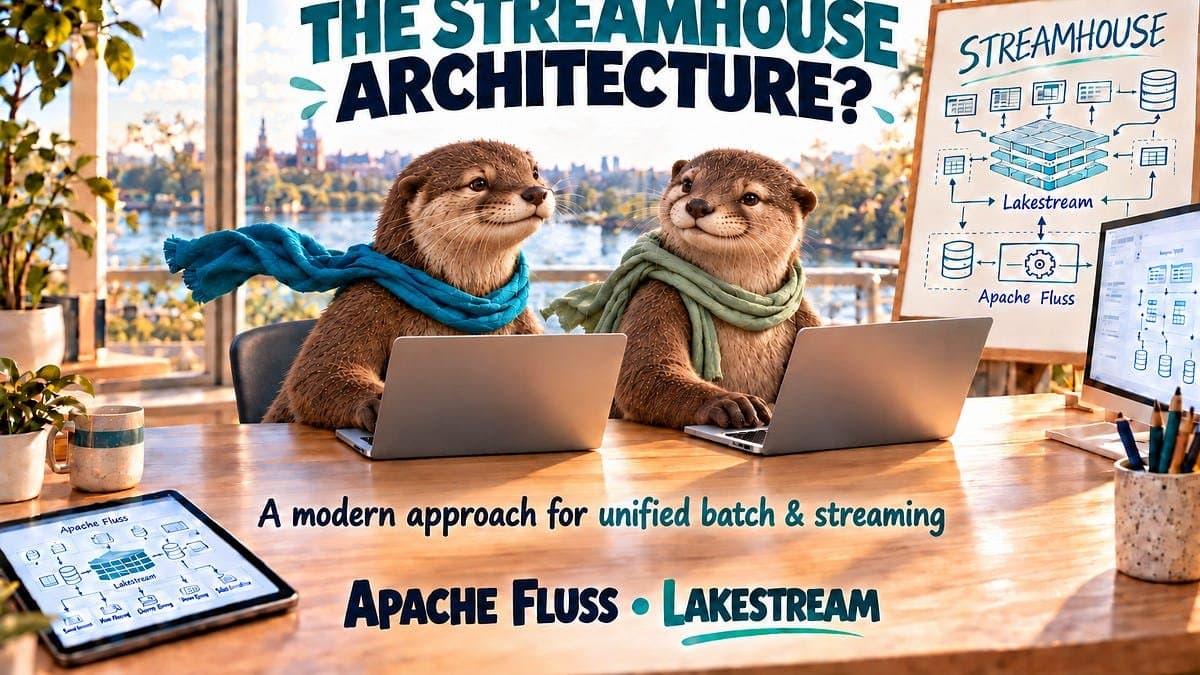
A Apache Fluss introduz o conceito de 'Streamhouse', uma arquitetura inovadora que consolida streaming, serviço e análise de dados em uma única tabela lógica, eliminando a necessidade de sistemas separados e sincronizados. Essa abordagem visa unificar dados de streaming em tempo real com o histórico robusto de um lakehouse, por meio de metadados e camadas de acesso compartilhadas. Com isso, equipes de dados evitam a reconstrução de estados em múltiplos locais, otimizando a ingestão e permitindo réplicas ou caches especializados para diferentes padrões de acesso. A proposta é clara: simplificar a gestão de dados e acelerar a entrega de insights.
A WHOOP, empresa de tecnologia vestível, implementou um pipeline de Change Data Capture (CDC) self-service revolucionário. A solução permite que equipes de aplicação repliquem centenas de tabelas Postgres para o data warehouse de forma eficiente. O sistema foi projetado para otimizar o acesso a alterações brutas, desacoplando-o da materialização de tabelas – um processo mais lento e oneroso. Além disso, a ferramenta automatiza a evolução do esquema e a propriedade dos dados. A principal lição aprendida foi que a escalabilidade do CDC é maximizada quando a integração é impulsionada pela publicação e a responsabilidade operacional permanece alinhada ao serviço de origem, garantindo maior agilidade e controle.
A MotherDuck, em uma recente demonstração, revelou cinco aplicações práticas de seu modelo Jev IA para classificação de texto diretamente via SQL. Entre os exemplos estão a avaliação de desempenho de agentes de IA, análise de sentimento de consumidores, pontuação de chamadas de vendas e a categorização automática de vagas de emprego. O Jev se destaca por fornecer respostas pré-definidas acompanhadas de pontuações de confiança, oferecendo um processamento até 20 vezes mais rápido que chamadas LLM convencionais, o que barateia e democratiza a análise de texto em larga escala no ambiente de dados.
Para garantir a confiabilidade de agentes de dados, que lidam com modelos e prompts em constante evolução, é crucial implementar testes de regressão, e não apenas demonstrações. Uma abordagem eficaz envolve a criação de um conjunto de "golden-questions" associadas a snapshots de dados imutáveis. Os resultados são avaliados com base nas execuções reais, integrando-se diretamente ao pipeline de Integração Contínua (CI). Gerenciar essas modificações nos agentes como lançamentos de software, com execuções armazenadas, limites de categoria e "hard safety gates", assegura a estabilidade e a qualidade dos dados.
O Pinterest inovou com o lançamento do Metrics Board, uma plataforma centralizada que revoluciona a criação e gestão de métricas. A ferramenta automatiza a geração, verificações de qualidade, documentação e publicação de métricas, garantindo maior confiabilidade e agilidade. Atualmente, o Metrics Board gerencia mais de 98% das métricas de experimentação do Pinterest, reduzindo o tempo de desenvolvimento de semanas para dias. Além disso, a plataforma provê aos agentes de IA acesso a um ecossistema de métricas confiáveis e bem definidas, facilitando a tomada de decisões orientadas por dados.
A HiringCafe realizou um benchmark comparativo entre a ferramenta Jev, a nova Decisions API da OpenAI e o Gemini 3.1 Flash-Lite, focando na correspondência de vagas a buscas e currículos. Os resultados indicaram que Jev demonstrou superioridade na precisão e eficácia, superando as outras soluções de IA nos testes. Este estudo ressalta a importância da escolha de ferramentas de IA otimizadas para tarefas específicas, especialmente em processos de recrutamento e seleção baseados em dados.
Dados de séries temporais vão muito além de simples valores e timestamps. Unidades de medida, proveniência, derivações e o tratamento de exceções são cruciais para um entendimento completo e correto. Ferramentas como JSON-LD e RDF surgem como soluções para tornar esse contexto explícito e consultável, elevando o nível de validação e interoperabilidade dos dados. A recomendação é clara: embora medições em massa devam ser armazenadas em formatos tabulares ou bancos de dados de séries temporais otimizados, uma camada de grafos é essencial para gerenciar metadados, semântica e detectar anomalias de forma eficiente. Isso garante que a "inteligência" de seus dados não se perca no volume.
A Apache DataFusion lança a versão 1.1.0 do Comet, focando em expandir a execução nativa do Spark. Destaques incluem a introdução de gravações experimentais no Iceberg e a integração com o Celeborn para shuffle nativo, prometendo ganhos substanciais de performance. A atualização também aborda um ponto crítico de falha, a pressão de memória off-heap, com melhorias em contabilidade e logging, visando reduzir encerramentos inesperados de containers e garantir maior estabilidade operacional em ambientes de processamento de dados.
A Google DeepMind apresentou o AlphaProtein Novo, uma inovadora ferramenta de IA capaz de projetar enzimas completamente novas. Essas enzimas sintéticas demonstram potencial significativo na criação de ingredientes farmacêuticos e na degradação de poluentes plásticos. Com a capacidade de superar o desempenho de enzimas naturais em diversas tarefas, o AlphaProtein Novo abre novas fronteiras para a pesquisa em medicina, química e remediação ambiental, prometendo impactos transformadores em escala industrial.
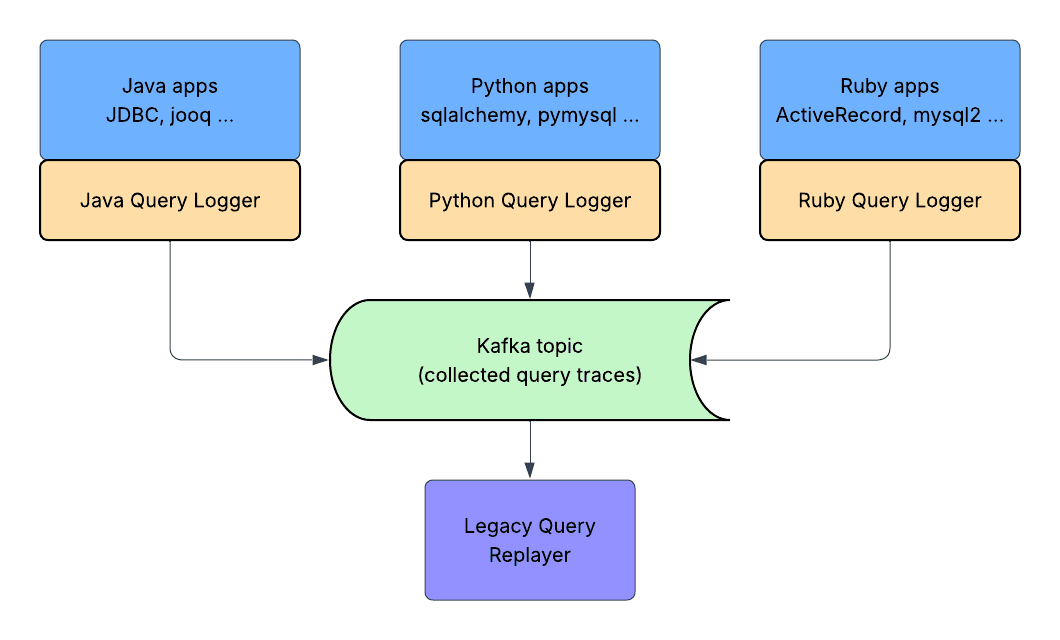
O Airbnb deu um salto na validação de performance de seus bancos de dados, especialmente MySQL, ao desenvolver um sistema capaz de capturar e replicar cargas de trabalho de produção. A nova abordagem minimiza a dependência de benchmarks sintéticos, permitindo que consultas reais sejam registradas com baixo impacto e reproduzidas fielmente, mantendo a ordem e o timing originais. Essa inovação é crucial para identificar regressões sutis em atualizações, migrações e planejamentos de capacidade, oferecendo uma visibilidade sobre o comportamento do sistema que testes convencionais não conseguiriam.