A IBM Research apresentou o Granite Timeseries Ensemble: quatro modelos Granite abertos, uma interface extensível de forecasting e menos tentativa e erro na escolha do modelo. Modelos pré-treinados de séries temporais fazem previsões sem treinar no seu dataset, mas ainda é preciso escolher um. Um modelo bom com sinais industriais suaves pode ter dificuldade com demanda de varejo ruidosa ou horizontes sazonais longos. A proposta é um default sensato: uma receita que combina quatro arquiteturas Granite complementares e retorna previsões de mediana e de quantis, sem retreinamento e sem pesos de ensemble ajustados. A IBM sugere começar pelo Probabilistic Ensemble (uniform probability pooling), comparar com o IQR Ensemble (Inter Quartile Range) adaptativo e estender a interface com forecasters compatíveis. A receita e seus membros Granite padrão têm licenciamento permissivo. A ideia vem da previsão do tempo, onde ensembles exploram uma faixa de resultados possíveis e sistemas como o North American Multi-Model Ensemble combinam modelos diferentes. Em séries temporais, modelos complementares dão visões distintas do que vem a seguir, e o ensemble as une em uma única previsão. A receita armazena a configuração do ensemble, não pesos mesclados, e baixa os quatro checkpoints em runtime, então a primeira execução é mais lenta. result.prediction_outputs traz a previsão pontual e result.quantile_outputs, os quantis, por padrão de 0,1 a 0,9. Os quantis 0,1 e 0,9, por exemplo, definem um intervalo central com cobertura nominal de 80%. O Probabilistic Ensemble, recomendado como default, dá influência igual a cada membro, combina os quantis no espaço de probabilidade e extrai os pedidos, sem etapa de ajuste nem hiperparâmetros de ponderação. O IQR Ensemble pondera os membros pela dispersão das previsões, dando mais peso a intervalos mais estreitos. Os pesos variam por amostra, alvo e passo do horizonte, nada é ajustado a partir de erros históricos e regressão isotônica evita o cruzamento dos quantis combinados.
Na GTC Berlin, bancos, empresas de pagamento e provedores de dados financeiros mostraram IA em escala de produção: construída sobre a computação acelerada da NVIDIA, baseada em modelos open weight e rodando em infraestrutura própria. A Revolut está reconstruindo seu stack sobre um único foundation model, o PRAGMA, desenvolvido em colaboração com a NVIDIA. Com o toolkit cuDF e o software Dynamo-Triton em GPUs Blackwell Ultra, a empresa escala o modelo em produção para atender inicialmente 80 milhões de clientes, com projeto para escalar 3x. Para Pavel Nesterov, head de IA da Revolut, o PRAGMA é a prova mais clara de que a distância entre um avanço de pesquisa e um sistema bancário em produção pode ser superada. No treinamento, o Starling Bank, primeiro banco a treinar um modelo agentic em nuvem soberana do Reino Unido, desenvolveu o Starling Intelligence na nuvem da Civo, com dados de transações do próprio banco. O Lloyds Banking Group criou o ATUM, foundation model de transações que converte bilhões de transações em inteligência reutilizável, acelerado com GPUs RTX PRO 6000 Blackwell. A SBS lançou uma plataforma de inteligência soberana para bancos executarem modelos generativos e agentic sem que os dados saiam de sua infraestrutura. Sobre modelos abertos e custo: o assistente agentic Finn, do neobank bunq, agora roda em modelos open weight na Nebius e, segundo o texto, iguala a qualidade dos principais modelos fechados a 60% do custo por resposta. O NatWest desenvolve tecnologia para reconhecer sotaques, dialetos e terminologia financeira britânicos com modelos de fala da NVIDIA, incluindo o Nemotron 3.5 ASR. A Modulr constrói modelos especializados para partes distintas das operações de pagamento, com base no modelo aberto Nemotron-3-Ultra-550B. O Santander é early adopter da nova família NVIDIA Kumo de foundation models open weight para dados financeiros estruturados, usada em cargas de trabalho do core banking. Em pesquisa financeira, a LSEG trabalha com a NVIDIA para analisar grandes volumes de dados históricos de tick até 10x mais rápido com o Polars GPU engine, acelerado por cuDF em GPUs RTX PRO 6000 Blackwell. A RavenPack criou na Bigdata.com um pipeline que transforma uma hipótese de pesquisa em linguagem natural em um dataset rotulado, pronto para backtest, rodando em um modelo Nemotron com fine-tuning. Em detecção de fraude, o HSBC oferece insights de clientes quase em tempo real, com processamento de dados 5x mais rápido no GPU Engine da Starburst Enterprise. A Stripe relata pipelines de dados 42x mais rápidos e 92% de economia de custos no Stripe Radar com o Ray Data acelerado por GPU da NVIDIA, em testes offline.
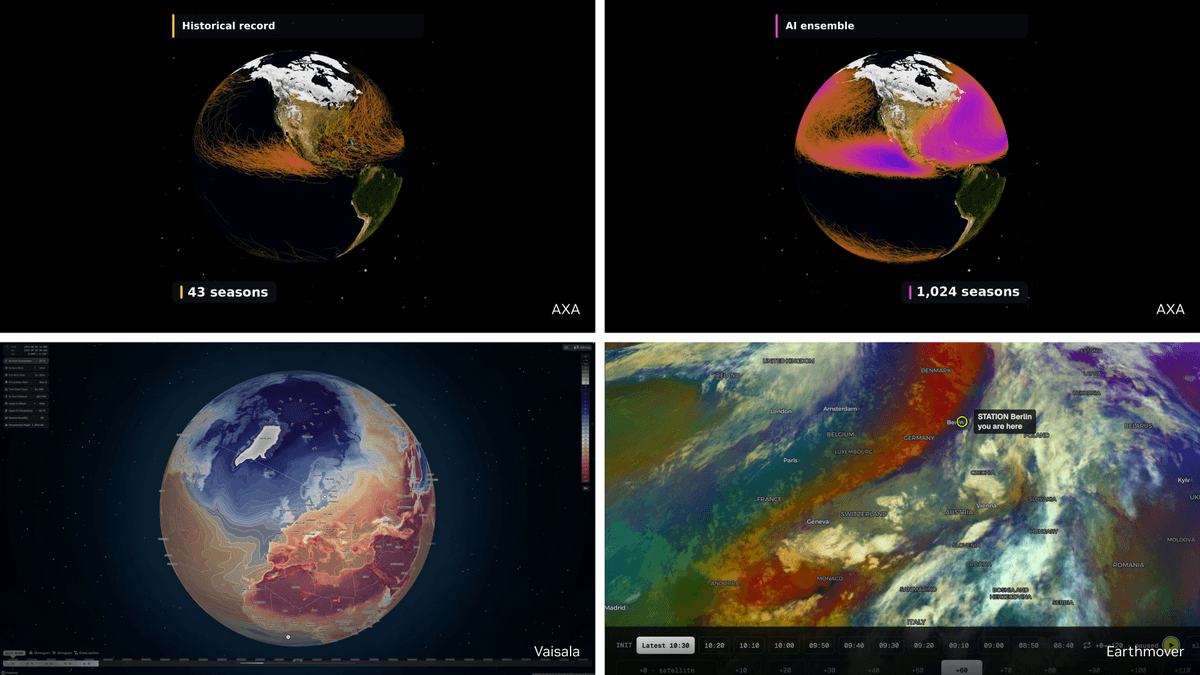
Previsões do tempo pesam em decisões de produtores de energia, seguradoras e operadoras de transporte. Uma previsão global pode indicar a formação de uma tempestade, mas escolhas sobre usinas solares, rotas marítimas ou imóveis segurados dependem do que ocorre localmente. O NVIDIA Earth-2 oferece a desenvolvedores e pesquisadores uma família de modelos de IA abertos e ferramentas que podem ser personalizados com dados próprios. Executados em infraestrutura NVIDIA, dão suporte a previsão global, previsões regionais detalhadas e pesquisa ambiental. O mais recente é o StormScope EU, versão regional do StormScope para previsão de curto prazo, treinada com dados de tempo e clima da Europa. Ele usa observações de satélite da EUMETSAT para prever a evolução da cobertura de nuvens em 16 canais do Meteosat, em intervalos de 10 minutos. Na GTC Berlin, a NVIDIA exibe um pipeline StormScope EU ao vivo em demo interativa feita com a Earthmover, que usa o Earth2Studio para rodar as previsões e sua plataforma de dados para gerenciar e servir os resultados em tempo real, como map tiles. Desenvolvedores podem combinar modelos do Earth-2, com StormScope para curto prazo e CorrDiff para adicionar detalhe local a dados meteorológicos de menor resolução, e treinar as arquiteturas para novos usos, como qualidade do ar, com o framework open source NVIDIA PhysicsNeMo. Entre os exemplos: a AXA usa o FourCastNet 3 para estudar risco regional de ciclones em mais de 1.000 temporadas simuladas; a Vaisala Xweather combina o Earth-2 com observações e dados de raios para ampliar a antecedência de alertas de curto prazo; pesquisadores da University of Manchester adaptaram o CorrDiff para qualidade do ar no Reino Unido, treinando no supercomputador Isambard-AI e rodando localmente em sistemas NVIDIA DGX Spark; a TotalEnergies avalia nowcasts de radiação solar baseados no StormScope em dois sites fotovoltaicos; e a Space42 desenvolveu o SARDiff4Height, que estima alturas de superfície a partir de uma única imagem de radar e gera mapas de incerteza.
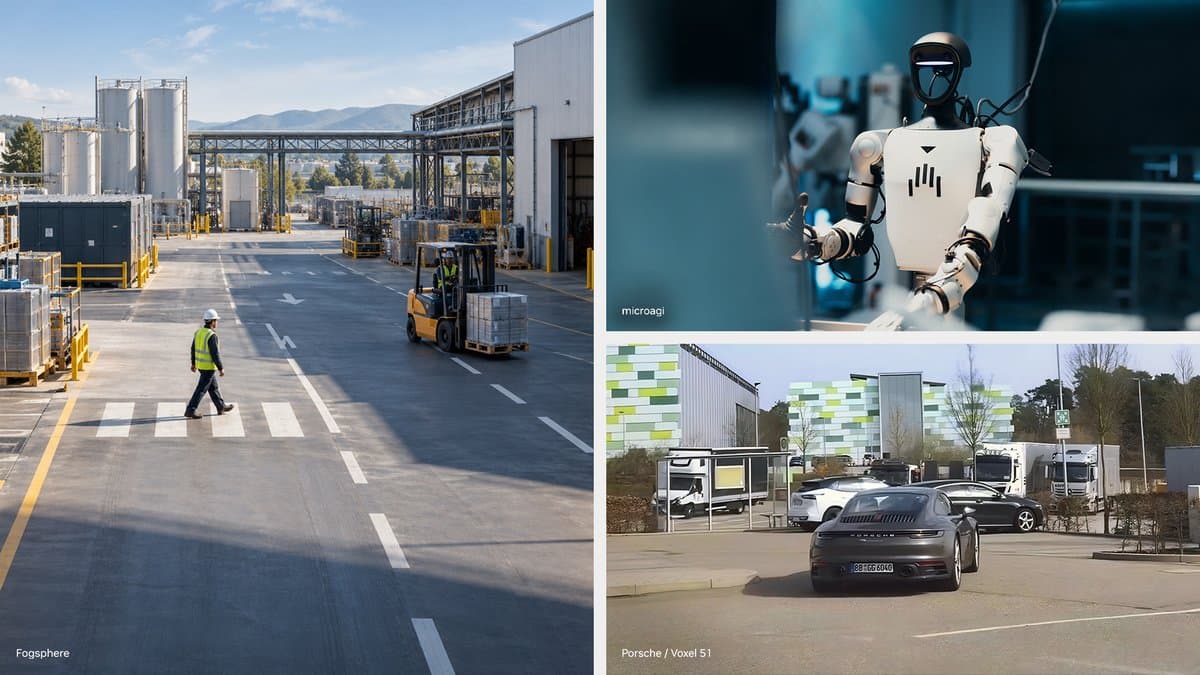
Para ajudar desenvolvedores a criar world models, que permitem a sistemas de IA física entender e simular o mundo real, a NVIDIA expandiu a plataforma Cosmos com novas ferramentas de treinamento, checkpoints de simulação e blueprints do Cosmos Data Factory. Segundo a empresa, a plataforma está entre as cinco primeiras colocadas em seis leaderboards de modelos abertos e oferece modelos abertos frontier, dados, ferramentas de treinamento e otimização e recipes para escalar dados de treino, adaptar modelos, testar comportamento e otimizar desempenho antes do deploy. O Cosmos Data Factory reúne ferramentas para rotular, curar, aumentar e avaliar dados em escala. O Cosmos Curator, solução acelerada por GPU para curadoria de datasets de vídeo, agora aceita entradas e blocos de processamento multimodais e multissensoriais. São cinco blueprints cloud-native, disponíveis via GitHub, Microsoft Azure, Nebius e CoreWeave: geração de datasets para veículos autônomos, aumento de atributos de imagem, geração de vídeos de eventos raros ou inseguros a partir de imagens estáticas, geração de imagens de defeitos (placas de circuito impresso, metal e vidro) e aumento de dados de vídeo com alteração de clima e iluminação. A Porsche lidera o desenvolvimento de um data flywheel de veículos autônomos compartilhado entre marcas do Volkswagen Group, usando o Cosmos Data Factory via Voxel51 no Microsoft Azure. A expectativa é reduzir testes físicos repetidos em até 90% e o tempo de ciclo de desenvolvimento em até 85%. A ANYbotics gerou mais de 1.500 clipes de vídeo sintéticos para treinar robôs de inspeção industrial, e a Ultralytics retreinou seu modelo YOLO com imagens reais e defeitos sintéticos, melhorando localização de defeitos e recall. Na GTC Berlin, a NVIDIA estendeu as ferramentas e recipes de treinamento, otimização e deploy do Cosmos Framework, como agent skills, a mais modelos abertos, junto com o Cosmos 3. Desenvolvedores e agentes já podem adaptar modelos como GR00T, Alpamayo, QWEN, Pi0.5 e outros modelos compatíveis da Hugging Face via fine-tuning e reinforcement learning, otimizar com distillation e quantization e fazer deploy com inference de alto desempenho. A MicroAGI fez post-training do Cosmos 3 com vídeos de humanos manipulando objetos e destilou seu reasoner de 32 bilhões de parâmetros para um modelo Nano de 8 bilhões, sem perda de acurácia. No Roboflow, é possível rotular dados e fazer post-training do Cosmos 3 para ambientes e tarefas específicos, com deploy hospedado ou em GPUs NVIDIA on-premises.
A Cloudflare usa o OpenAI Daybreak, somado a tráfego ao vivo e sinais de segurança, para investigar vulnerabilidades e sugerir correções que os clientes podem revisar. Com uma das maiores redes do mundo, que faz proxy de cerca de 20% do tráfego da web, a empresa lançou em early access o Vulnerability Discovery and Remediation, dentro do Managed Defense. Os modelos da OpenAI analisam o código autorizado pelo cliente, e a Cloudflare prioriza os achados, valida e prepara patches e regras personalizadas de WAF para reduzir a exposição enquanto o time corrige. Verificações automatizadas e revisão humana antecedem o envio, e o cliente decide o que implementar. O Codex também chegou à engenharia interna: segundo Anderson, um terço da empresa é de desenvolvedores, e 100% deles usam a ferramenta. Uma reconstrução de produto adiada por falta de pessoal foi assumida por quatro devs com Codex e concluída em três dias, com implantação e testes, a US$ 1.100 em tokens. Antes, exigiria meses de planejamento e talvez 10x mais gente.
A OpenAI liderou, nos últimos dois meses, uma coalizão de maintainers, pesquisadores e provedores de segurança para tratar vulnerabilidades críticas no PHP. A Calif achou uma falha com o GPT‑5.6 Sol, no programa Patch the Planet, e a Wiz reportou de forma independente as duas brechas. Os maintainers do PHP lideraram correções e release, com apoio de OpenAI, Wiz, Cloudflare e outros. Para quem usa PHP, a prioridade é atualizar: a OpenAI compartilha um PHP version checker e lançará uma skill do Codex. A empresa vê a IA frontier chegando antes dos atacantes, criou a Defender’s Window e prometeu US$ 1 bilhão em acesso subsidiado ao Daybreak for Frontline Defenders. Também propõe um framework de cinco etapas, que começa por validar e corrigir a falha upstream com testes adversariais e dar tempo para as organizações agirem.
A OpenAI diz que vivemos uma "janela dos defensores": a chance de colocar IA avançada nas mãos de quem protege sistemas antes que capacidades ofensivas se espalhem. A empresa publicou um blueprint com propostas para governos e indústria em três frentes: reforçar a safety e a segurança de modelos e agentes frontier, com controles de desligamento confiáveis; modernizar a cibersegurança, com ferramentas, treinamento e troca de sistemas obsoletos; e criar instituições públicas resilientes, com avaliações independentes, reporte de incidentes e resposta coordenada. Citando sua própria experiência com misalignment e incidentes, a OpenAI pede que formuladores de políticas ajam agora e endureçam as regras conforme a tecnologia evolui.
OpenAI, PerturbAI e Scripps Research colocaram milhares de agentes de IA com GPT‑Rosalind para trabalhar em paralelo sobre dados de milhões de células cerebrais de camundongos. Cada agente investigou uma disrupção gênica do whole-brain CRISPR atlas, cruzou os resultados com a literatura científica e propôs mecanismos biológicos. Em 32 minutos, o que levaria de meses a um ano para humanos gerou um reasoning atlas, que reproduziu achados anteriores e apontou novidades, como diferenças entre dois genes ligados a doenças e uma possível ligação entre colesterol e neurodegeneração. Em avaliação cega, especialistas concordaram com a análise dos agentes sobre novidade e valor científico. O atlas já está disponível.
Na publicidade tradicional, cada busca ou página vista é um evento isolado. No ChatGPT, a intenção do usuário evolui ao longo de vários turnos, sem um momento claro para anunciar. Por isso, a OpenAI criou um sistema próprio, baseado em um LLM frontier customizado e pós-treinado, que usa tool calls para retrieval, ranking, relevância e leilões. O desenho se apoia em três pilares: sessões de anúncios stateful, que lembram informações entre turnos e conversas; um LLM que interpreta contexto e intenção; e a seleção de anúncios em serviço separado da geração de respostas, para preservar a neutralidade do ChatGPT. Segundo a empresa, o ChatGPT Ads chegou a US$ 1 bilhão em receita anualizada em menos de 200 dias, com mais de 100 mil anunciantes. Tratar cada mensagem como requisição isolada geraria erros de interpretação, anúncios precoces ou intrusivos, além de ruído e custo.
A OpenAI ampliou o ChatGPT Ads para mais 26 países, chegando a 89 mercados. Em pouco mais de oito meses, mais de 100 mil anunciantes já veicularam campanhas na plataforma, que tem mais de 1,2 bilhão de usuários semanais. Após México e Brasil, entram 14 países da América Latina, como Argentina, Chile, Colômbia e Peru, além de Nigéria, África do Sul, Sérvia, Ucrânia, Camboja, Bangladesh e Paquistão. O acesso é por parceiros de tecnologia ou self-service no Ads Manager. Anúncios aparecem só nos planos Free e Go, e a empresa diz que conversas ficam privadas, dados não são vendidos e a publicidade não influencia as respostas. Novos formatos e métricas estão no radar.
A IBM atualizou a coleção Granite Speech com três modelos: o novo granite-speech-5.0-2b, o Turbo CTC multilíngue (470M) e o granite-speech-4.1-2b-plus revisado. O 5.0-2b, sob Apache 2.0, transcreve seis idiomas, inclusive português, foi treinado com 390 mil horas de áudio e ficou em 2º lugar entre os modelos open-weight no Open ASR Leaderboard (WER de 5,06% em inglês). O Turbo CTC chegou a 19.870 RTFx, cerca de 1,6x mais rápido, com pontuação nativa. Já o 4.1-2b-plus reduziu em 7% os erros de diarização e em 24% o WER em fala longa.
No Partner Connect, durante o Google Public Sector Summit, o Google anunciou quatro pilares para turbinar sua rede de parceiros. Há incentivos para quem assume a pré-venda e o Partner-Led User Success Program, que reúne uma academia de Forward Deployed Engineers (FDE), mais fundos de aceleração de negócios e um fundo de implantação ampliado para US$ 45 milhões, para levar o Gemini a todo o setor público dos EUA. Para desenvolvedores, chegam o ISV Agent Factory e o ISV ATO Accelerator, com até US$ 1 milhão por ISV para custear credenciamentos como GovRAMP, FedRAMP e DoD Impact Level. Completam o pacote a aliança com a SHI, que ativa mais de 400 vendedores, e os Gemini Launchpads da Accenture Federal Services, para tirar agentes de IA da experimentação e levá-los à execução de missões.
A ZenteiQ, startup de IA nascida no Indian Institute of Science (IISc) e escolhida pela IndiaAI Mission para criar modelos de fundação científicos soberanos, usou o GKE e o GKE Inference Gateway para turbinar seu pipeline de dados sintéticos em lote. O throughput agregado de inference subiu 4,07x: de 1,47 bilhão para 5,97 bilhões de tokens por dia a cada 1.000 aceleradores. O gargalo estava no round-robin padrão via ClusterIP, que ignorava a carga das engines vLLM e espalhava prompts com 70% a 80% de contexto em comum, desperdiçando cache de prefixos. Resultado: oscilações de até 50% no throughput e treinamentos atrasados.
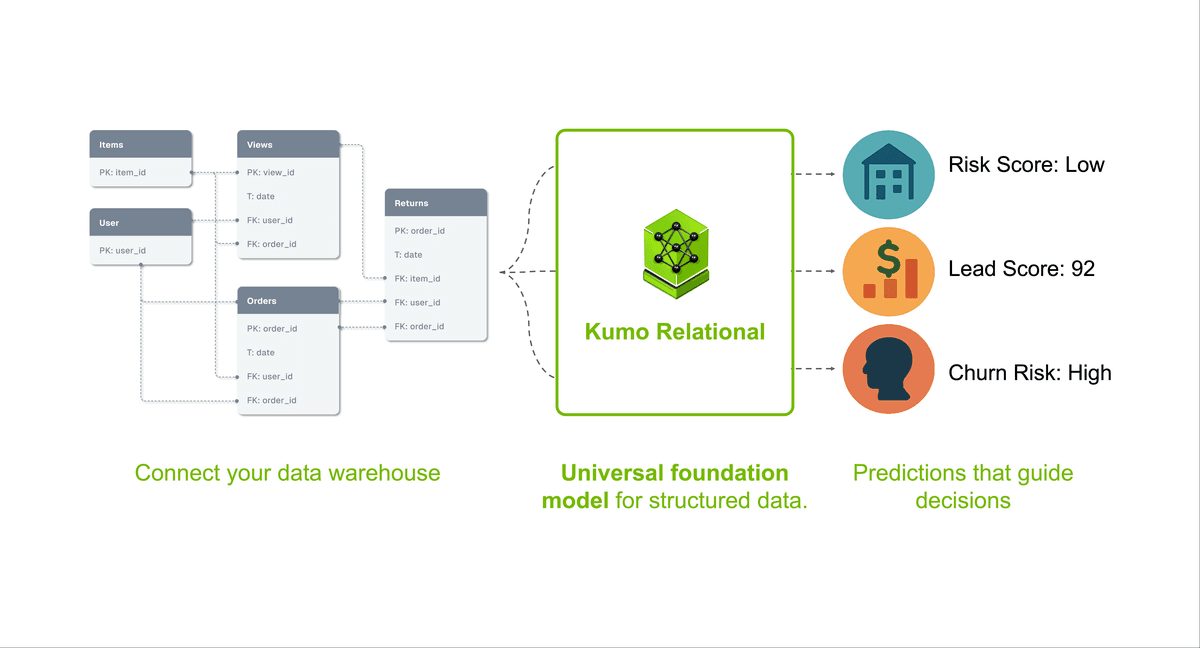
A NVIDIA apresentou o Kumo Relational, foundation model relacional pré-treinado que faz previsões como churn, demanda e fraude direto em bancos corporativos, num único forward pass, sem treinamento por tarefa, feature engineering ou achatamento de tabelas. A partir de uma predictive query, usa até 10.000 exemplos históricos como contexto (in-context learning). Em 41 tarefas de 15 bancos, supera modelos supervisionados e gradient-boosted trees com features de especialistas. No SAP SALT, bate o AutoGluon em 8% no MRR. Escala a mais de 500 bilhões de linhas, atende humanos e agentes via PQL, e está na biblioteca open-source de structured-data-models ou como NVIDIA NIM.
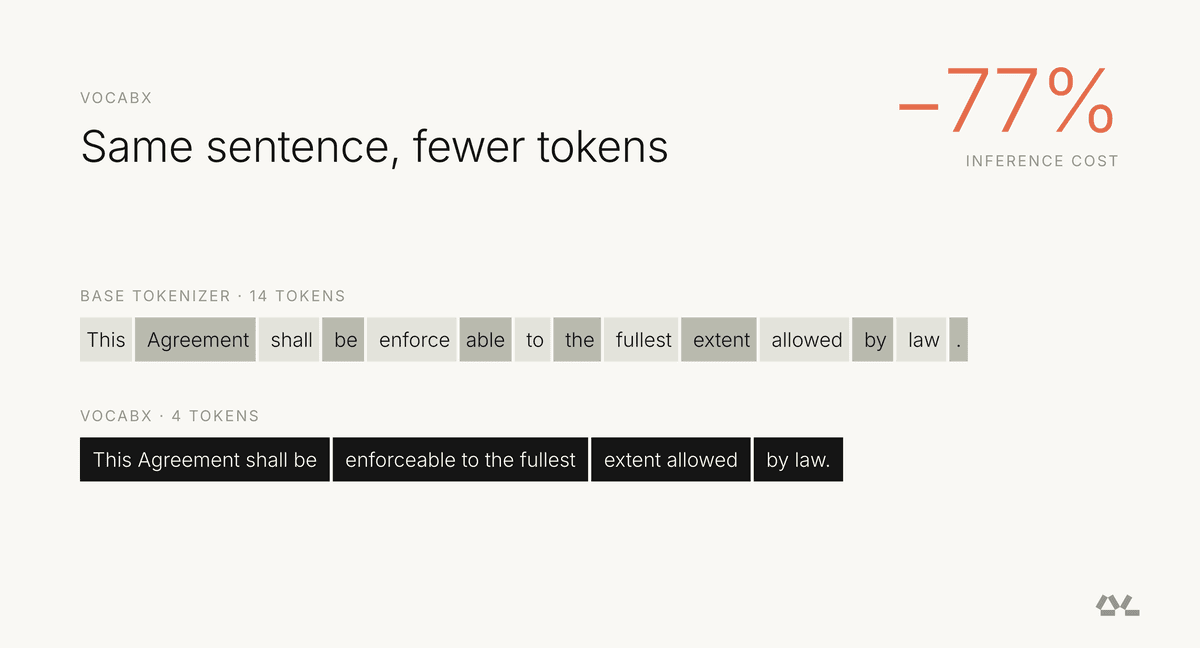
Modelos ajustados via fine-tuning a partir de open-source como Qwen e Gemma herdam um tokenizer feito para vários domínios. No corretor de redações em produção, baseado no Qwen3-4B, isso fragmentava justamente o texto que o modelo mais escreve, como o envelope JSON e os nomes das competências, e ainda obrigava a calcular pontuações para 151.669 entradas a cada token. O paper VocabX, ainda em revisão, especializa o vocabulário pelo custo de cada token, e não pela frequência, e reduz em 77% o custo de inference medido, sem mexer no modelo base. Os números podem mudar. No decode, o gargalo é a largura de banda de memória, o que pesa mais em modelos pequenos.
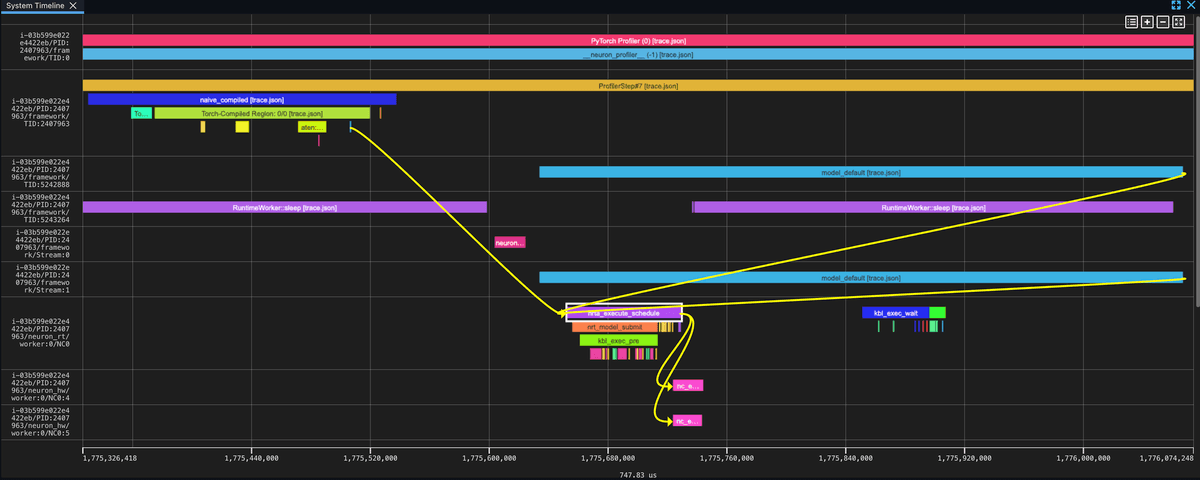
Muita gente em ML sabe como deixar um modelo mais rápido, mas poucos sabem diagnosticar por que ele está lento. A Parte 1 da série ensina, do zero, a analisar a performance de inference no AWS Trainium com o TorchNeuron, backend nativo open source para PyTorch que suporta eager execution e torch.compile e se integra ao NKI. O passo a passo cobre a configuração do torch.profiler, a leitura de key_averages() e o rastreio de uma operação no Neuron Explorer, do framework ao NeuronCore. O caso de estudo compara três versões do RMSNorm: naive, torch.rms_norm() fundido e naive com torch.compile.
A OpenAI passou meses alinhando políticas de safety com clientes e parceiros que oferecem seus modelos, como o GPT‑6 Astra, e atualiza as Usage Policies para deixar as regras mais claras aos desenvolvedores. A empresa avalia riscos antes do deploy, testa se as salvaguardas resistem a tentativas de burlá-las e monitora abusos depois, inclusive em cibersegurança. Parceiros que hospedam ou revendem os modelos devem manter salvaguardas equivalentes e investigar violações. A partir de 20 de novembro de 2026, serviços como model routers e AI gateways precisarão de revisão e aprovação prévias da OpenAI. Também chegam os SafetyIDs, que distinguem usuários finais em investigações sem revelar identidades.
O jurídico da AT&T, com centenas de profissionais pelo mundo, quer facilitar o acesso à experiência espalhada entre equipes. Em parceria com a OpenAI, a partir do LegalEdge, a empresa constrói a estrutura da camada de conhecimento corporativa. Entre as iniciativas está um sistema de intake em linguagem natural, que classifica e prioriza pedidos, conecta precedentes e pesquisas e sugere primeiros passos aos advogados. O objetivo é ampliar a escala do julgamento jurídico. Segundo o General Counsel David McAtee, a decisão continuará com os advogados.
A Mistral AI eleva o patamar da IA conversacional com o lançamento do Voxtral 3, que integra capacidades avançadas de speech-to-text e text-to-speech em mais de 50 idiomas. A suíte inclui o Small Transcribe 3 para transcrição multilíngue precisa e o Mini TTS 3, que gera fala com entonação emocional natural. Destaca-se também o SDK de agente de voz, que permite interações em tempo real, escutando, raciocinando e falando, e a execução de tarefas complexas via telefone ou web, prometendo revolucionar a comunicação entre humanos e máquinas.
O mundo da IA celebra uma novidade de peso: Google e Meta lançam o TorchTPU, um backend de código aberto que promete revolucionar o uso de PyTorch em Unidades de Processamento Tensor (TPUs) do Google. Com essa integração, desenvolvedores terão mais facilidade para treinar e executar inferências de modelos de IA, aproveitando a otimização da execução eager e o poderoso compilador torch.compile. A iniciativa visa simplificar a migração e o desempenho em hardware dedicado, acelerando o desenvolvimento e a implantação de soluções de IA de ponta.