
NVIDIA Kumo Relational prevê direto no banco de dados e supera ML supervisionado, sem treinar
Aprofundamento CEVIU
Aprofundamento
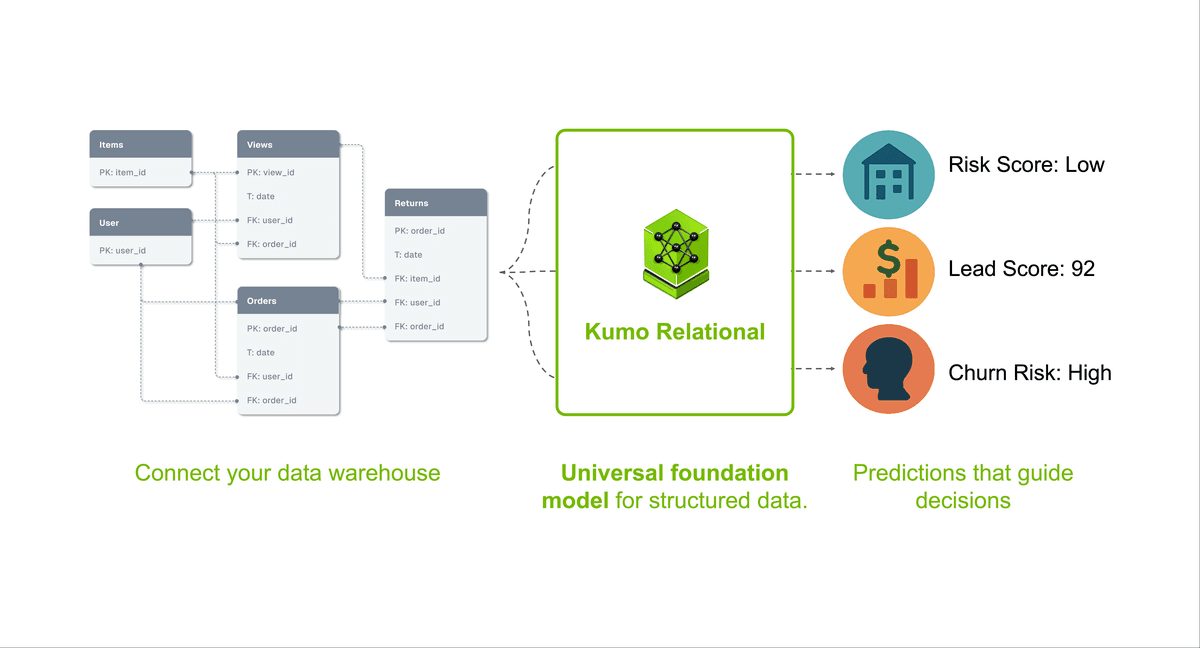
O ponto central do Kumo Relational é abandonar a tabela achatada. A maioria dos modelos fundacionais para dados estruturados trabalha com uma tabela única. Aqui o modelo lê o banco como ele é, com tabelas, chaves estrangeiras e timestamps. Cada exemplo de contexto é um subgrafo local em torno de uma entidade num ponto do tempo, pareado com o resultado real ("este usuário deu churn"). São até 10.000 exemplos lidos na hora da inferência, sem treino por tarefa.
A arquitetura tem duas etapas. Uma rede leve processa cada tabela com atenção de coluna e de linha. Depois, uma rede maior distribui os embeddings de linha pelas relações de chave primária e estrangeira, com atenção de grafo e atenção entre amostras de contexto. Como essa etapa opera sobre embeddings de linha e não sobre cada célula, o custo não explode de forma quadrática. O pré-treino usa só dados relacionais sintéticos, gerados com a abordagem do PluRel. A pergunta vem em PQL (Predictive Query Language), e o replay de estados históricos do banco evita vazamento de dados. A NVIDIA também admite limites: em tarefas com conjuntos de treino enormes, modelos supervisionados ainda podem levar vantagem, e o fine-tuning existe para esse caso.
O que mudou
A Kumo já tinha apresentado o KumoRFM-2, em 16 de abril de 2026, como modelo fundacional relacional que prevê direto das tabelas, sem o pipeline usual de feature engineering. Agora a ideia aparece com a NVIDIA: pesos abertos, biblioteca open-source de structured-data-models em GPU e distribuição como NIM. O discurso saiu do produto da Kumo e foi para a infraestrutura da NVIDIA, com benchmarks em 41 tarefas e 15 bancos.
Por que isso importa
Dados tabulares e relacionais são onde bancos e varejo tomam decisões de verdade. A corrida não é só da Revolut (modelo PRAGMA, 27 de abril de 2026) ou do Google (TabFM, 3 de julho de 2026). Se uma previsão vira uma query e não um projeto de semanas, o custo de operar ML cai e agentes ganham a capacidade de antecipar eventos, não só de ler e escrever.
Linha do tempo
Mastercard revela modelo fundacional treinado em bilhões de transações anonimizadas.
Kumo apresenta o KumoRFM-2, modelo fundacional relacional para previsões.
Revolut apresenta o PRAGMA, modelo de fundação para finanças.
Google lança o TabFM, modelo zero-shot para dados tabulares.
NVIDIA apresenta o Kumo Relational, que prevê direto no banco sem treino por tarefa.
Perguntas frequentes
O que é o NVIDIA Kumo Relational?
É um foundation model relacional pré-treinado que faz previsões direto em bancos de dados corporativos. Ele prevê churn, demanda ou fraude num único forward pass. Não exige treino por tarefa, feature engineering nem achatamento de tabelas.
Como ele prevê sem treinar?
Usa in-context learning. A partir de uma predictive query em PQL, o sistema reúne até 10.000 exemplos históricos com seus resultados e os entrega ao modelo como contexto. O modelo foi pré-treinado uma única vez em dados relacionais sintéticos.
Ele realmente supera ML supervisionado?
Nos benchmarks da NVIDIA, sim. Em 41 tarefas de 15 bancos, supera modelos supervisionados e árvores com features de especialistas. No SAP SALT, bate o AutoGluon em 8% no MRR. Em tarefas com treino muito grande, modelos supervisionados ainda podem se sair melhor.
Como posso usar o modelo?
Pela biblioteca open-source structured-data-models, que baixa os pesos do Hugging Face Hub, ou como NVIDIA NIM com um cliente open-source. O código sai sob Apache 2.0 e os pesos sob a OpenMDW License, versão 1.1.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU IA