
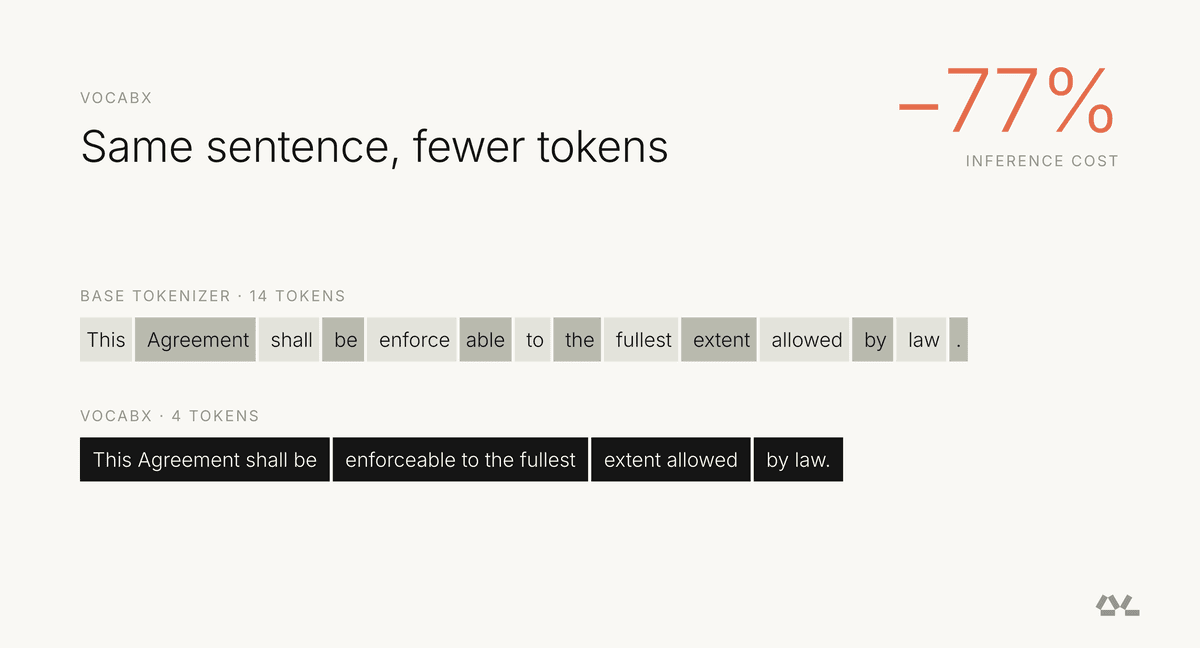
Vocabulário sob medida: como enxugar o tokenizer de SLMs derruba em 77% o custo de inference
Aprofundamento CEVIU
Aprofundamento
O ponto central do VocabX é trocar a pergunta. Em vez de contar quantos tokens um candidato economiza, o método pergunta quanto de custo e tempo ele economiza. Cada token eliminado é multiplicado pelo preço do campo onde aparece (prompt de sistema, mensagem do usuário ou resposta). No corretor de redações, um token gerado custa 7,4 vezes um token lido. Isso acontece porque o decode é limitado pela largura de banda de memória: a cada token gerado, o modelo relê pesos e KV cache. A razão varia com hardware, batch e contexto, e pode ser maior.
O vocabulário também pesa direto na conta. No Qwen3-4B, a camada LM head responde por quase 10% dos parâmetros e é lida inteira a cada token gerado. No corretor, ela caiu de cerca de 152 mil para cerca de 65 mil linhas. A resposta média foi de 350 para 101 tokens, o custo caiu 77,0% e o bench score subiu de 0,703 para 0,810. Os números vêm de uma versão do paper ainda em revisão e podem mudar.
O que mudou
A cobertura anterior do CEVIU tratava de custo de tokens pelo lado do contexto, como em "Context Pruning: Reduza Tokens de LLMs Sem Perder Qualidade" (20 de maio de 2026), e do texto, como em "Compressão de Conhecimento" (26 de agosto de 2026). Aqui o corte vai para o tokenizer, definido antes de qualquer passo de treino. Em "Tokenização Compute Optimal" (13 de maio de 2026), o foco era como bytes por token afetam a alocação de compute. O VocabX leva a ideia para um modelo já ajustado e usa o custo de cada token como critério.
Por que isso importa
Para quem roda SLMs em produção, o tokenizer herdado do modelo base costuma ficar intocado. O caso mostra que ele pode ser uma das maiores alavancas de custo, sem trocar o modelo. Um aviso do próprio texto: comprimir demais custa qualidade. A versão que fundiu a nota com o JSON em um único token teve bench score de 0,689, abaixo dos 0,703 da produção.
Linha do tempo
Cobertura sobre tokenização compute optimal e bytes por token.
Cobertura sobre Context Pruning para reduzir tokens de LLMs.
Cobertura sobre compressão de conhecimento e custo de tokens.
VocabX apresenta vocabulário sob medida que corta 77% do custo de inference no corretor de redações.
Perguntas frequentes
O que é o VocabX?
É um método, descrito num paper ainda em revisão, que especializa o vocabulário de um modelo para um domínio. Ele escolhe tokens pelo custo de servi-los, não pela frequência. O modelo base, os dados e a receita de treino ficam iguais.
Por que gerar token custa mais que ler?
Na leitura (prefill), cada peso lido da memória da GPU é reaproveitado para todos os tokens de entrada. Na geração (decode), cada token exige uma passagem completa e a GPU espera dados da memória. No corretor medido, o token gerado custou 7,4 vezes o lido.
Quais resultados o corretor de redações teve?
A resposta caiu de 350 para 101 tokens em média e o custo medido caiu 77,0%. O bench score subiu de 0,703 para 0,810. Os testes usaram 500 requisições numa RTX 5090 com vLLM.
Esses números já são definitivos?
Não. O próprio artigo diz que os números vêm da versão atual do paper, ainda em revisão, e podem mudar antes da publicação.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU IA