
Por que seu modelo está lento? Guia de profiling do TorchNeuron no AWS Trainium
Aprofundamento CEVIU
Aprofundamento
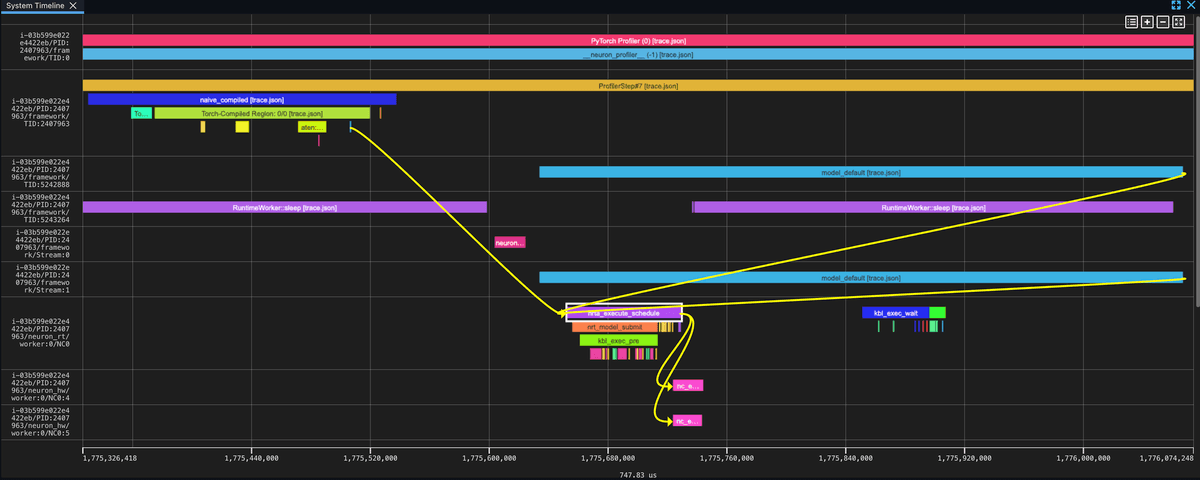
O guia da Parte 1 parte de uma ideia simples: todo mundo quer modelo rápido, pouca gente sabe achar onde o tempo vai. O exemplo é o RMSNorm em três versões. Na naive, cada linha vira uma operação ATen separada (três aten::mul, mais mean, add e rsqrt), e o total de tempo no Neuron foi de 2,355 ms. Com torch.rms_norm(), que o Neuron reduz a um único kernel fundido, caiu para 403,3 μs. Com o código naive sob torch.compile (backend neuron), ficou em 375,5 μs.
O ponto técnico é o despacho. No modo eager, cada operação cruza a fronteira de dispatch sozinha: framework, depois nrta_execute_schedule no runtime, depois nc_exec_running no hardware. Na versão fundida ou compilada, sobra um despacho e um evento de hardware, sem os intervalos entre operações e sem materializar intermediários como x_sq e mean_sq. O backend usa o ponto de extensão PrivateUse1 do PyTorch e, para ver tempo de device na tabela, é preciso correlate_device_time=True, ProfilerActivity.PrivateUse1 e um torch.neuron.synchronize() no loop. Sem o synchronize, a coluna de tempo Neuron pode vir vazia.
O que mudou
A cobertura anterior do CEVIU já tinha apresentado o TorchNeuron em 20 de outubro de 2026, na matéria sobre o backend nativo open source que liga o PyTorch ao AWS Trainium. Dois dias depois, a promessa de integração ganha uso prático: como medir e diagnosticar performance nesse backend. A lógica também repete a série de profiling no PyTorch de junho de 2026, que usava o torch.profiler em GPU/CPU e chegou à fusão de um MLP na Parte 2. Agora o mesmo raciocínio de achar o hotspot e testar fusão vale para o Trainium.
Por que isso importa
Sem diagnóstico, otimizar vira chute. O fluxo do guia (achar o hotspot na tabela, confirmar no trace, testar fusão ou torch.compile) serve para modelos maiores. Nas execuções mostradas, fusão e compilação ficaram em cerca de um sexto do tempo de device da versão naive.
Linha do tempo
CEVIU cobre a Parte 1 de profiling no PyTorch com torch.profiler.
Parte 2 do profiling no PyTorch trata da transição de nn.Linear para um MLP fused.
TorchNeuron é apresentado como backend nativo open source do PyTorch para o AWS Trainium.
Guia de profiling do TorchNeuron no Trainium compara três versões do RMSNorm.
Perguntas frequentes
O que é o TorchNeuron?
É o backend nativo open source do PyTorch para o AWS Trainium. Ele suporta eager execution, torch.compile e as APIs padrão do PyTorch com poucas mudanças de código. Também se integra ao Neuron Kernel Interface (NKI) para operadores customizados.
Como configurar o torch.profiler para o Trainium?
Inclua ProfilerActivity.PrivateUse1 e passe um NeuronConfig como experimental_config. Use correlate_device_time=True para levar o tempo do device à tabela key_averages(). Chame torch.neuron.synchronize() dentro do loop, senão a coluna de tempo Neuron pode ficar vazia.
Qual versão do RMSNorm foi mais rápida no teste?
A naive com torch.compile marcou 375,5 μs, contra 403,3 μs do torch.rms_norm() fundido. A naive sem compilação levou 2,355 ms. Ou seja, as duas abordagens fundidas ficaram em cerca de um sexto do tempo da naive.
O que vem na Parte 2 da série?
A série passa para o perfil no nível do dispositivo. O leitor abre o NEFF, inspeciona o detalhamento de TensorEngine, VectorEngine e DMA, e posiciona o kernel no roofline para saber se ele é limitado por computação ou por memória.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU IA