
Desvendando o Compilador de GPU: Do PyTorch ao CUDA com o Framework Emmy
Aprofundamento CEVIU
Aprofundamento
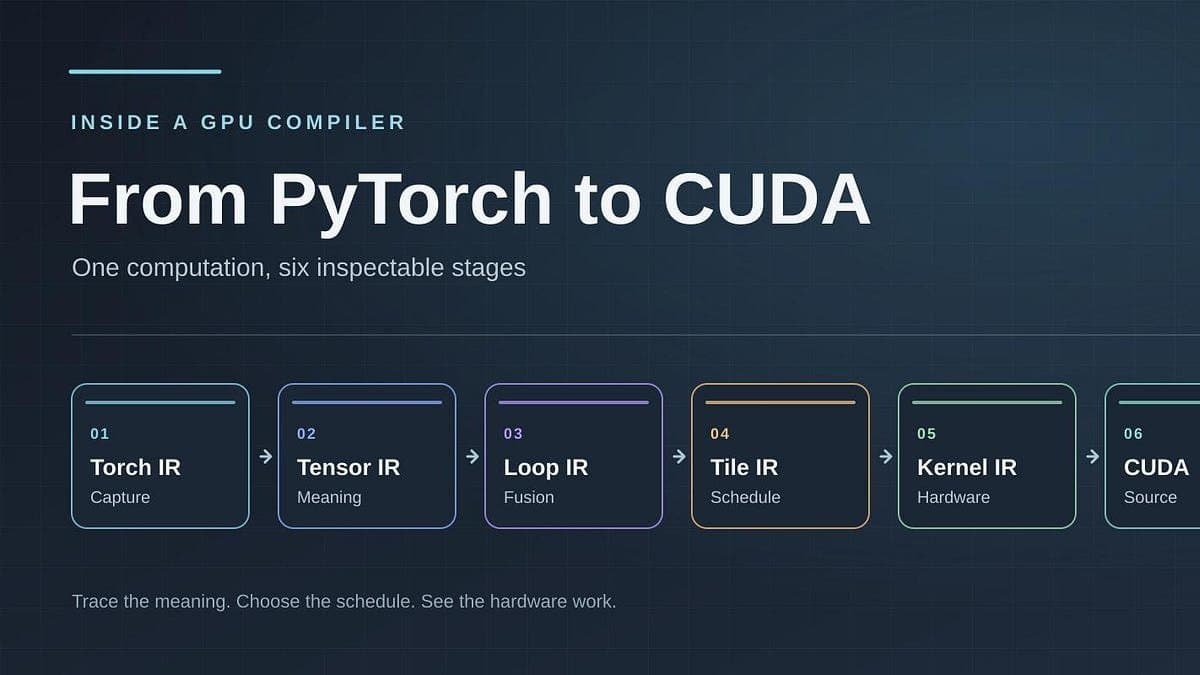
A construção de um compilador de GPU do zero, como detalhado no estudo sobre o framework Emmy, mostra a jornada complexa para traduzir operações de alto nível do PyTorch em código CUDA otimizado. Esse processo, chamado de 'lowering', passa por múltiplas Representações Intermediárias (IRs): Tensor IR, Loop IR, Tile IR e Kernel IR. Cada IR adiciona detalhes e permite otimizações específicas para o hardware da GPU. Por exemplo, o Tensor IR unifica a representação de operações entre diferentes frameworks, enquanto o Loop IR realiza a fusão de operadores para evitar leituras e escritas excessivas na memória.
A Tile IR é onde as decisões específicas da GPU começam, gerenciando a paralelização e o mapeamento para a arquitetura de blocos e warps. Por fim, o Kernel IR está próximo do hardware, descrevendo as operações que serão impressas como código CUDA. Essa metodologia de compilação multi-nível é essencial para alcançar alta performance, permitindo que otimizações como fusão de operadores, mapeamento de memória e autotuning sejam aplicadas de forma granular. Nossas coberturas anteriores, como "O que acontece nos bastidores quando você executa um kernel CUDA na GPU" de 1 de julho de 2026, explicam a execução do CUDA. Este estudo com o Emmy demonstra como o código é cuidadosamente preparado para essa execução.
O que mudou
Enquanto artigos anteriores do CEVIU, como "Profiling no PyTorch (Parte 2): De nn.Linear para um MLP Fused" de 12 de junho de 2026, abordavam a fusão de operadores dentro do próprio PyTorch, o estudo sobre o Emmy leva essa otimização para um novo patamar. Ele mostra como a fusão e outras otimizações são orquestradas por meio de um compilador dedicado, que compreende a arquitetura da GPU em cada etapa do processo de 'lowering'.
A novidade é a explicitação e a gestão de múltiplas Representações Intermediárias (IRs), que permitem não só a fusão, mas também o tiling, o agendamento de tarefas e o autotuning específico para o hardware da GPU. Isso vai além das otimizações intrínsecas ao framework, oferecendo uma compreensão e um controle mais profundos sobre como o código de IA é transformado para execução eficiente em aceleradores.
Por que isso importa
A capacidade de compilar eficientemente operações de PyTorch para CUDA é um fator crítico para o avanço da IA e do aprendizado de máquina. Otimizações detalhadas, como as implementadas pelo Emmy, resultam em melhor desempenho e menor consumo de energia para treinar e executar modelos complexos, como os Transformers, que discutimos em 21 de agosto de 2026.
Para engenheiros de hardware e desenvolvedores de IA, entender e aplicar essa "sopa base" de compiladores de GPU significa criar sistemas mais rápidos e eficientes. Isso se traduz em modelos de IA que podem ser desenvolvidos e implantados com maior agilidade, impulsionando a inovação em diversas áreas, desde veículos autônomos até processamento de linguagem natural.
Linha do tempo
CEVIU News publica "Introdução ao PyTorch".
CEVIU News publica "Dois estudos sobre otimizações de compiladores".
CEVIU News publica "Profiling no PyTorch (Parte 2): De nn.Linear para um MLP Fused".
CEVIU News publica "O que acontece nos bastidores quando você executa um kernel CUDA na GPU".
CEVIU News publica "Desvendando a Paralelização no Treinamento de Modelos Transformer".
Estudo detalha construção de compilador de GPU com framework Emmy.
Perguntas frequentes
O que é 'lowering' no contexto de compiladores de GPU?
No contexto de compiladores de GPU, 'lowering' é o processo de transformar um programa de uma representação de alto nível (como um grafo do PyTorch) para uma representação de baixo nível (como código CUDA). Isso é feito em várias etapas, passando por diferentes Representações Intermediárias (IRs) que adicionam detalhes específicos do hardware.
Por que são necessárias múltiplas Representações Intermediárias (IRs) em um compilador de GPU?
Múltiplas IRs são essenciais porque cada uma permite aplicar um conjunto específico de otimizações e transformações. O Tensor IR unifica a semântica, o Loop IR permite fusão de operadores, o Tile IR lida com a paralelização da GPU e o Kernel IR prepara o código para o hardware, tornando o processo modular e otimizado.
Como o Emmy otimiza operações do PyTorch para GPUs?
O Emmy otimiza operações do PyTorch para GPUs mapeando grafos do PyTorch para uma sequência de IRs progressivamente mais detalhadas. Ele aplica técnicas como fusão de operadores (no Loop IR), tiling e agendamento de tarefas (no Tile IR) e autotuning, que mede diferentes estratégias de execução para encontrar a mais eficiente.
Qual a importância do autotuning em compiladores de GPU como o Emmy?
O autotuning é crucial porque o desempenho ideal em GPUs pode variar drasticamente dependendo do hardware, tamanho dos dados e até mesmo da versão do driver. Ele permite que o compilador explore um espaço de "agendamentos" possíveis e meça qual deles oferece o melhor desempenho para uma operação específica, garantindo máxima eficiência em tempo de execução.
Fontes
- kernelspace.substack.comfonte original
- Categoria
- CEVIU Hardware
- Publicado
- 15 de outubro de 2026
- Editoria
- CEVIU Hardware