

A OpenAI e o NASK National Research Institute, da Polônia, assinaram um acordo para explorar colaboração em safety, segurança e pesquisa técnica em IA. A parceria reunirá a expertise das duas organizações para entender melhor riscos emergentes, fortalecer salvaguardas e explorar como a IA avançada pode contribuir para um ecossistema digital mais seguro e resiliente. Pelo acordo, o AI Safety Research Center do NASK, que atua como o Instituto Polonês de Segurança em IA (AISI), e a OpenAI vão colaborar em pesquisa de safety, explorando formas de avaliar sistemas de IA cada vez mais capazes, identificar vulnerabilidades potenciais e fortalecer salvaguardas. A OpenAI afirma que o trabalho já realizado com o US Center for Advancing Standards and Innovation for Super Intelligence (CAISSI), o UK AI Security Institute (AISI) e outras instituições públicas de pesquisa ajudou a fortalecer salvaguardas, identificar e corrigir vulnerabilidades de segurança em agentes de IA e avançar em safety de IA de fronteira. A empresa também defende que os EUA trabalhem com outros países em padrões técnicos internacionais para IA de fronteira e diz que a colaboração com o NASK reflete o valor de incluir a expertise nacional nesse esforço. O acordo também se apoia na atuação existente da OpenAI com defensores cibernéticos na Polônia. Em julho, o CERT Polska, que opera dentro do NASK, ganhou acesso aos modelos da OpenAI com capacidades de cibersegurança por meio do Daybreak. A equipe usou os modelos para ajudar a descobrir seis vulnerabilidades no MikroTik RouterOS, incluindo falhas que, combinadas, permitiam assumir o controle de dispositivos afetados sem autenticação. O fornecedor lançou correções que, segundo o CERT Polska, impediram os ataques observados.
CEVIU News
As melhores notícias de tecnologia, curadas diariamente para quem vive tech.
2841 notícias encontradas
O ecossistema de IA do Cazaquistão está deixando os planos de infraestrutura para entrar na fase de implantação. A mudança atinge todo o stack, da infraestrutura aos modelos e aplicações. Segundo o texto, os anúncios apontam para a oferta crescente de computação acelerada no país e para uma demanda cada vez maior pelo que vem a seguir. Na infraestrutura, a Kazakhtelecom, maior empresa de telecomunicações do país, já implantou 400 GPUs NVIDIA H200 e 480 GPUs NVIDIA B300 em Astana e Almaty. No próximo ano, a empresa planeja implantar mais de 1.000 GPUs no Data Center Valley e mais de 1.000 GPUs NVIDIA Vera Rubin na região de Ekibastuz, para atender diferentes workloads com infraestrutura que empresas, desenvolvedores e instituições possam usar em escala. Entre as empresas nativas de IA, inDrive e Pony.ai colaboram para explorar serviços de robotáxi no Cazaquistão, com Astana como primeira cidade. As companhias vão avaliar a viabilidade de levar os robotáxis de sétima geração da Pony.ai ao app da inDrive, com apoio da infraestrutura de IA da NVIDIA, construída sobre a plataforma de sensores e compute NVIDIA Hyperion e o sistema de safety NVIDIA Halos. Mais capacidade local dá a desenvolvedores e empresas espaço para treinar, fazer fine-tuning e servir modelos cada vez mais capazes, e aplicações bem-sucedidas, por sua vez, geram demanda por mais compute. O texto afirma que a oportunidade do país não se define apenas pelo número de GPUs: conectar essa infraestrutura a desenvolvedores, universidades, startups e indústrias pode transformar computação acelerada em aplicações úteis.
Aplicações e agentes tomam muitas pequenas decisões ao longo de um workflow, como classificar uma entrada, rotear uma requisição ou escolher a próxima ação. Isoladamente são simples, mas em escala latência e custo se acumulam. A OpenAI anunciou a disponibilidade geral da Decisions API. Construída com o GPT‑6 Luna, a API concentra a inteligência do modelo em perguntas com respostas delimitadas e permite decisões quase em tempo real a partir de texto, imagens e entradas estruturadas, até 10x mais rápido do que o GPT‑6 Luna via Responses API. Desde o beta público, a API ganhou integração nativa com o GPT‑Live, prompt caching para contexto reutilizado e inference residency nos EUA e na UE. Também é possível enviar entradas em JSON nativo, incluir imagens nas instruções das perguntas e fazer até 400 perguntas por requisição, o dobro do limite anterior. A latência seguiu melhorando, com capacidade adicional em várias regiões da Ásia. Internamente, a OpenAI usa a API em fluxos de produto e de negócio: o time dots, para reduzir tempos de resposta e melhorar a interatividade; o de Personal Finance, para categorizar descrições de transações; e o de Communications, para classificar a cobertura por temas e avaliar se ela reforça ou questiona narrativas-chave. Clientes a aplicam da atribuição precisa de custos de IA a experiências mais interativas de aprendizado de idiomas. No uso, o desenvolvedor define uma pergunta e as respostas permitidas, e fornece o contexto em texto, imagens ou JSON nativo. A API retorna um de três tipos de resposta: probabilidade, escolha ou score. Com a integração ao GPT‑Live, aplicações de voz podem decidir durante conversas ao vivo se fazem uma pergunta de esclarecimento, roteiam uma requisição ou escalam um problema, ou ajustar a expressão de um avatar conforme a fala do usuário. Basta adicionar a configuração em session.triggers de uma sessão GPT‑Live existente; o Live emite um decision.event, que a aplicação lê para animar o personagem.
A Microsoft, em colaboração com a Hugging Face, publicou o segundo post da série iniciada com "The Agent Said It Was Done. The Database Disagreed". O ThinkingBox-Training já está disponível no GitHub. O ThinkingBox avalia o trabalho de um agente comparando o estado final do banco de dados com o resultado esperado. Esse mesmo tipo de sinal executável foi usado como reward em tarefas de treinamento fora do ThinkingBox-Bench. No Qwen3.8-27B, o sucesso médio subiu de 51,70% para 60,78%, e as tarefas concluídas corretamente nas vinte tentativas passaram de 38 para 107 com 50 steps de GRPO. Para escolher as tarefas de treinamento, os autores usam o que chamam de dificuldade offline relativa à política (offline policy-relative difficulty): a probabilidade de sucesso de cada tarefa é estimada uma vez com a política base, antes do treinamento, e o conjunto selecionado permanece fixo durante toda a execução. Segundo o texto, a maioria das tarefas já está resolvida ou é impossível para o modelo, e nenhum dos dois casos ensina algo. O treinamento aumentou bastante o sucesso repetível, com uma pequena queda na cobertura de pelo menos um acerto (pass@20). Em uma tarefa de reserva de hotel corporativo, o modelo base alterou a reserva sem a aprovação do gestor em 15 de 20 tentativas; após o fine-tuning com RL, preservou o estado da reserva e do pagamento nas 20.
A Uber anunciou a implantação do ChatGPT Work em toda a empresa, a partir de hoje. O agente, que roda dentro do ChatGPT Enterprise, ajuda funcionários a executar diversas tarefas e ficará disponível para mais de 30 mil pessoas em todo o mundo. A expansão parte de um piloto com mil funcionários. As equipes passam a ter uma plataforma baseada em agentes, pensada para tarefas complexas e de múltiplas etapas, que entrega o trabalho finalizado. É a primeira implantação em toda a empresa de uma plataforma agentic voltada a trabalho do conhecimento na Uber. O ChatGPT Work se conecta a ferramentas de uso diário, como Google Drive, Gmail, Google Calendar e Slack. Com isso, pode pesquisar informações, preparar resumos de reuniões, criar apresentações, analisar dados e concluir fluxos de trabalho entre aplicativos. A Uber também ganha acesso ao portfólio de frontier models da OpenAI. Modelos como o GPT-6.1 Sol serão a capacidade padrão no ChatGPT Work, equilibrando desempenho de fronteira e eficiência de custo. Recursos multimodais, como voz e geração de imagens, também estarão disponíveis, e as equipes poderão escolher os modelos e ferramentas mais adequados a cada necessidade. A implantação será apoiada pela biblioteca interna de habilidades de IA da Uber, por integrações aprovadas e por treinamento dedicado, para ajudar áreas como operações, finanças, marketing e produto. Desenvolvedores e equipes de engenharia de software continuarão usando o Codex para acelerar o desenvolvimento e agilizar fluxos de programação.
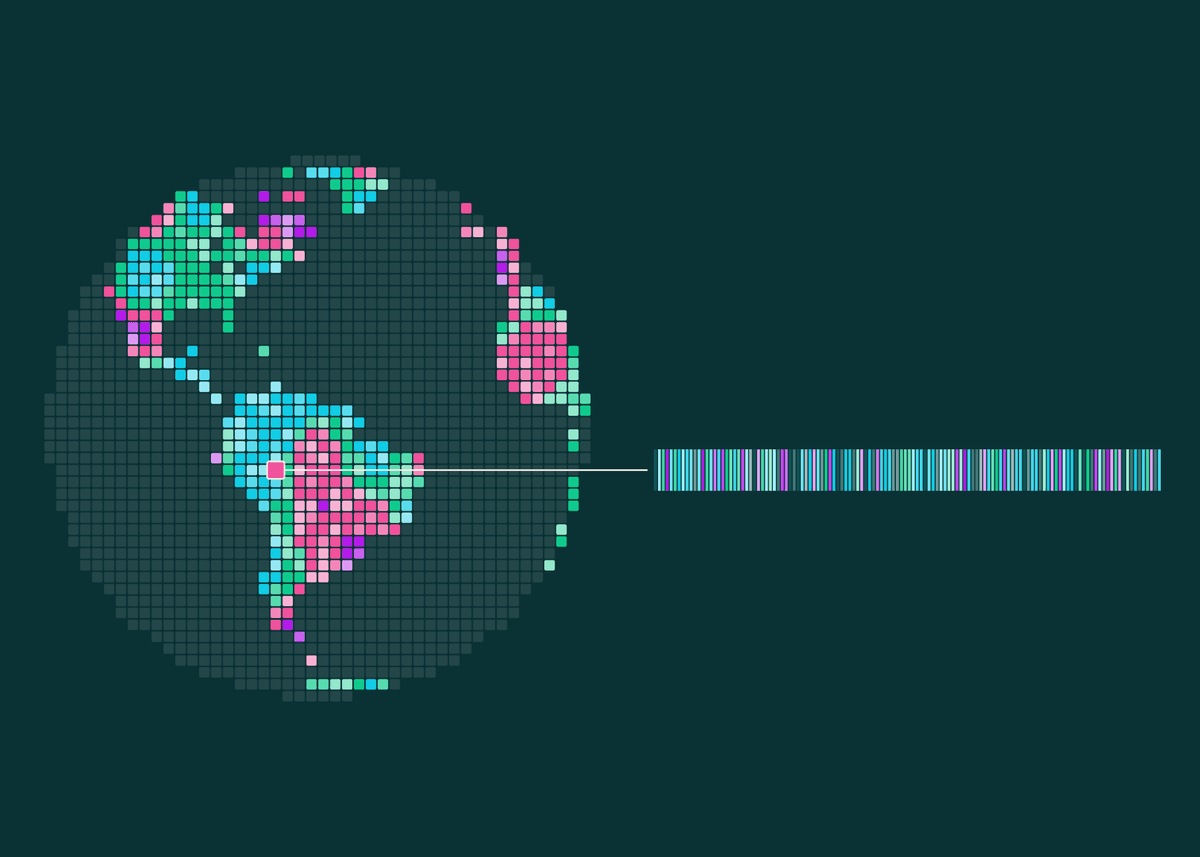
A Ai2 lançou o OlmoEarth v1.3, um modelo de embeddings de satélite de última geração. Junto com ele, divulgou embeddings anuais pré-computados para todo o planeta (10 m, com 64 e 128 dimensões) e o OlmoEarth Embeddings Explorer, nova ferramenta no navegador para explorar e personalizar mapas baseados nesses embeddings. Segundo a Ai2, qualquer pessoa pode usar o modelo de imediato, sem login e sem conhecimento técnico avançado. Até agora, a principal forma de usar o OlmoEarth era o fine-tuning no OlmoEarth Studio: treinar um modelo para cada tarefa e executá-lo sobre imagens de satélite para gerar um mapa, o que exige acesso a GPU e capacidade de baixar e armazenar as imagens. Já os modelos de embeddings comprimem os dados de satélite em features prontas para uso, reutilizáveis a baixo custo em várias tarefas. O OlmoEarth v1.3 lê uma série temporal de um ano de radar (Sentinel-1) e de imagens multiespectrais (Sentinel-2 e Landsat) e produz um vetor de 128 dimensões para cada pixel de 10 metros da Terra; as primeiras 64 dimensões também funcionam sozinhas como um embedding menor. Na arquitetura, um vision transformer lê os dados, um Attention Pooler os agrega em um vetor por trecho de terreno e uma camada linear reduz o resultado a 128 números. Os embeddings de todo o planeta foram computados e compartilhados com a comunidade no Source Cooperative. Com eles, mapas de cultivos, de cobertura do solo ou análises de mudança viram um problema de modelagem leve: basta treinar um classificador pequeno por cima e executá-lo localmente. A Ai2 comparou os embeddings com AlphaEarth Foundations (AEF) e Tessera v2 em 27 avaliações, cobrindo seis continentes e diversas tarefas. Os embeddings de 128 dimensões tiveram a maior pontuação em 20 das 27 avaliações e o melhor resultado geral; a versão de 64 dimensões, com metade do tamanho, lidera em 18 de 27. Como parte da avaliação, foi apresentado o PLANTEUR, novo benchmark de tipos de cultivo para agricultura tropical. Modelo, dados e código de pré-treinamento são totalmente abertos. O OlmoEarth v1.3 foi o modelo mais barato de treinar da linha: consumiu 53% do tempo computacional da v1.2 e 18% da v1, com 50% e 22% das emissões de carbono, respectivamente. Ele também continua forte em fine-tuning, igualando o desempenho da v1.2. Segundo a Ai2, reproduzir o pré-treinamento do OlmoEarth v1.3 Base custaria cerca de US$ 2.720 em tempo de H100 alugado na execução final.
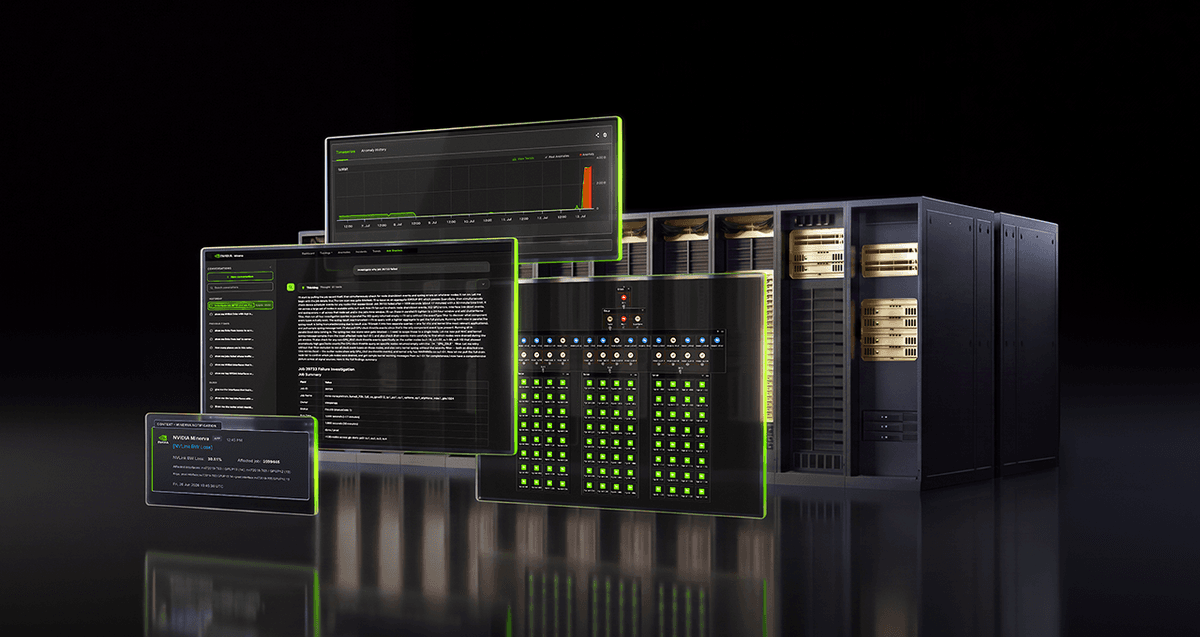
A NVIDIA lançou o Minerva, plataforma de AIOps criada para ajudar equipes a encontrar problemas mais cedo e manter as AI factories produtivas. Ela reúne telemetria da infraestrutura e das cargas de trabalho de IA e aplica modelos de IA desenvolvidos para esse fim, transformando os dados em insights oportunos e acionáveis. O foco é o AI factory yield, métrica do trabalho útil produzido pela infraestrutura, medido por horas de GPU, goodput, uptime do cluster e produção de tokens. Ferramentas tradicionais de monitoramento costumam dividir o data center em visões separadas para redes, compute, site reliability e machine learning. O Minerva conecta sinais de GPUs NVIDIA, redes, storage, schedulers e workloads, e constrói um knowledge graph dinâmico que mapeia logicamente GPUs, SuperNICs, switches, cabos e os jobs em execução. Com isso, é possível rastrear um job de treinamento lento até o componente que o afeta, mesmo em uma fábrica com centenas de milhares de GPUs. A plataforma analisa bilhões de pontos de dados por hora com machine learning supervisionado e não supervisionado, aprende o comportamento normal, detecta anomalias inéditas, prevê falhas emergentes e correlaciona eventos com base na topologia. Em vez de enviar cada sintoma ao operador, agrupa uma tempestade de eventos em um incidente focado, com provável causa raiz. O Minerva traz um assistente de IA nativo e se conecta a ferramentas externas de agentic AI, com interface em linguagem natural baseada em telemetria em tempo real. Operadores podem investigar a saúde do cluster e receber recomendações de correção por conversa. As equipes podem manter uma pessoa no loop para aplicar as correções manualmente ou conectar a plataforma a automações via APIs de infraestrutura e sistemas externos. Segundo a NVIDIA, os ganhos são mais tempo entre interrupções, reparo mais rápido e menos alertas irrelevantes. A IREN está entre os parceiros que usam o Minerva. Aolani, Bitdeer AI, IBM, Jio, Lambda, Quake AI e Tesla planejam fazer o deploy da plataforma. Dell Technologies, Lenovo e Supermicro vão oferecê-la em seus portfólios de operações de AI factories.
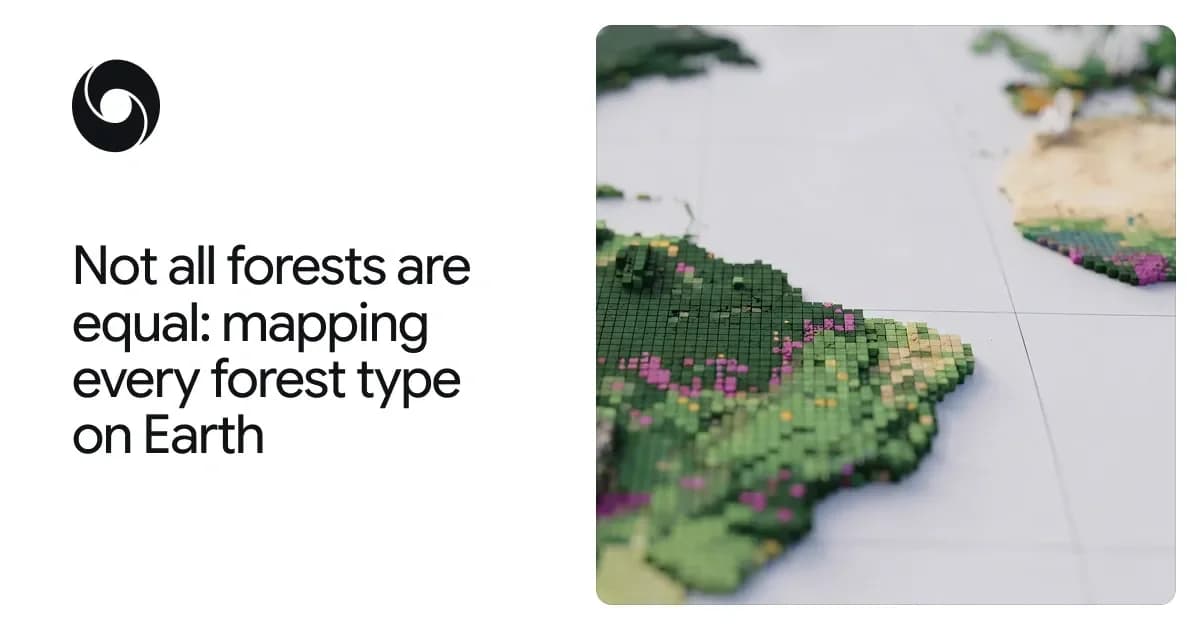
O Google DeepMind e o Google Research, em parceria com o World Resources Institute (WRI) e o International Institute for Applied Systems Analysis (IIASA), lançaram o Forest Typology (ForTy) 2020, mapa global que classifica cada trecho de 10 por 10 metros do planeta em seis tipos de floresta e uso da terra. A base é considerada importante para o regulamento de desmatamento da União Europeia (EUDR). Junto do mapa, os parceiros compartilham uma série temporal preliminar com as mudanças anuais entre 2017 e 2025, incluindo onde florestas naturais foram substituídas por plantações ou fazendas. É a primeira vez que se vê, em escala global, com 10 metros de detalhe e ano a ano, não só onde houve perda de floresta, mas o que a substituiu: plantação de madeira, cultivo de árvores ou outro uso da terra. A maioria dos mapas globais indica apenas se há árvores, mas o valor ecológico depende do histórico: uma floresta primária nunca desmatada armazena muito mais carbono e biodiversidade do que uma plantação de uma só espécie colhida a cada uma ou duas décadas. O EUDR exige que café, cacau ou óleo de palma não venham de áreas que eram floresta em 2020 e foram convertidas para agricultura, e que produtos de madeira, como móveis, estejam livres de degradação florestal. Por isso, empresas e reguladores precisam saber o tipo de floresta e o que ocupa o lugar após a colheita. O ForTy sucede o Natural Forests of the World 2020, lançado no ano passado, que separava florestas naturais das demais coberturas de árvores. Agora, o mapa mostra o tipo de floresta em cada local e, com a nova série temporal, como isso muda a cada ano. As seis categorias seguem definições da FAO: floresta primária (nativa, sem sinais visíveis de perturbação humana); floresta em regeneração natural (voltou a crescer sozinha, por exemplo após logging ou incêndio); floresta plantada (plantada ou semeada e manejada em ciclos longos); floresta de plantation (árvores de crescimento rápido e manejo intensivo, muitas vezes de uma só espécie); cultivos arbóreos e agrofloresta (dendê, seringueira, cacau ou frutas); e outras terras (pastagens, lavouras, cidades e água). Treinar o modelo foi um desafio porque as categorias dependem em parte do uso da terra, e não só da aparência.
A OpenAI descreve o que a equipe de Forward Deployed Engineering (FDE) faz, como trabalha e como resolve os problemas mais difíceis de clientes corporativos para gerar impacto real. O autor conta que, quando o Codex foi lançado, alguém da equipe perguntou o que fazer quando o Codex resolve em one-shot casos de uso que levaram meses para ser construídos. Para ele, isso resume o papel do FDE: trabalhar junto aos clientes para entender seus problemas mais difíceis e construir soluções confiáveis. O aprendizado ajuda a moldar os produtos e dá à área de Pesquisa problemas concretos para resolver. Se a equipe se torna obsoleta a cada dois meses, diz ele, está cumprindo sua função. O autor fundou a equipe no início de 2025 para fechar o que chama de deployment gap: a distância entre o que os modelos parecem capazes de fazer e o que as pessoas conseguem usar com confiabilidade no trabalho. As capacidades dos modelos avançaram mais rápido que os sistemas e processos necessários para colocá-las em uso. Às vezes falta um produto; outras vezes o modelo vai bem em um benchmark, mas não dá conta das variáveis e restrições do mundo real. Onde os modelos já resolvem, a equipe trabalha com Produto e o cliente para tornar a solução repetível; onde ficam aquém, trabalha com o cliente e Pesquisa para definir a lacuna e melhorar. A meta é que cada projeto deixe o próximo cliente com um ponto de partida melhor. Um exemplo é a John Deere, empresa agrícola de 200 anos, cujo desafio era escalar aconselhamento personalizado para agricultores. Sua tecnologia See & Spray usa câmeras e machine learning para identificar e pulverizar apenas as ervas daninhas, reduzindo o uso de químicos em até 70%. Os benefícios dependem de o agricultor saber configurar a tecnologia, planejar a safra e ajustar práticas. A John Deere usou as APIs da OpenAI para tornar esse suporte personalizado e escalável: a IA responde perguntas em linguagem natural, orienta a configuração, identifica quando o equipamento pode não estar rendendo ao máximo e ajuda o agricultor a enxergar o valor obtido. O texto afirma que os problemas costumam ser abertos, sem ground truth estabelecido e sem playbook. O valor central apresentado às equipes é começar pelo resultado, fazer o necessário para ter sucesso e só então escalar, porque uma demo impressionante pode ir longe antes de alguém perguntar se funciona no mundo real. Em meados de 2025, cerca de 15 FDEs trabalhavam com um grande cliente de semicondutores em mais de 10 casos de uso, com a ambição de tornar o processo de verificação AI-native, incluindo root cause analysis e debugging. Segundo o texto, a verificação pode representar cerca de 70% do esforço de um projeto no setor.
O Google Cloud apresentou o Agent Compute Engine, novo serviço que dá a cada agente de IA sua própria microVM isolada por hardware, com velocidade de container e nenhuma credencial mantida dentro do sandbox. O texto abre citando o evento The Future of AI Infrastructure, em 9 de novembro. Segundo o Google, cada mudança de software exigiu repensar a arquitetura de computadores: Borg e containers, depois Kubernetes, depois as TPUs para deep learning e, para segurança com garantias ancoradas em hardware, o Titanium, arquitetura de silício customizado e IPU que tira da CPU do host a virtualização de I/O, o armazenamento e a confiança criptográfica. Agora, a transição é para a IA agentic, que age em vez de apenas responder. Dentro do Google, agentes escrevem e executam código, usam ferramentas, controlam navegadores, orquestram fluxos corporativos e iteram em repositórios, e as cargas agentic estão entre as que mais crescem em consumo de compute e armazenamento na frota. Para a empresa, as primitivas de compute tradicionais não foram feitas para rodar centenas de milhões de agentes em escala planetária, com o custo e a latência necessários. O post descreve como as equipes do Gemini e do Gemini para empresas dividiram cada agente em harness (o cérebro, que chama o modelo e decide o próximo passo) e sandbox (as mãos, que executam código, comandos de shell e navegador). Cada agente precisa de um ambiente completo, com filesystem, runtimes, rede e navegador. VMs tradicionais oferecem controle total e isolamento via hypervisor, mas iniciar, suspender e retomar leva de segundos a minutos, um overhead que pesa em agentes que pausam e retomam o tempo todo. Containers são rápidos e leves por compartilharem o kernel do host, mas agentes de código e assistentes de desenvolvimento exigem isolamento completo e controle em nível de kernel e root. O texto também destaca que entender o que o agente tenta fazer é essencial para lidar com a carga: mesmo ocioso entre passos do modelo, ele precisa agir rápido e pode manter um estado de trabalho crítico.
A Monaco lançou o Agent Matrix, plataforma que coordena vários agentes de IA trabalhando de forma contínua em prol do crescimento de receita. O lançamento está oficialmente disponível.
Os frontier models da OpenAI e os fluxos de trabalho com agentes do Codex vão chegar ao Model Garden do Google Cloud. A integração dará aos clientes acesso nativo a esses modelos para executar workflows complexos com agentes em escala. A proposta é unir os frontier models da OpenAI aos controles de acesso integrados, à governança centralizada de dados e à infraestrutura de alto desempenho do Google Cloud, para sustentar cargas de trabalho corporativas exigentes. Em breve, os modelos da OpenAI também ficarão disponíveis no Google Antigravity e no Gemini Agent.
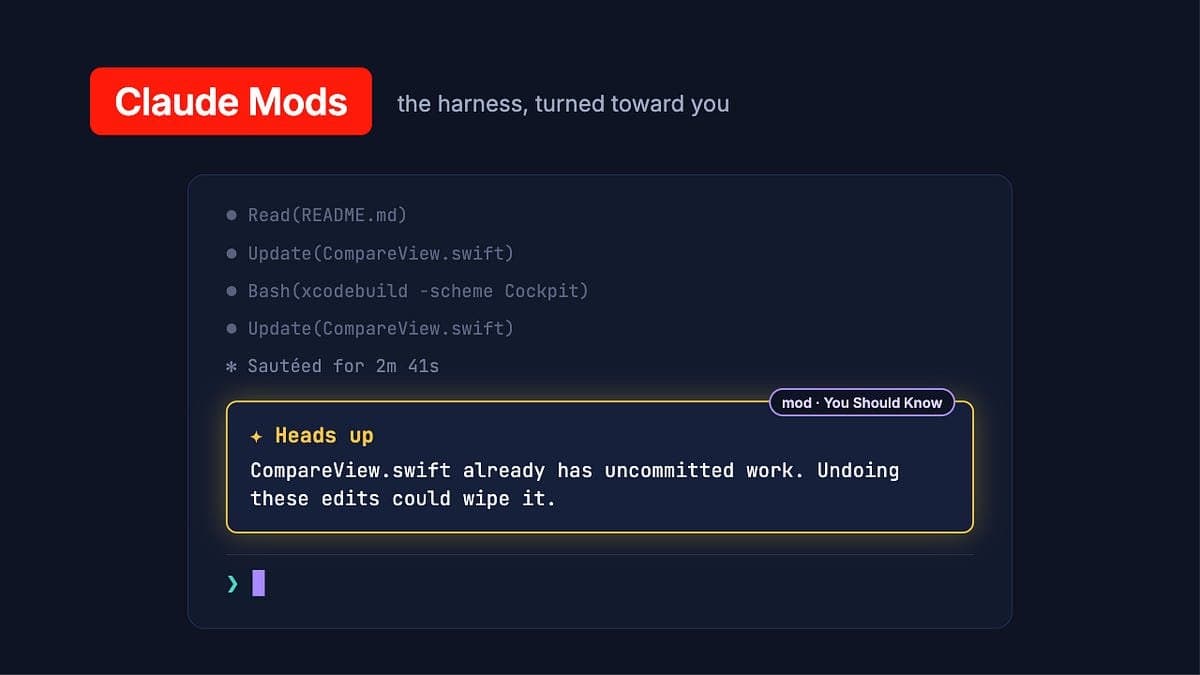
O Claude Mods inverte o paradigma do agent harness para que ele fique voltado ao humano, com uma Attention Interface personalizável para o Claude. Os mods são funções em TypeScript ou JavaScript que alteram o comportamento do Claude Code em tempo real, permitindo que cada usuário defina como o Claude interage com ele. Com isso, é possível programar a interface entre humano e agente e até pedir que o próprio Claude crie os mods, o que, segundo a cobertura, melhora o fluxo de trabalho e a tomada de decisão.
Um pacote malicioso do LiteLLM foi publicado no PyPI e ficou no ar por cerca de 2 horas antes de ser removido. O caso envolve a release v1.107.0, de 21 de outubro de 2026, segundo o aviso de segurança publicado em docs.litellm.ai, que classifica o incidente como contido.
O GUI-Owl 1.5 é um modelo de tela com 2 bilhões de parâmetros que lê a tela do Android por meio do serviço de acessibilidade e consegue tocar e digitar em qualquer outro app. A proposta leva o conceito de computer use para o próprio aparelho.
A OpenAI trabalhou com os mantenedores do PHP e parceiros de segurança para corrigir vulnerabilidades críticas encontradas com o GPT-5.6 Sol e, de forma independente, pela Wiz. A empresa também lançou um verificador de vulnerabilidades do PHP e propôs um framework para coordenar a resposta a falhas de segurança descobertas por IA.
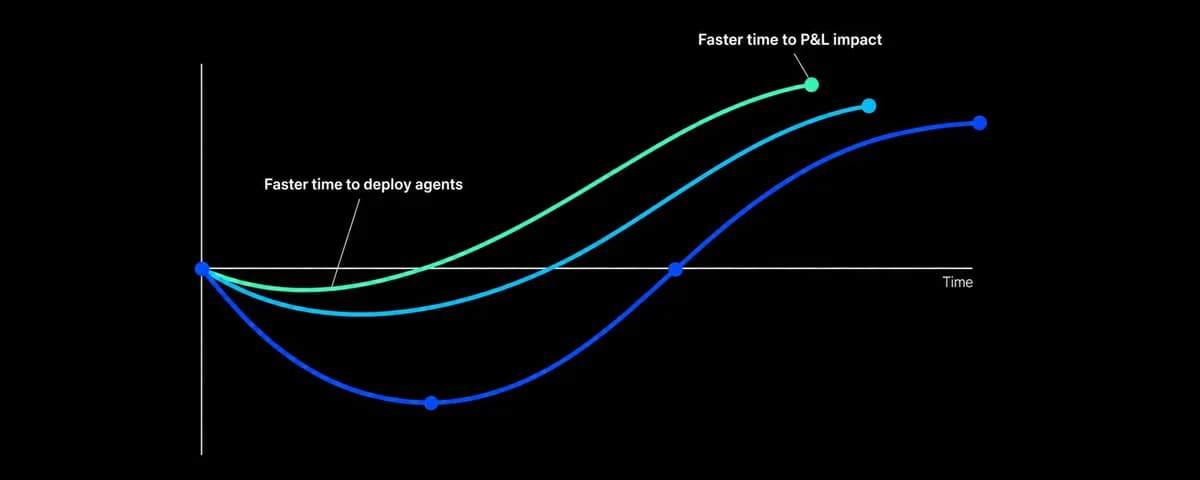
A Long Lake argumenta que comprar empresas de serviços já estabelecidas resolve as barreiras à implantação de IA. Segundo a empresa, isso se deve à confiança dos clientes, ao conhecimento especializado, aos dados proprietários e ao alinhamento de incentivos. Com apoio de US$ 7,5 bilhões, a Long Lake fez parceria com 40 negócios para transformar automação em ganhos operacionais mensuráveis.
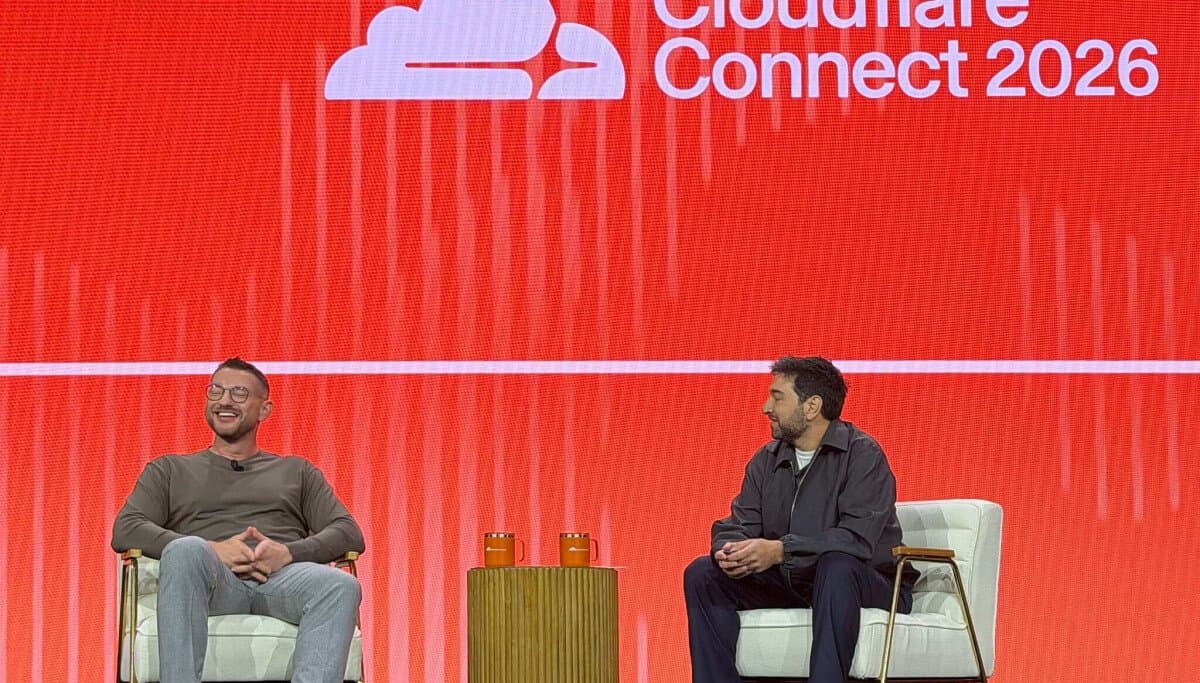
Peter Steinberger, criador do OpenClaw e hoje membro da equipe técnica da OpenAI, estima ter gasto cerca de US$ 10 milhões em tokens rodando workloads de IA no mês passado, tudo com dinheiro de investidores. Segundo o texto, ele tem um orçamento de tokens praticamente ilimitado, o que lhe permite trabalhar de forma diferente de outras pessoas do setor. O artigo reúne algumas das respostas dele em uma conversa com o CTO da Cloudflare durante a conferência Cloudflare Connect 2026.
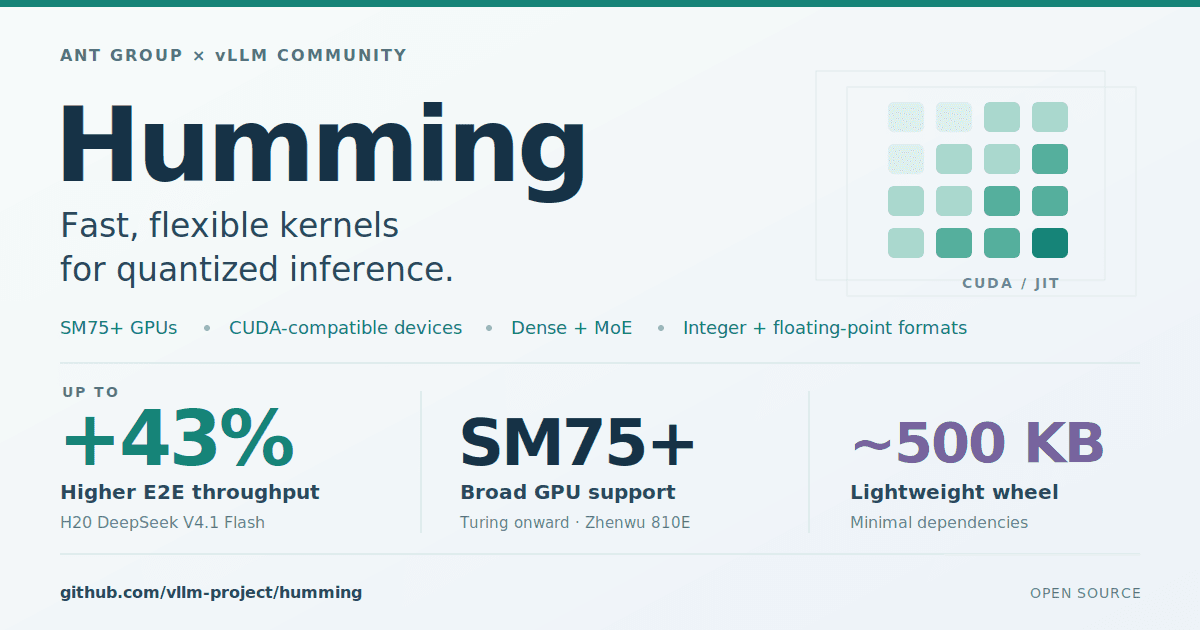
Biblioteca de kernels Humming para inference quantizada chega com foco em flexibilidade e desempenho
O Humming é uma biblioteca de kernels de uso geral para inference quantizada. Segundo o blog do vLLM, ela oferece amplo suporte a dispositivos, suporte extenso a quantization e bom desempenho de execução. Sua arquitetura unificada facilita o ajuste dos parâmetros de execução e a coleta de pipelines para diferentes workloads.
A Claude API recebeu sua primeira versão oficial desde 2023, já disponível. A Anthropic planeja lançar novas versões com mais frequência, para que os desenvolvedores possam lidar com breaking changes antes que um novo modelo exija isso. A versão 2023-06-10 não foi descontinuada. Novas versões major dos SDKs e da CLI da Anthropic foram lançadas hoje e já usam a nova API por padrão. Há um guia de migração disponível.