
Biblioteca de kernels Humming para inference quantizada chega com foco em flexibilidade e desempenho
Aprofundamento CEVIU
Aprofundamento
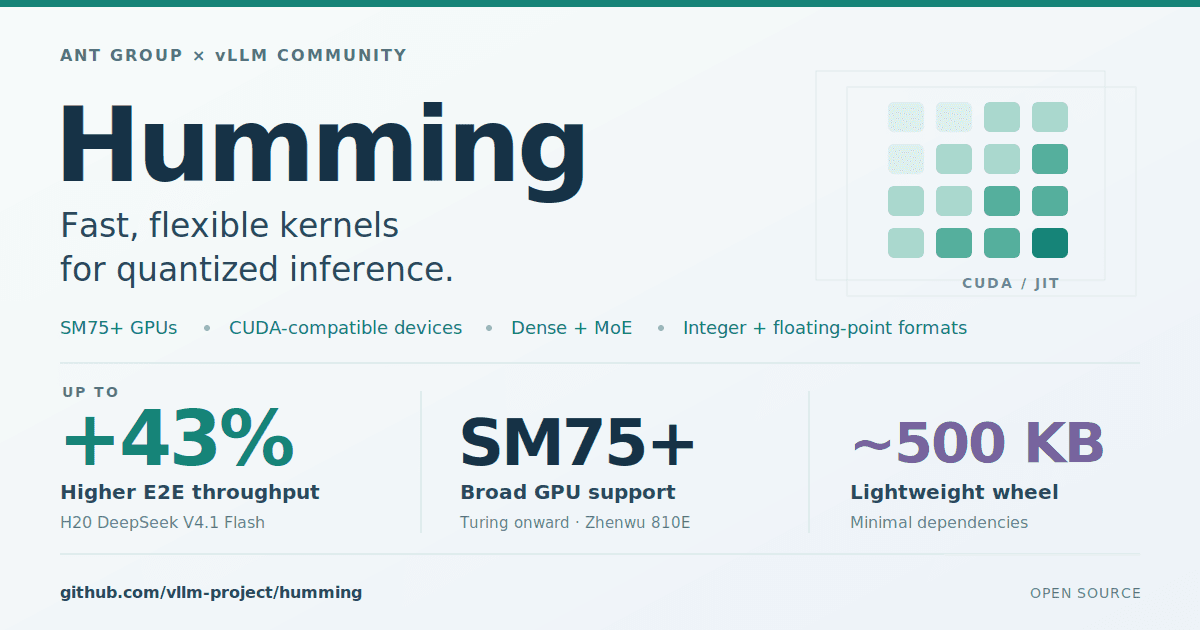
O Humming é uma biblioteca de kernels para inference quantizada aberta pela Ant Group em parceria com a comunidade vLLM. A proposta é cobrir muitas combinações de quantization sem escrever um kernel dedicado para cada uma. Ele aceita formatos como WNA16, W8A8, W4A8 e W4A4, com tipos inteiros e de ponto flutuante, para cargas dense e MoE. O argumento da fonte é que o custo de memória pesa muito em MoE: o DeepSeek-V3 tem 671 bilhões de parâmetros, mas ativa 37 bilhões por token, e todos os pesos precisam ficar armazenados.
A arquitetura converte os formatos exportados por diferentes ferramentas para um formato padrão do Humming. Depois, três configurações (Layer Config, Compute Config e Tuning Config) definem o kernel, que é compilado via JIT com NVRTC ou NVCC e fica em cache. Num teste com um único kernel W4A16 em um servidor H200 com CUDA 13.4 e caches desativados, a compilação caiu de 23,35 segundos (CUTLASS com NVCC) para 1,82 segundo (Humming com NVCC) e 1,88 segundo (NVRTC). O suporte cobre GPUs NVIDIA da Turing em diante e o Zhenwu 810E, da T-Head. Em W4A16 denso, a fonte diz que o Humming iguala ou supera o Marlin do vLLM na maioria dos casos testados, com cerca de 2x no H200 em lotes grandes e mais de 3x em alguns casos no B300. Esses números vêm de microbenchmarks rodados pela própria comunidade vLLM.
Por que isso importa
Para quem opera inference com modelos quantizados, o ganho prático está em reduzir o trabalho de manutenção por formato e o tempo de preparar kernels para novos workloads. Para quem ainda usa H200 ou GPUs anteriores à Blackwell, o caminho W4A8-MXFP4 permite manter pesos em 4 bits sem depender de suporte nativo. Vale validar os benchmarks no seu próprio hardware e modelo antes de migrar, já que os resultados são da comunidade que desenvolve o projeto.
Perguntas frequentes
O que é o Humming?
É uma biblioteca de kernels de uso geral para inference quantizada, aberta pela Ant Group e pela comunidade vLLM. Ela cobre combinações de pesos e ativações em formatos inteiros e de ponto flutuante, para cargas dense e MoE.
Quais GPUs o Humming suporta?
Todas as arquiteturas NVIDIA da Turing em diante, além de dispositivos compatíveis com CUDA, como o Zhenwu 810E da T-Head. Na Blackwell, ele também usa os formatos float4e0m3 e float8e3m4, que não são expostos no sistema de tipos do PTX. A Rubin não suporta esses dois formatos.
Quanto o Humming é mais rápido que o Marlin?
Segundo a fonte, em W4A16 denso ele iguala ou supera o Marlin na maioria das configurações testadas. Chega a cerca de 2x no H200 com lotes grandes e a mais de 3x em alguns casos no B300. Os testes foram rodados pela comunidade vLLM.
Como o Humming reduz o tempo de compilação?
A implementação CUDA é leve e evita dependências pesadas de frameworks de kernel. No teste citado, a compilação de um kernel W4A16 caiu de 23,35 segundos com CUTLASS para cerca de 1,8 segundo. Ele também compila kernels em paralelo durante o warmup do modelo.
Fontes
- vllm.aifonte original
- Categoria
- CEVIU IA
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU IA