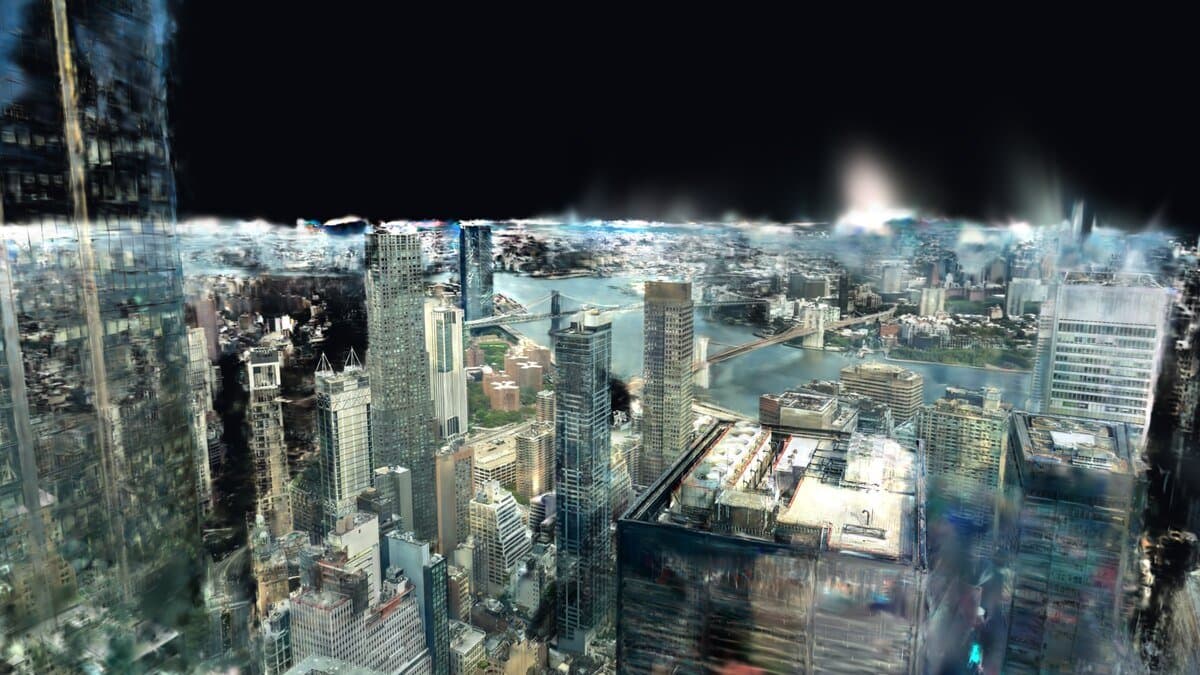
Peter Sobot, da CEVIU Dados, utilizou o modelo Claude e a técnica Gaussian Splatting, alimentados por mais de mil fotografias, para desenvolver uma recriação 3D detalhada do horizonte de Nova York. O projeto, que envolveu a execução de 74 subagentes e cerca de 280 experimentos, demonstra o potencial da IA em automatizar fluxos de trabalho técnicos. Contudo, Sobot ressalta que a IA ainda apresenta limitações em julgamento visual, organização de dados e na avaliação da qualidade final do resultado, indicando áreas cruciais para aprimoramento na modelagem por IA.
A implementação de sistemas de IA em produção exige uma avaliação criteriosa, onde cada componente deve justificar sua complexidade. Para problemas como recomendação, moderação de conteúdo, consultas a data warehouses ou a resolução de 'cold starts' em buscas, a abordagem mais eficaz é frequentemente híbrida. Combinações de lógica determinística, técnicas clássicas de Machine Learning, camadas semânticas e Large Language Models (LLMs) são empregadas para otimizar o desempenho. É fundamental reservar agentes de IA para tarefas que realmente demandam raciocínio avançado, mantendo a lógica de negócios, métricas, roteamento e 'guardrails' com abordagens determinísticas sempre que possível, visando eficiência e controlabilidade.
O Orbit, solução desenvolvida pela WarpStream, promete revolucionar as migrações de Apache Kafka. A ferramenta automatiza o planejamento e as verificações de 'cutover', permitindo que equipes de engenharia de dados movam clusters com maior agilidade. O diferencial do Orbit reside em sua capacidade de realizar transições sem causar interrupções nos produtores, consumidores, offsets ou nas premissas de ordenação, garantindo a integridade dos dados e a continuidade operacional em ambientes Kafka.
A equipe da Incident.io realizou uma reestruturação estratégica em sua arquitetura de mensageria, eliminando a dependência do Google Pub/Sub como um ponto único de falha. A solução envolveu a integração do NATS e a criação de um balanceador de carga ativo-ativo que gerencia o roteamento de mensagens entre ambos os brokers. Testes rigorosos em produção, incluindo a desativação completa do Pub/Sub, comprovaram a robustez do novo sistema, sem qualquer perda de mensagens ou interrupções nos serviços aos clientes.
A versão 0.3 do Apache Iceberg trouxe uma novidade significativa para o ecossistema de dados: o tipo Variant. Essa funcionalidade permite o armazenamento eficiente de dados semi-estruturados, como registros JSON-like, em uma única coluna. O grande diferencial é a preservação de tipos nativos, como timestamps e decimais, aproveitando a codificação binária do formato Parquet. Desenvolvido para otimizar o manejo de informações dinâmicas, o Variant já é compatível com engines como Spark e Flink, e pode ser consultado via Spark SQL através da função `variant_get`.
A PlanetScale apresentou uma inovadora abordagem de backup massivamente paralelo para bancos de dados Postgres, essencial para o ecossistema de dados. O design fragmentado da solução transforma cada shard em um worker independente, capaz de restaurar snapshots válidos diretamente do S3. Este processo inclui a reprodução do Write-Ahead Log (WAL) para garantir a integridade dos dados e, por fim, a criação de uma cópia consistente de um ponto específico no tempo, otimizando a recuperação e a resiliência de dados críticos.
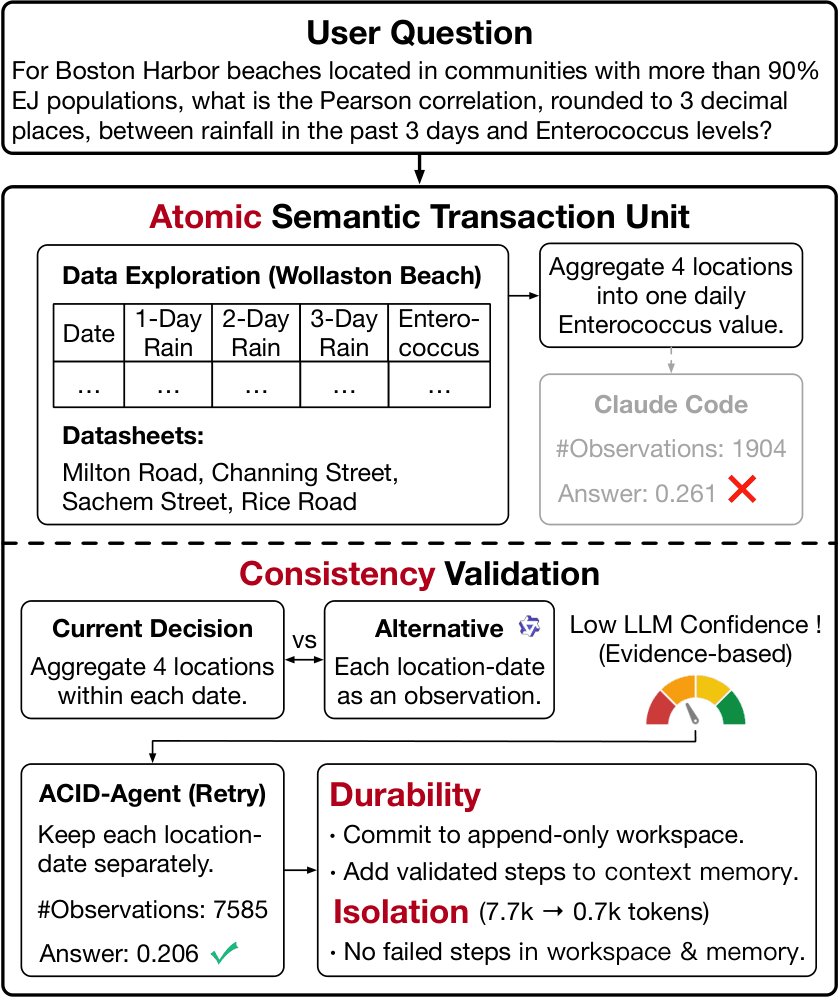
Pesquisadores propõem a aplicação das garantias ACID (Atomicidade, Consistência, Isolamento, Durabilidade), fundamentais em sistemas de banco de dados, a agentes de IA. A abordagem trata fluxos de trabalho complexos como transações, permitindo validar alterações antes da persistência, isolar execuções incompletas e assegurar um estado duradouro. A arquitetura ACID-Agent superou o Claude Code em até 10,6% em benchmarks de agentes de dados, indicando que a robustez da arquitetura pode ser tão crucial quanto a escala do modelo para a eficácia dos sistemas de IA.
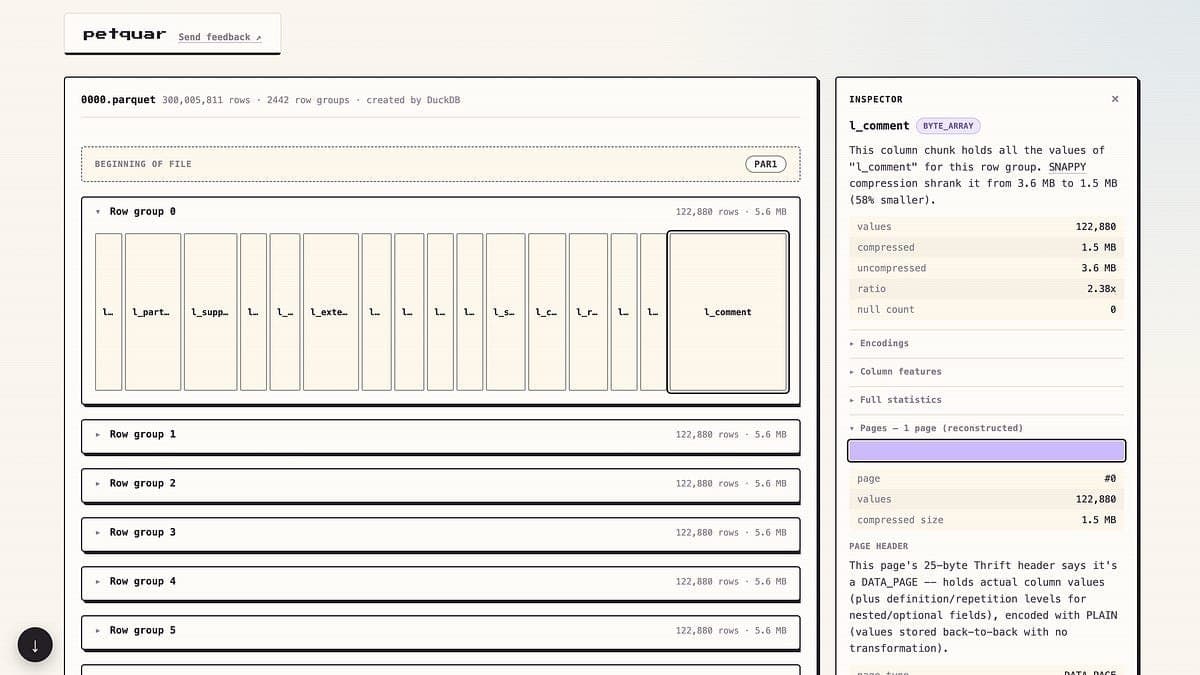
Uma nova ferramenta, operando diretamente no navegador, foi desenvolvida para oferecer uma visão aprofundada da estrutura interna de arquivos Parquet. Utilizando a biblioteca Rust arrow-rs, ela decifra e exibe detalhes cruciais como grupos de linhas, blocos de colunas, páginas, schemas, codificações, filtros Bloom e estatísticas de mínimo/máximo. Esta inovação é particularmente valiosa para profissionais de dados, servindo como um recurso essencial para aprendizado, depuração e a compreensão detalhada do funcionamento de formatos de arquivos colunares.
O DuckDB, conhecido por sua eficiência em OLAP, prepara-se para uma transformação significativa com a versão 2.0, posicionando-se como uma plataforma de dados mais abrangente. As principais inovações incluem a introdução de operação cliente/servidor, triggers para lógica de negócios, suporte aprimorado para dados semiestruturados VARIANT e I/O assíncrono. Além disso, a atualização traz um novo parser SQL, otimizações de armazenamento e desempenho em queries, e um ecossistema mais robusto para extensões, fortalecendo sua capacidade para cargas de trabalho transacionais e facilitando a gestão de dados complexos.
Ajustar o dimensionamento de partições no Apache Spark é um pilar para garantir alto throughput e estabilidade em pipelines de dados. O desafio é equilibrar a utilização plena dos núcleos de processamento com a prevenção de tarefas excessivamente pequenas. Para tal, recomenda-se filtrar dados precocemente, mitigar shuffles e repartitionar dados antes de operações como joins ou escritas, otimizando o layout. Ferramentas como Adaptive Query Execution (AQE), manejo de skew, otimização de spills e checkpoints são cruciais, assim como a avaliação do impacto de muitos arquivos pequenos.
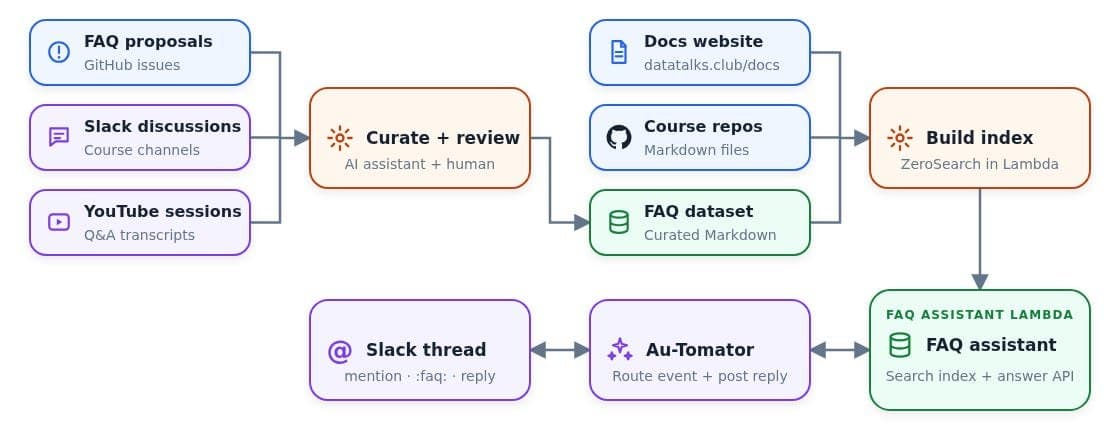
O DataTalks.Club aprimorou seu sistema de FAQ, reconstruindo seu bot com base em uma seleção criteriosa de issues do GitHub, threads do Slack, transcrições do YouTube e casos de avaliação explícitos. A arquitetura serverless, otimizada para AWS Lambda, simplifica o processo de retrieval. O projeto enfatiza a importância da rotulagem, da revisão em lotes e da verificação de falsos positivos, reforçando que a eficácia de um sistema RAG (Retrieval-Augmented Generation) depende diretamente da manutenção e curadoria da qualidade dos dados.
A Uber tem otimizado suas integrações de produtos ao desacoplar a camada de acesso a dados das modificações em tabelas físicas e esquemas subjacentes. Por meio de uma tabela lógica aliada à API FetchData, a empresa consegue responder a consultas em tempo real e diário, abrangendo armazenamentos OLAP, Docstore e Hive. Essa abordagem permite a agregação de métricas por diversas dimensões, culminando em uma drástica redução no tempo de entrega de relatórios para anunciantes, que passou de semanas para menos de dois dias.
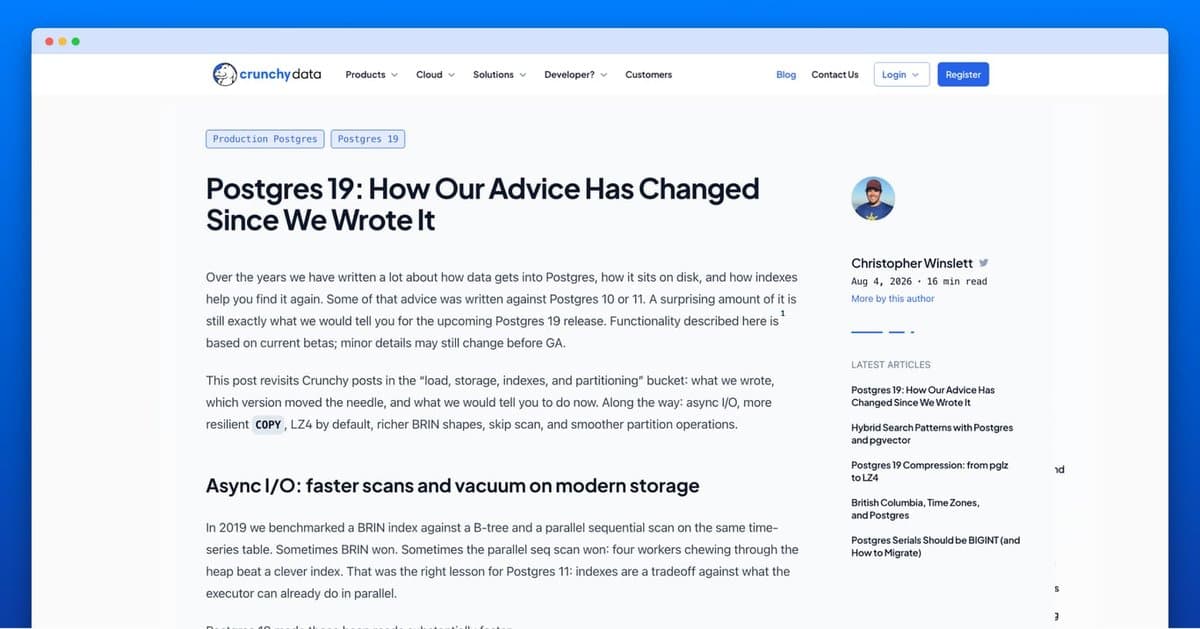
O lançamento do Postgres 19 concentra-se em aprimorar funcionalidades já existentes, sem guinadas drásticas, mas com impactos significativos na performance. As novidades incluem E/S assíncrona com *workers* de autoescalabilidade, um comando `COPY` mais robusto para transferências de dados em massa, compressão LZ4 como padrão para otimização de armazenamento, indexação aprimorada e gestão mais eficiente de partições. As diretrizes essenciais para desenvolvedores e administradores de banco de dados permanecem: utilize o `COPY` para carregamento massivo, estruture dados 'quentes' cuidadosamente, selecione índices de forma estratégica e empregue o particionamento primordialmente para o gerenciamento do ciclo de vida dos dados, refletindo a maturidade e estabilidade do sistema.
A comunidade de análise de dados aguarda com expectativa o lançamento do Polars 2.0. Com a chegada do primeiro *release candidate* prevista para a próxima semana, a nova versão da popular ferramenta de processamento de dados em memória se aproxima rapidamente de sua disponibilidade geral. Este marco sinaliza a fase final de desenvolvimento, prometendo otimizações e novas funcionalidades para operações com DataFrames, consolidando o Polars como uma alternativa robusta e de alta performance no ecossistema de dados.
A Optiver, gigante do trading, ilustra como a engenharia de software de ponta se traduz diretamente em resultados financeiros. Com cerca de 950 engenheiros, a empresa gerencia mais de 10 milhões de operações diárias, destacando a criticidade de baixa latência, alta confiabilidade e qualidade em Machine Learning. Sua robusta stack tecnológica engloba C++, Python, Rust, Kafka, Postgres, Databricks, e até kernels Linux customizados, além de hardware co-localizado. A estratégia da Optiver prioriza a profunda propriedade e otimização da infraestrutura em vez de uma mera busca genérica por velocidade, garantindo uma vantagem competitiva no mercado financeiro.
O DFlash 2 surge como um divisor de águas na otimização de Large Language Models (LLMs), prometendo acelerar a inferência em até três vezes. A inovação reside no aprimoramento da decodificação especulativa, uma técnica que permite processar um volume significativamente maior de tokens por passagem. Este avanço garante não apenas um ganho notável de performance, mas também a manutenção integral da qualidade e consistência da saída dos modelos, um aspecto crucial para a adoção em larga escala de soluções baseadas em IA.
A Netflix reformulou seu pipeline de eventos de anúncios para transmissões ao vivo, adotando o Apache Flink. A mudança estratégica visa otimizar o enriquecimento de metadados, realocando-o para fora do caminho crítico de veiculação e incorporando "streaming joins" com estado. O novo design aprimora o roteamento regional, gerencia eventos atrasados, facilita a recuperação horária via Spark e implementa deduplicação e validação de dupla execução, alcançando mais de 99,99% de concordância antes da desativação do sistema legado.
A equipe da Tailscale dedicou seis meses para investigar e solucionar um persistente problema de corrupção de dados no SQLite. A falha foi identificada como uma rara condição de corrida de 16 anos, ocorrendo entre o checkpointing do Write-Ahead Log (WAL) e transações de escrita. Este cenário era frequentemente exacerbado pela estratégia agressiva de checkpointing manual da empresa. A pesquisa resultou na implementação de um patch oficial para o SQLite, no desenvolvimento de ferramentas de recuperação aprimoradas e ressaltou a importância de operar tecnologias, mesmo as mais consolidadas, dentro de seus parâmetros de uso convencionais para evitar riscos inesperados.
Um recente estudo de benchmark revelou que o DuckDB, executado no ambiente do ECS Fargate, demonstrou uma performance significativamente superior ao Apache Spark, configurado no EMR Serverless. A análise comparativa mostrou que o DuckDB processou mil arquivos JSON armazenados no S3 aproximadamente 3,4 vezes mais rápido, além de gerar um custo operacional inferior. Estes resultados apontam para uma alternativa promissora e mais eficiente para o processamento de grandes volumes de dados JSON diretamente na nuvem, especialmente para tarefas de consulta e análise em larga escala.
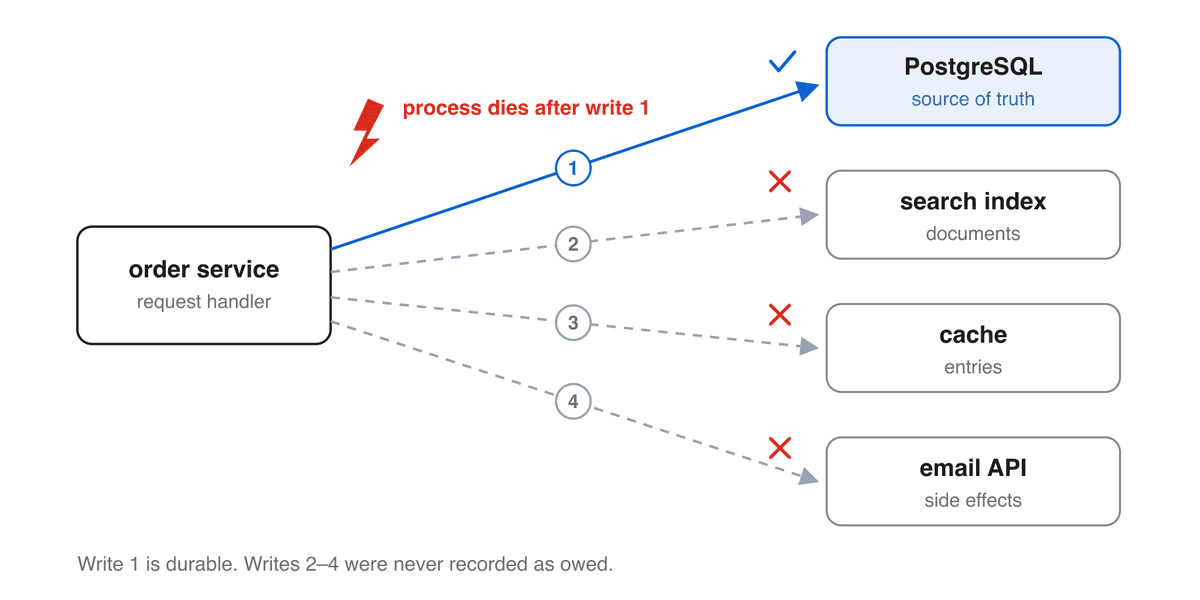
Apesar de o Change-Data-Capture (CDC) facilitar que operações de escrita subsequentes sejam retentáveis, ordenadas e observáveis, ele não assegura a resiliência dos sistemas de destino contra escritas duplicadas. É crucial que o sistema consumidor implemente idempotência durável ou um mecanismo eficiente para rejeitar dados repetidos após a recuperação de falhas. Essa é uma ponderação vital para equipes de arquitetura ao revisar designs, evitando a percepção equivocada de que o CDC, por si só, soluciona automaticamente desafios de consistência.