
A 'Lacuna de Inference': O Custo Oculto da Otimização de LLMs em Produção
Aprofundamento CEVIU
Aprofundamento
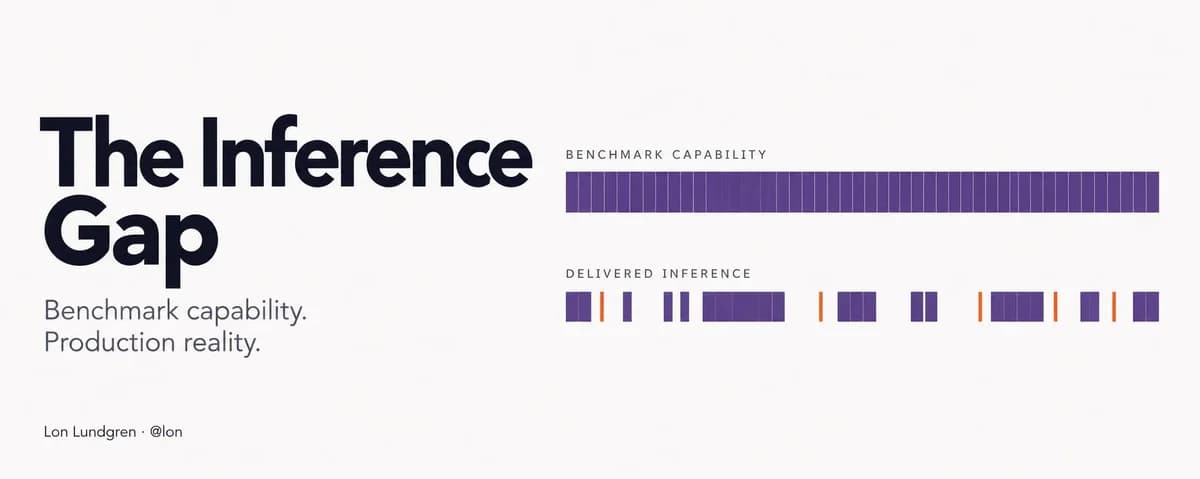
A revelação da 'lacuna de inference' no modelo Fable 5 da Anthropic expõe uma dissonância crucial entre o desempenho de Large Language Models (LLMs) em bancadas de teste e sua operação em ambientes produtivos. O estudo, que analisou mais de 43 mil chamadas de inferência, destaca que o 'orçamento de raciocínio' alocado a cada execução do modelo varia drasticamente, mesmo sob configurações de esforço 'xhigh' ou 'max'. Isso significa que as otimizações para reduzir custos e latência em produção podem podar as etapas de raciocínio sequencial que são vitais para a complexidade das tarefas.
Este problema se manifesta na fragmentação do pensamento. Enquanto uma invocação pode ter uma longa sequência de raciocínio, muitas outras contribuem com pouquíssimo, ou nenhum, processamento. A soma de pequenas contribuições não equivale a uma única sequência de pensamento profundo, essencial para a resolução de problemas mais complexos. Essa constatação ressoa com o que o CEVIU News já apontava em matérias anteriores, como a de 10 de junho de 2026 sobre as Implicações do Test-Time Compute em larga escala, onde o desempenho de LLMs já se mostrava uma função do poder computacional aplicado no momento do teste.
O que mudou
A cobertura anterior do CEVIU News já abordava os desafios da performance de LLMs, como as dificuldades em implementações locais e a saturação de benchmarks. Por exemplo, em 24 de agosto de 2026, as matérias Desvendando a Performance de LLMs Locais e Desvendando a Inteligência Artificial Local discutiam otimizações e custos de hardware. A notícia atual, contudo, vai além de observações gerais. Ela nomeia e quantifica um problema específico: a 'lacuna de inference'.
Esta análise de 5 de outubro de 2026 não apenas confirma que o desempenho em produção é diferente do prometido nos benchmarks, mas detalha o mecanismo por trás disso: a variação e fragmentação do 'orçamento de raciocínio' do modelo. O que antes era uma percepção de que 'o modelo piorou' ou que 'benchmarks não contam toda a história', agora tem uma explicação técnica ancorada em dados sobre como o regime de inferência em si é alterado para o ambiente de produção. Essa é uma evolução significativa na compreensão técnica do problema.
Por que isso importa
Para as empresas que dependem de LLMs para tarefas críticas, a 'lacuna de inference' é um alerta importante. Ela mina a confiança nos modelos e nos resultados de benchmarks, indicando que a capacidade de raciocínio profundo que se espera em ambiente de desenvolvimento pode não ser replicada em produção. Isso leva a um desperdício de recursos, resultados inconsistentes e uma experiência de usuário degradada. Entender essa lacuna é crucial para evitar investimentos em IA que não entregam o valor esperado.
O impacto se estende à governança de dados e à arquitetura de soluções. Equipes de engenharia de dados precisam considerar que o 'cérebro' do LLM em produção pode operar com um orçamento de raciocínio menor e mais fragmentado. Isso exige estratégias de design de prompts mais robustas e, possivelmente, a reavaliação de abordagens de pipeline de dados que buscam otimização de custo a todo custo. Garantir a qualidade e a capacidade preditiva da IA passa a depender não só do modelo em si, mas também do regime de inferência que é efetivamente entregue.
Linha do tempo
CEVIU News publica sobre as Implicações do Test-Time Compute em larga escala, destacando que benchmarks não refletem a realidade dos LLMs.
CEVIU News relata que o desempenho de LLMs degrada significativamente com janelas de contexto muito grandes, acima de 100 mil tokens.
CEVIU News publica sobre a Saturação de Benchmarks de LLMs, questionando a capacidade de diferenciação dos modelos.
CEVIU News lança duas matérias: Desvendando a Performance de LLMs Locais e Desvendando a Inteligência Artificial Local, abordando desafios de hardware e otimização em implantações locais.
CEVIU News analisa as Métricas de Custo e Inteligência em LLMs, levantando questões sobre a validade das comparações de desempenho e valor.
Notícia atual: um estudo revela a 'lacuna de inference' no modelo Fable 5, mostrando que otimizações em produção reduzem o raciocínio sequencial dos LLMs.
Perguntas frequentes
O que é a 'lacuna de inference' em LLMs?
É a diferença entre o desempenho esperado de um Large Language Model em benchmarks e sua entrega real em produção. Ela ocorre porque o 'orçamento de raciocínio' do modelo, ou seja, a quantidade de pensamento sequencial que ele realiza, é drasticamente reduzido ou fragmentado em um ambiente produtivo, mesmo para o mesmo modelo.
Por que os LLMs apresentam essa 'lacuna' em produção?
Essa lacuna surge de otimizações de custo e latência implementadas em produção. Para economizar recursos computacionais, os provedores de modelos podem diminuir o esforço de inferência, resultando em menos 'tokens de pensamento' e raciocínio sequencial reduzido, embora o modelo base permaneça o mesmo.
Como a 'lacuna de inference' afeta os usuários finais e as empresas?
Para usuários finais, significa respostas de menor qualidade ou menos consistentes. Para empresas, gera resultados imprevisíveis, dificulta a reprodução de capacidades vistas em benchmarks e pode levar a um desperdício de investimento em IA que não atende às expectativas de desempenho.
O que as empresas podem fazer para mitigar a 'lacuna de inference'?
As empresas precisam focar em design de prompts mais robusto e, idealmente, exigir transparência dos provedores sobre o regime de inferência. É importante também realizar testes rigorosos em cenários de produção e considerar que 'otimizações' de custo podem ter um preço na inteligência e confiabilidade do modelo.
Fontes
- x.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 05 de outubro de 2026
- Editoria
- CEVIU Dados