Um problema crítico foi identificado na exportação de dados do Snowflake para o formato Parquet, especificamente ao lidar com a tabela QUERY_HISTORY. Valores numéricos grandes, quando gravados como INT32, podem sofrer corrupção. Para mitigar o risco de *overflows*, *joins* incorretos e análises distorcidas, é essencial realizar o *casting* das nove colunas impactadas para um tipo de dados mais adequado antes de qualquer operação de exportação. Esta prática garante a integridade dos dados e a precisão das análises realizadas.
A equipe da Tailscale dedicou seis meses para investigar e solucionar um persistente problema de corrupção de dados no SQLite. A falha foi identificada como uma rara condição de corrida de 16 anos, ocorrendo entre o checkpointing do Write-Ahead Log (WAL) e transações de escrita. Este cenário era frequentemente exacerbado pela estratégia agressiva de checkpointing manual da empresa. A pesquisa resultou na implementação de um patch oficial para o SQLite, no desenvolvimento de ferramentas de recuperação aprimoradas e ressaltou a importância de operar tecnologias, mesmo as mais consolidadas, dentro de seus parâmetros de uso convencionais para evitar riscos inesperados.
O Comet, um notável acelerador para Spark desenvolvido sobre o Apache DataFusion, acaba de alcançar sua versão 1.0.0. Esta atualização robusta traz consigo o versionamento semântico, suporte completo ao Spark 4 e uma cobertura ampliada de operadores, garantindo maior performance e compatibilidade. A equipe de desenvolvimento investiu em testes rigorosos para assegurar a correção em relação ao pacote original do Spark, posicionando o Comet como uma solução ideal para equipes que buscam otimizar a execução de jobs Spark sem a necessidade de reescrever códigos ou substituir seu ecossistema existente, acelerando pipelines de dados de forma significativa.
A Hex lançou o DataBench, um novo benchmark para testar agentes de IA em cenários analíticos realistas. Os resultados iniciais demonstram que, embora a IA seja eficiente na coleta de evidências, sua performance é limitada em decisões que demandam julgamento e em cenários abertos. Frequentemente, esses modelos geram conclusões onde não há certeza, desconsideram nuances em dados e pecam por superanalisar resultados corretos. Os achados reforçam a insubstituível necessidade da supervisão humana em análises complexas, destacando que a IA ainda não domina a capacidade de discernimento e interpretação contextual que caracteriza a inteligência analítica humana.
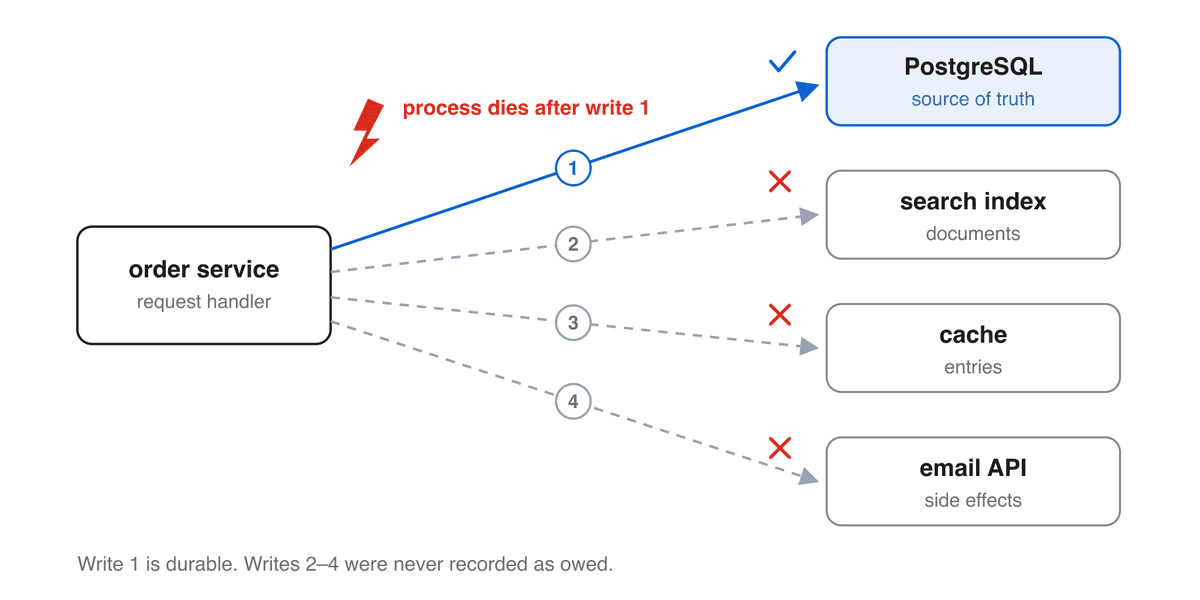
Apesar de o Change-Data-Capture (CDC) facilitar que operações de escrita subsequentes sejam retentáveis, ordenadas e observáveis, ele não assegura a resiliência dos sistemas de destino contra escritas duplicadas. É crucial que o sistema consumidor implemente idempotência durável ou um mecanismo eficiente para rejeitar dados repetidos após a recuperação de falhas. Essa é uma ponderação vital para equipes de arquitetura ao revisar designs, evitando a percepção equivocada de que o CDC, por si só, soluciona automaticamente desafios de consistência.
Um simples número de throughput isolado não deve ser o único fator decisivo em arquiteturas de sistemas de dados. Para que benchmarks sejam eficazes, eles precisam ir além e contextualizar detalhadamente a carga de trabalho, o estado do cache, o comportamento do cliente, os modos de falha e os limites de escalabilidade que geraram determinado resultado. A ausência desse contexto pode levar as equipes a otimizar erroneamente para métricas sintéticas, em vez de solucionar os gargalos reais que os sistemas de dados de produção inevitavelmente enfrentarão.
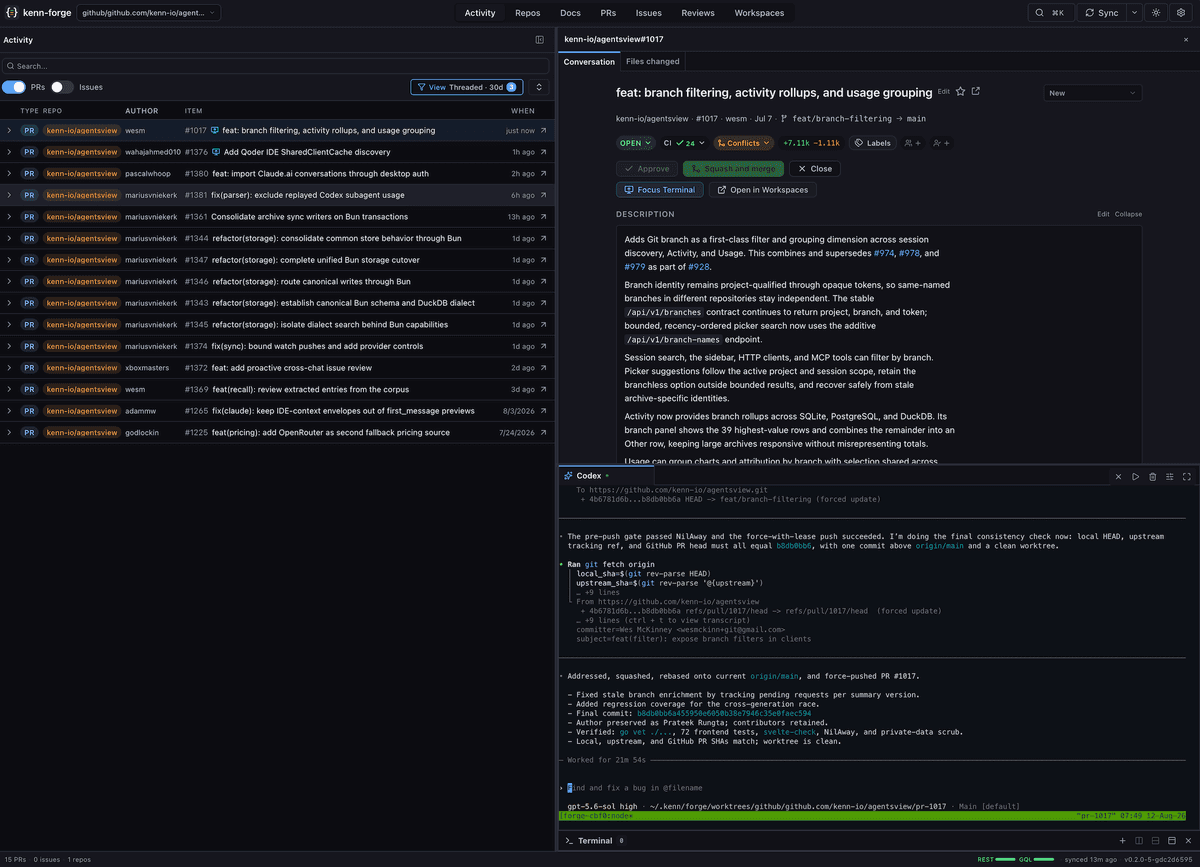
Na vanguarda da Engenharia Agentic, a Kenn está escalando o desenvolvimento de software ao empregar agentes de codificação em larga escala. A abordagem mantém o controle humano centralizado no design, revisão e nas decisões finais, garantindo a qualidade. Utilizando especificações detalhadas, revisões adversariais e um processo contínuo de verificação, uma equipe reduzida de apenas três engenheiros consegue gerar centenas de *pull requests* por semana, eliminando a dependência de ciclos de desenvolvimento autônomos. Este modelo sublinha a importância da supervisão humana mesmo com o avanço da IA.
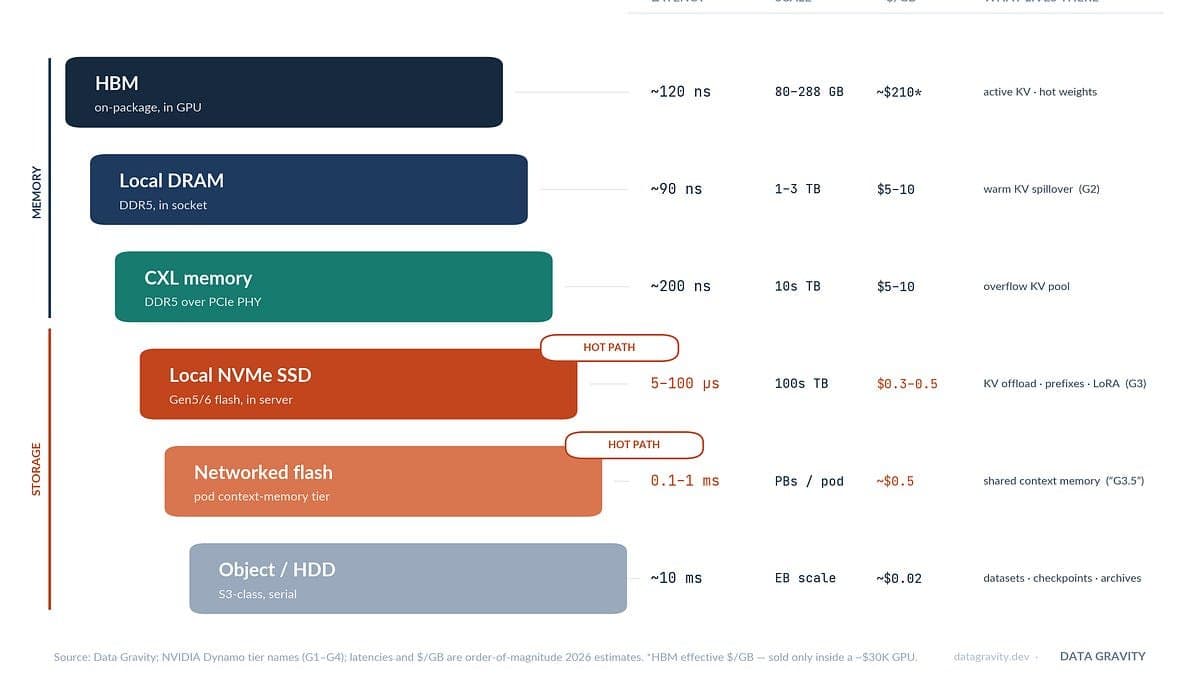
A inferência de IA está transformando a infraestrutura em um sistema stateful, onde sessões de contexto prolongado, agentes, RAG e fluxos de trabalho multimodais geram caches KV, prefixos, memórias e embeddings duráveis. O armazenamento desses dados demonstra ser mais econômico do que recomputá-los, especialmente após múltiplas utilizações. Essa dinâmica eleva a hierarquia de armazenamento ao *hot path*, integrando camadas como HBM, DRAM, SSDs, *object storage*, CXL e *flash*, que agora impactam diretamente a latência e o custo operacional.
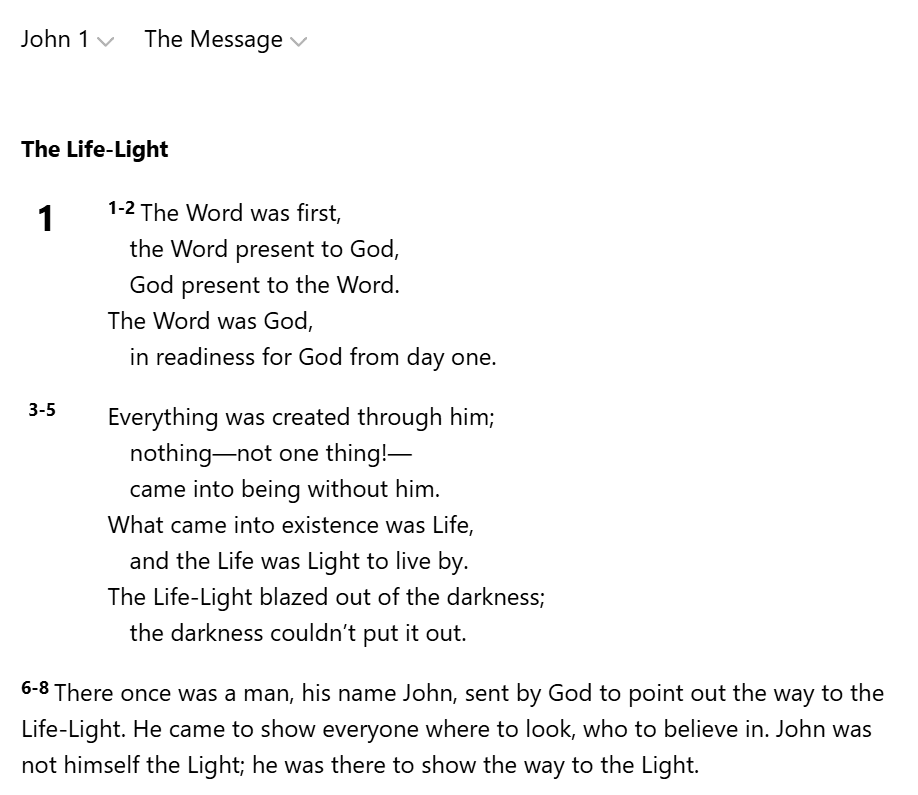
Frequentemente, um modelo de dados aparentemente simples pode esconder uma complexidade surpreendente quando confrontado com os nuances do mundo real. Um estudo de caso envolvendo a estrutura bíblica ilustra essa premissa: elementos como intervalos de versículos, numerações alternativas e capítulos repetidos rapidamente transformam um modelo inicial simplista em algo intrincado. A principal conclusão para profissionais de dados é que a modelagem deve priorizar a funcionalidade exigida pelo produto, em vez de buscar uma representação perfeita por padrão, evitando superengenharia desnecessária e focando na aplicação prática dos requisitos.
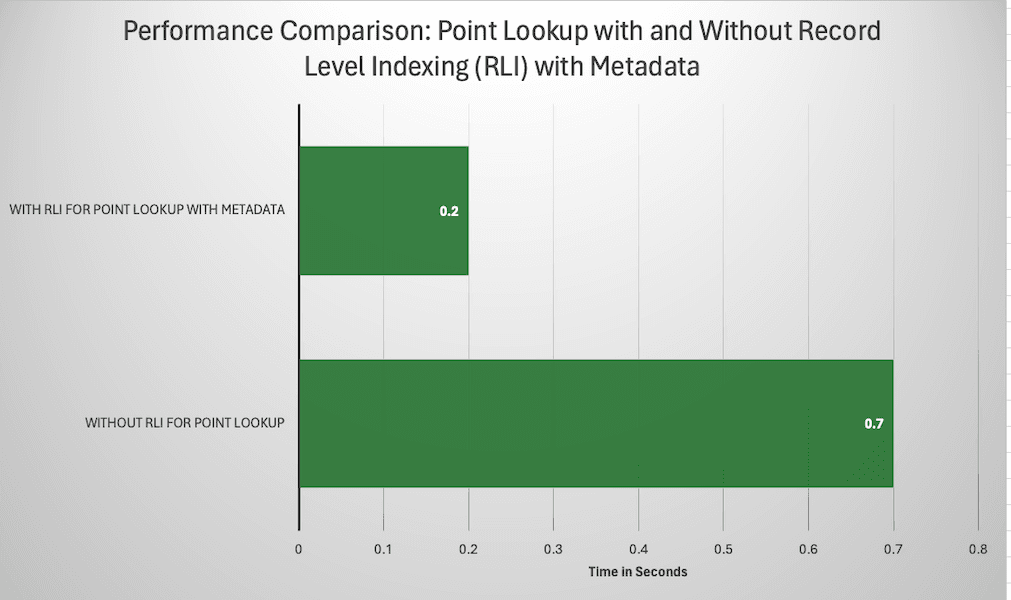
O Apache Hudi introduz uma abordagem inovadora para otimizar workloads intensivos em leitura no Lakehouse, utilizando índices de metadados. Essa funcionalidade permite que leituras seletivas operem mais como buscas diretas em bancos de dados, em vez de varreduras completas. A implementação de índices no nível de registro, secundários, de expressão e bloom-filter filtra predicados de igualdade, direcionando as consultas a um subconjunto reduzido de arquivos e aprimorando significativamente o desempenho.
A Databricks anunciou a aquisição da Electric com o intuito de integrar o PGlite, uma versão leve do PostgreSQL baseada em WASM, diretamente em sandboxes de agentes de IA. Essa estratégica incorporação permitirá que os agentes operem com bancos de dados locais de alta velocidade, otimizando a latência e a independência computacional. Simultaneamente, o estado compartilhado desses agentes será sincronizado com o Lakebase, assegurando uma fonte de dados centralizada e governada, fundamental para a escalabilidade e consistência em arquiteturas de IA distribuídas.
O desvio em modelos de IA, que ocorre quando a performance do sistema se degrada devido à divergência entre dados de produção e as premissas de treinamento, é um desafio crítico para a governança de dados. Essa instabilidade pode ser desencadeada por mudanças no comportamento do usuário, prompts, corpora de retrieval ou regras de negócio. Para mitigar esse risco, equipes de engenharia e dados devem implementar monitoramento rigoroso, abrangendo desvios de dados e conceitos, falhas de pipeline, e anomalias em prompts, embeddings e outputs de sistemas LLM e RAG. A detecção eficaz combina o estabelecimento de linhas de base, verificações de distribuição, telemetria detalhada, avaliação da conclusão de tarefas e análise do feedback do usuário, garantindo a performance e a integridade contínua do modelo em ambientes reais.
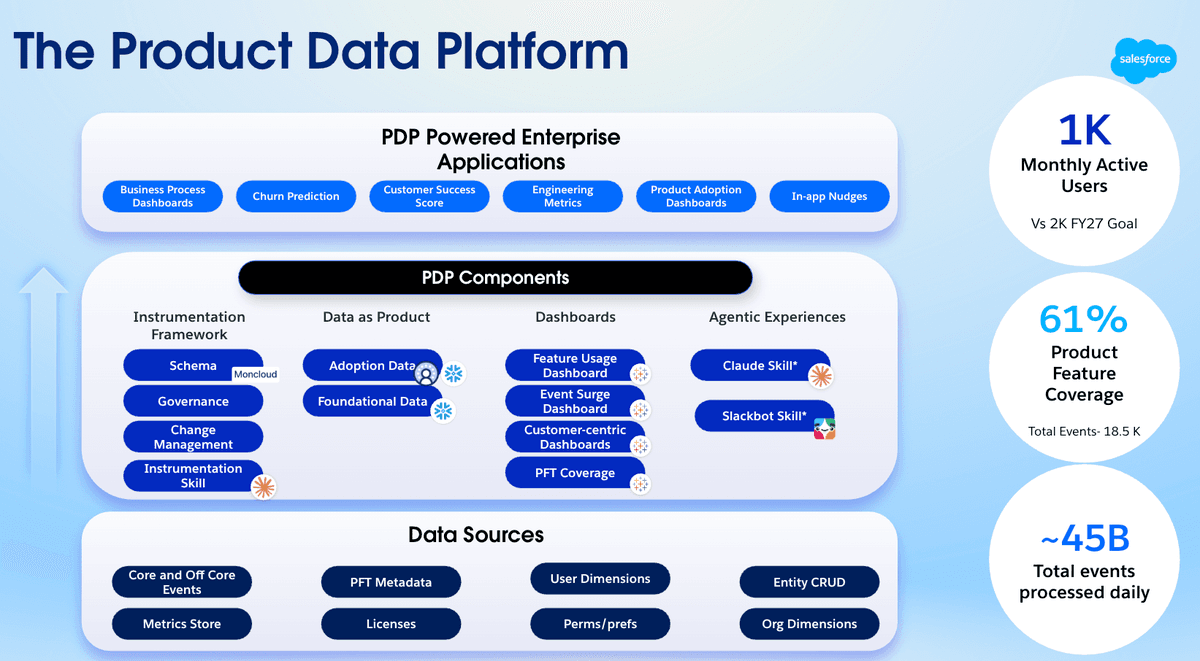
A Salesforce implementou uma Plataforma de Dados de Produto unificada para padronizar a telemetria de produto, superando a fragmentação de pipelines e equipes. Essa nova abordagem estabelece um esquema de dados comum que automatiza a geração de métricas confiáveis sobre a adoção de produtos. Processando impressionantes 45 bilhões de linhas diariamente, abrangendo 19.000 eventos e mais de 2.000 funcionalidades, a plataforma conseguiu reduzir drasticamente o tempo necessário para obter insights e minimizar o esforço manual de instrumentação para apenas algumas horas, otimizando a eficiência e a agilidade nas análises de produto.
Muitos projetos de Knowledge Graph enfrentam dificuldades ao serem abordados como bancos de dados relacionais tradicionais. Erros frequentes incluem a conversão direta de SQL para RDF, arquitetura orientada a linhas, deduplicação ineficaz e escopo de projeto demasiadamente amplo, resultando em sistemas ineficientes e lentos. Para assegurar o êxito, é crucial iniciar com casos de uso bem definidos, adotar uma implementação faseada ou federada, utilizar APIs controladas, empregar a estrutura SHACL e detalhar a proveniência dos dados. É recomendável também que consultas sejam feitas sob demanda, mantendo a independência entre o modelo lógico e o *backend* subjacente.
O Maestro, orquestrador de workflows open-source da Netflix, segue em constante aprimoramento, prometendo otimizar data-pipelines, fluxos de Machine Learning e processamento em lote em larga escala. Distribuído sob a licença Apache-2.0, esta solução se estabelece como um control plane robusto, nascido da experiência de produção da gigante do streaming. A ferramenta se apresenta como uma alternativa viável ao Airflow e um complemento para estratégias de orquestração existentes, sendo um projeto de destaque para equipes de dados e MLOps que buscam eficiência e escalabilidade.
O NATS 2.12 chega com uma funcionalidade crucial para o JetStream: a publicação atômica em lotes. Essa inovação permite que produtores realizem commits de grupos de mensagens relacionadas como uma única unidade, garantindo o padrão "tudo ou nada". Na prática, isso simplifica a construção de sistemas "event-sourced", facilita o "fan-out" para múltiplos tópicos e aprimora fluxos de trabalho de substituição de estado, eliminando a necessidade de lógicas de recuperação complexas para evitar escritas parciais. Além disso, a segurança da concorrência é reforçada por verificações de consistência, como os cabeçalhos de sequência esperada.
A Meta lançou o Muse Glimmer, um modelo de 30 bilhões de parâmetros e peso aberto, projetado para viabilizar a execução de fluxos de trabalho de agentes de IA diretamente em dispositivos locais. Esta inovação permite que o modelo opere em GPUs de consumidor, desde que quantizado para ocupar menos de 20 GB, democratizando o acesso a capacidades avançadas de IA e reduzindo a dependência de infraestruturas de nuvem. Tal desenvolvimento abre novas fronteiras para aplicações de IA distribuída e de borda, otimizando processamentos e privacidade dos dados.
Os Agentes de IA estão se tornando cada vez mais relevantes para otimizar tarefas repetitivas e mecânicas no trabalho com dados, como validação de hipóteses, diagnóstico de alterações de esquema, manutenção de contexto e correção de pipelines. Contudo, a geração de insights proativos e automatizados ainda enfrenta desafios significativos, dada a complexidade de determinar a relevância e o risco elevado de falsos positivos. Para uma implementação eficaz, as equipes de dados devem investir em avaliações rigorosas, contextualização explícita do negócio e infraestrutura de baixa latência, apta a suportar cargas de trabalho paralelas e intermitentes desses agentes.
A inclusão de filtros de metadados na busca vetorial pode impactar negativamente a performance ao segmentar o grafo HNSW em subgrafos isolados. A Qdrant realizou um estudo aprofundado, comparando o HNSW filtrável, a otimização ACORN, varreduras completas e diferentes estratégias de planejamento sobre um dataset de um milhão de vetores. A pesquisa detalhou as condições em que a adição de arestas durante a indexação se mostra superior a ajustes no tempo de consulta, destacando os cenários ideais para a aplicação da expansão ACORN.
O mundo da engenharia de dados ganha um novo aliado com o lançamento do sqlfmt, uma ferramenta de formatação SQL inspirada no rigor do gofmt. Adotando o estilo "river alignment" de Dimitri Fontaine, o utilitário impõe padrões como palavras-chave em minúsculas, indentação consistente e organização de vírgulas e comentários. Sua robustez advém da tokenização, dispensando a Análise Sintática Abstrata (AST), e ele pode ser executado tanto via CLI quanto no navegador, graças ao WASM. Crucialmente, o sqlfmt garante que a formatação visual não altere a semântica da query, preservando a integridade das operações no banco de dados.