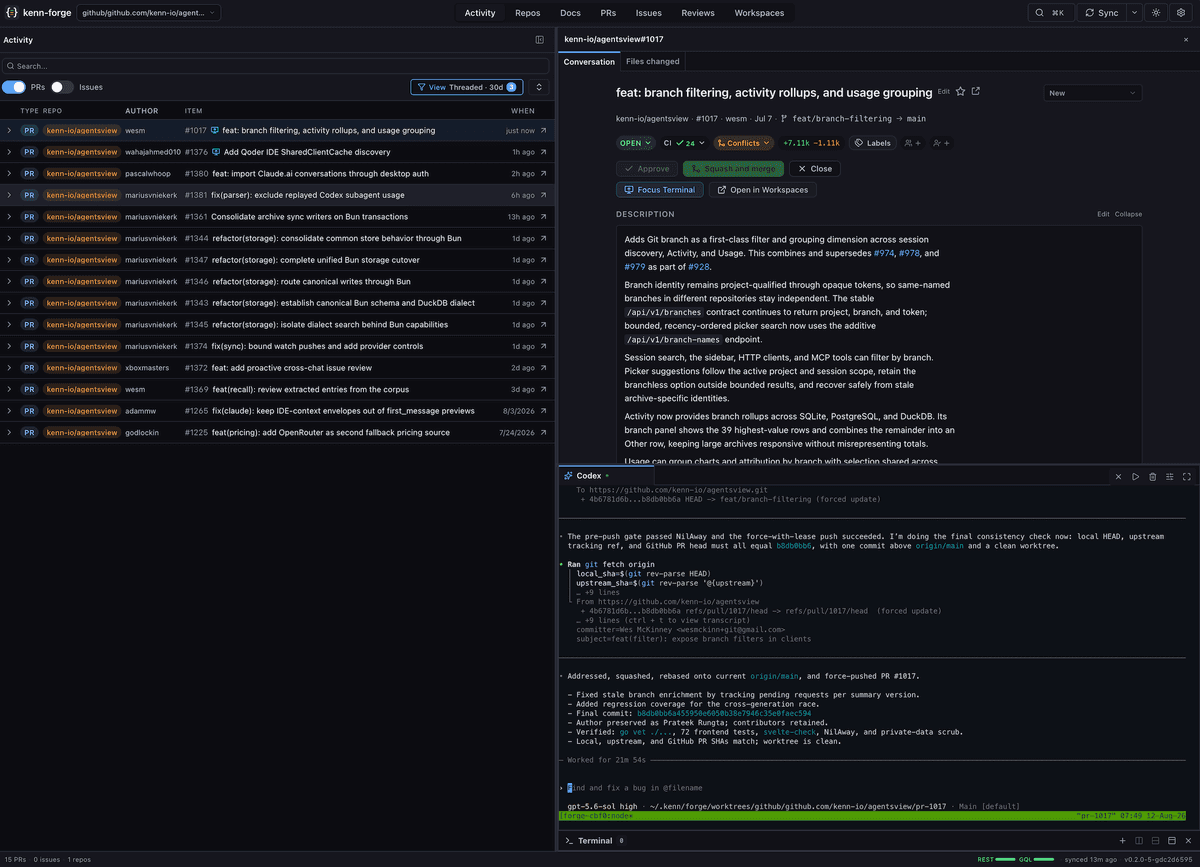
Na vanguarda da Engenharia Agentic, a Kenn está escalando o desenvolvimento de software ao empregar agentes de codificação em larga escala. A abordagem mantém o controle humano centralizado no design, revisão e nas decisões finais, garantindo a qualidade. Utilizando especificações detalhadas, revisões adversariais e um processo contínuo de verificação, uma equipe reduzida de apenas três engenheiros consegue gerar centenas de *pull requests* por semana, eliminando a dependência de ciclos de desenvolvimento autônomos. Este modelo sublinha a importância da supervisão humana mesmo com o avanço da IA.
O desvio em modelos de IA, que ocorre quando a performance do sistema se degrada devido à divergência entre dados de produção e as premissas de treinamento, é um desafio crítico para a governança de dados. Essa instabilidade pode ser desencadeada por mudanças no comportamento do usuário, prompts, corpora de retrieval ou regras de negócio. Para mitigar esse risco, equipes de engenharia e dados devem implementar monitoramento rigoroso, abrangendo desvios de dados e conceitos, falhas de pipeline, e anomalias em prompts, embeddings e outputs de sistemas LLM e RAG. A detecção eficaz combina o estabelecimento de linhas de base, verificações de distribuição, telemetria detalhada, avaliação da conclusão de tarefas e análise do feedback do usuário, garantindo a performance e a integridade contínua do modelo em ambientes reais.
O pooling de conexões consolidou-se como um componente indispensável para arquiteturas que utilizam PostgreSQL, a ponto de muitos questionarem o porquê dessa funcionalidade não estar nativamente incorporada ao próprio sistema de gerenciamento de banco de dados. A discussão central gira em torno da necessidade e dos benefícios de ferramentas como o PgBouncer na otimização da performance e gestão de recursos em ambientes de alta demanda, evidenciando sua importância para a estabilidade e escalabilidade das aplicações.
O NATS 2.12 chega com uma funcionalidade crucial para o JetStream: a publicação atômica em lotes. Essa inovação permite que produtores realizem commits de grupos de mensagens relacionadas como uma única unidade, garantindo o padrão "tudo ou nada". Na prática, isso simplifica a construção de sistemas "event-sourced", facilita o "fan-out" para múltiplos tópicos e aprimora fluxos de trabalho de substituição de estado, eliminando a necessidade de lógicas de recuperação complexas para evitar escritas parciais. Além disso, a segurança da concorrência é reforçada por verificações de consistência, como os cabeçalhos de sequência esperada.
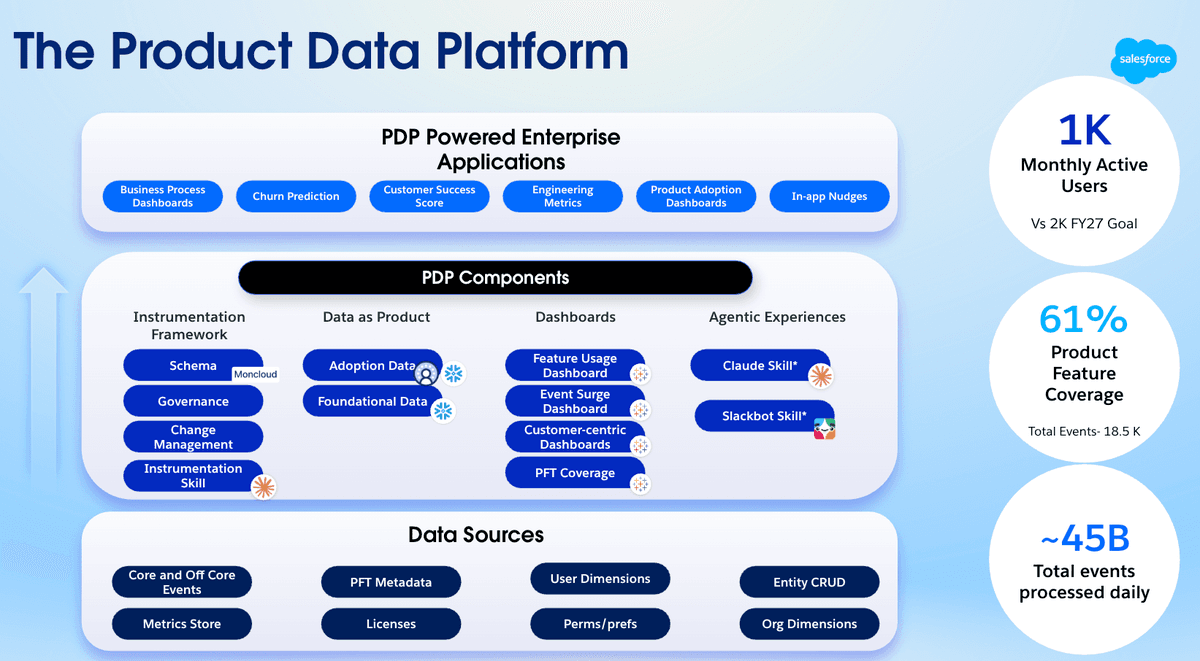
A Salesforce implementou uma Plataforma de Dados de Produto unificada para padronizar a telemetria de produto, superando a fragmentação de pipelines e equipes. Essa nova abordagem estabelece um esquema de dados comum que automatiza a geração de métricas confiáveis sobre a adoção de produtos. Processando impressionantes 45 bilhões de linhas diariamente, abrangendo 19.000 eventos e mais de 2.000 funcionalidades, a plataforma conseguiu reduzir drasticamente o tempo necessário para obter insights e minimizar o esforço manual de instrumentação para apenas algumas horas, otimizando a eficiência e a agilidade nas análises de produto.
O Maestro, orquestrador de workflows open-source da Netflix, segue em constante aprimoramento, prometendo otimizar data-pipelines, fluxos de Machine Learning e processamento em lote em larga escala. Distribuído sob a licença Apache-2.0, esta solução se estabelece como um control plane robusto, nascido da experiência de produção da gigante do streaming. A ferramenta se apresenta como uma alternativa viável ao Airflow e um complemento para estratégias de orquestração existentes, sendo um projeto de destaque para equipes de dados e MLOps que buscam eficiência e escalabilidade.
A Meta lançou o Muse Glimmer, um modelo de 30 bilhões de parâmetros e peso aberto, projetado para viabilizar a execução de fluxos de trabalho de agentes de IA diretamente em dispositivos locais. Esta inovação permite que o modelo opere em GPUs de consumidor, desde que quantizado para ocupar menos de 20 GB, democratizando o acesso a capacidades avançadas de IA e reduzindo a dependência de infraestruturas de nuvem. Tal desenvolvimento abre novas fronteiras para aplicações de IA distribuída e de borda, otimizando processamentos e privacidade dos dados.
Ferramentas e conceitos fundamentais como data warehousing, SQL, modelagem de dados, semantic layers e Business Intelligence não estão fadados à obsolescência, mas sim em constante evolução. A percepção de que a IA 'matará' essas tecnologias confunde automação com substituição. Embora os LLMs possam gerar código, eles não suplantam a semântica de negócios, a governança de dados ou o discernimento arquitetônico. A verdadeira transformação reside na automação e comoditização de responsabilidades, e não na extinção dessas camadas essenciais da stack tecnológica.
O mundo da engenharia de dados ganha um novo aliado com o lançamento do sqlfmt, uma ferramenta de formatação SQL inspirada no rigor do gofmt. Adotando o estilo "river alignment" de Dimitri Fontaine, o utilitário impõe padrões como palavras-chave em minúsculas, indentação consistente e organização de vírgulas e comentários. Sua robustez advém da tokenização, dispensando a Análise Sintática Abstrata (AST), e ele pode ser executado tanto via CLI quanto no navegador, graças ao WASM. Crucialmente, o sqlfmt garante que a formatação visual não altere a semântica da query, preservando a integridade das operações no banco de dados.
Os Agentes de IA estão se tornando cada vez mais relevantes para otimizar tarefas repetitivas e mecânicas no trabalho com dados, como validação de hipóteses, diagnóstico de alterações de esquema, manutenção de contexto e correção de pipelines. Contudo, a geração de insights proativos e automatizados ainda enfrenta desafios significativos, dada a complexidade de determinar a relevância e o risco elevado de falsos positivos. Para uma implementação eficaz, as equipes de dados devem investir em avaliações rigorosas, contextualização explícita do negócio e infraestrutura de baixa latência, apta a suportar cargas de trabalho paralelas e intermitentes desses agentes.
A Stripe aprimorou a recuperação de incidentes em seu ambiente MongoDB global, ao modelar a frota de bancos de dados como um grafo. A abordagem permite a geração dinâmica de planos de remediação, adaptando-se a variados layouts de sharding. Com isso, a empresa conseguiu reduzir os alertas de pager em cerca de 30% e evitar aproximadamente 12 dias anuais de estados de shard não saudáveis. O planejamento, que se baseia no algoritmo de Dijkstra, substitui fluxos de trabalho menos robustos, garantindo recuperação parcial mesmo na ausência de um caminho completo, otimizando a resiliência operacional.
Muitos projetos de Knowledge Graph enfrentam dificuldades ao serem abordados como bancos de dados relacionais tradicionais. Erros frequentes incluem a conversão direta de SQL para RDF, arquitetura orientada a linhas, deduplicação ineficaz e escopo de projeto demasiadamente amplo, resultando em sistemas ineficientes e lentos. Para assegurar o êxito, é crucial iniciar com casos de uso bem definidos, adotar uma implementação faseada ou federada, utilizar APIs controladas, empregar a estrutura SHACL e detalhar a proveniência dos dados. É recomendável também que consultas sejam feitas sob demanda, mantendo a independência entre o modelo lógico e o *backend* subjacente.
A Databricks anunciou a aquisição da Electric com o intuito de integrar o PGlite, uma versão leve do PostgreSQL baseada em WASM, diretamente em sandboxes de agentes de IA. Essa estratégica incorporação permitirá que os agentes operem com bancos de dados locais de alta velocidade, otimizando a latência e a independência computacional. Simultaneamente, o estado compartilhado desses agentes será sincronizado com o Lakebase, assegurando uma fonte de dados centralizada e governada, fundamental para a escalabilidade e consistência em arquiteturas de IA distribuídas.
A inclusão de filtros de metadados na busca vetorial pode impactar negativamente a performance ao segmentar o grafo HNSW em subgrafos isolados. A Qdrant realizou um estudo aprofundado, comparando o HNSW filtrável, a otimização ACORN, varreduras completas e diferentes estratégias de planejamento sobre um dataset de um milhão de vetores. A pesquisa detalhou as condições em que a adição de arestas durante a indexação se mostra superior a ajustes no tempo de consulta, destacando os cenários ideais para a aplicação da expansão ACORN.
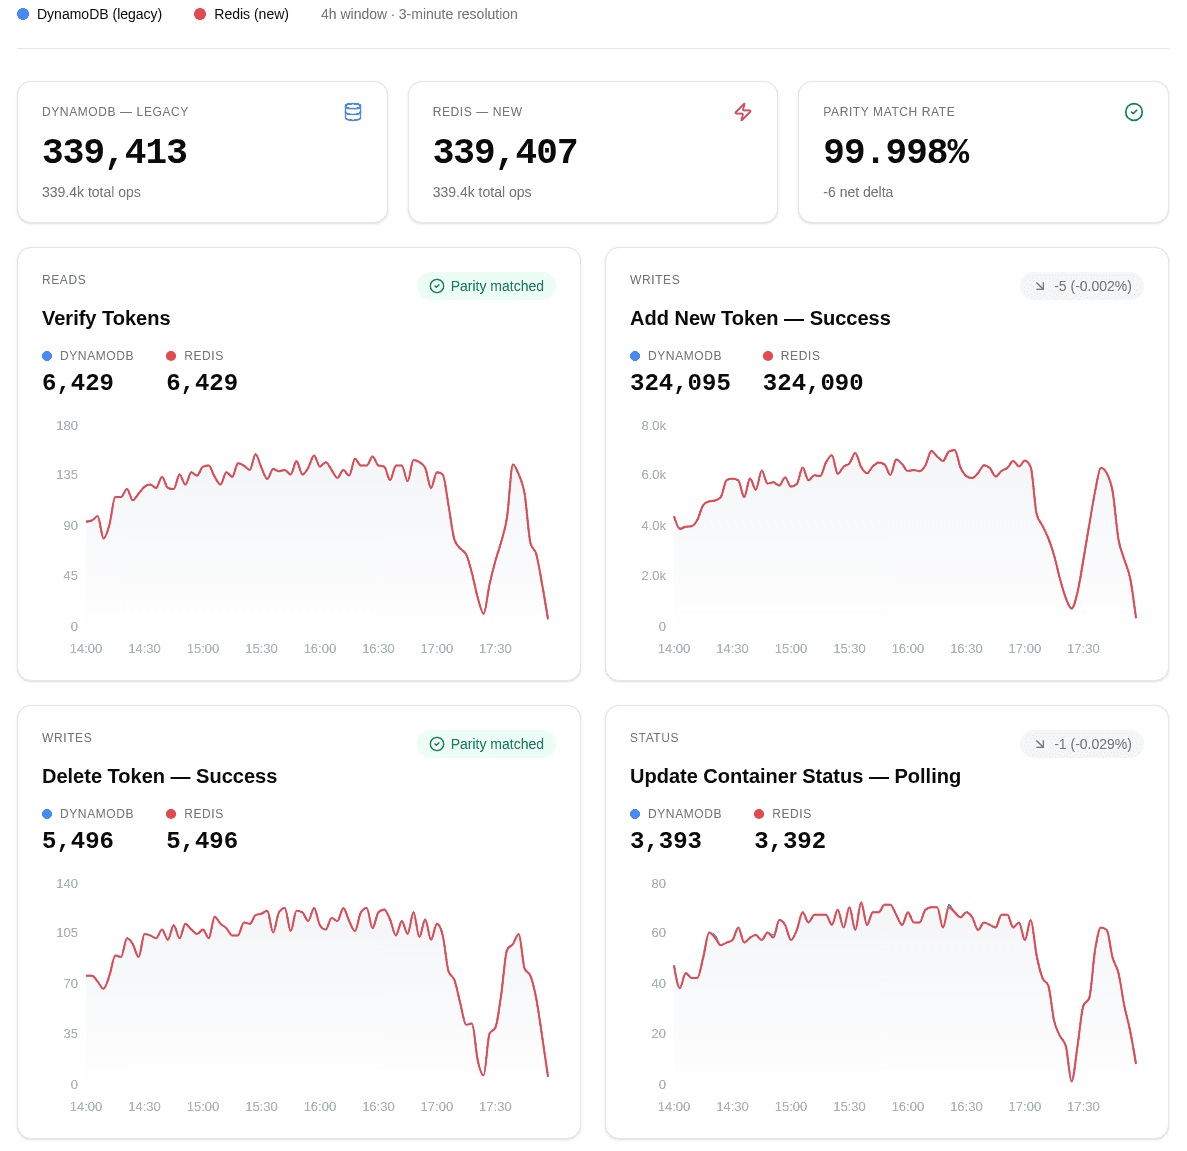
A Vercel, renomada plataforma de desenvolvimento web, realizou uma migração crucial de seu estado de pool de builds 'quentes', movendo-o do Redis para o DynamoDB. A transição visou assegurar o armazenamento durável de dados críticos, como informações de faturamento e mapeamentos de contêineres, elementos fundamentais para a operação da plataforma. O processo foi meticulosamente planejado, utilizando escritas duplas, leituras de 'sombra', 'feature flags' e validações em produção para garantir uma transição sem interrupções. Durante a implementação, a equipe da Vercel identificou uma dependência não prevista na latência ultrabaixa do Redis, exigindo um redesenho do 'supply loop' para um modelo N+1, otimizando a concorrência e abandonando as leituras serializadas.
O Kestra 2.0 se aproxima com a liberação de seus *release candidates*, destacando uma engine de execução completamente nova e uma interface de usuário (UI) repaginada. Esta atualização é considerada a maior já lançada para o orquestrador, trazendo consigo *breaking changes* que exigem atenção dos desenvolvedores. A comunidade é convidada a testar fluxos de trabalho e caminhos de migração, preparando-se para a disponibilidade geral e garantindo uma transição suave para as novas funcionalidades.
A Physical Intelligence reformulou sua arquitetura de dados de robótica, migrando cargas de trabalho transacionais para o PostgreSQL e direcionando as analíticas de alta cardinalidade para o ClickHouse. A mudança ocorreu após a solução anterior, baseada em um único banco de dados RDS, não conseguir mais escalar, enfrentando gargalos significativos. Com a nova abordagem, a empresa pode agora gerenciar dezenas de bilhões de linhas de metadados, possibilitando buscas rápidas e exploração de dados orientada por agentes que, anteriormente, levavam dias ou semanas para serem processadas.
A biblioteca Pointblank surge como uma alternativa robusta para a validação de dados em Python, integrando-se nativamente com pandas, Polars, DuckDB e PostgreSQL. Com uma abordagem focada em regras declarativas, thresholds configuráveis e tratamento automatizado de falhas, a ferramenta se destaca pela capacidade de implementar 'quality gates' rigorosos e quarentena de linhas problemáticas. Ao invés de frameworks mais abrangentes, o Pointblank visa fornecer relatórios claros e concisos, acessíveis até mesmo para stakeholders não técnicos, garantindo um controle de qualidade de dados mais direto e eficiente no ambiente de Data Engineering.
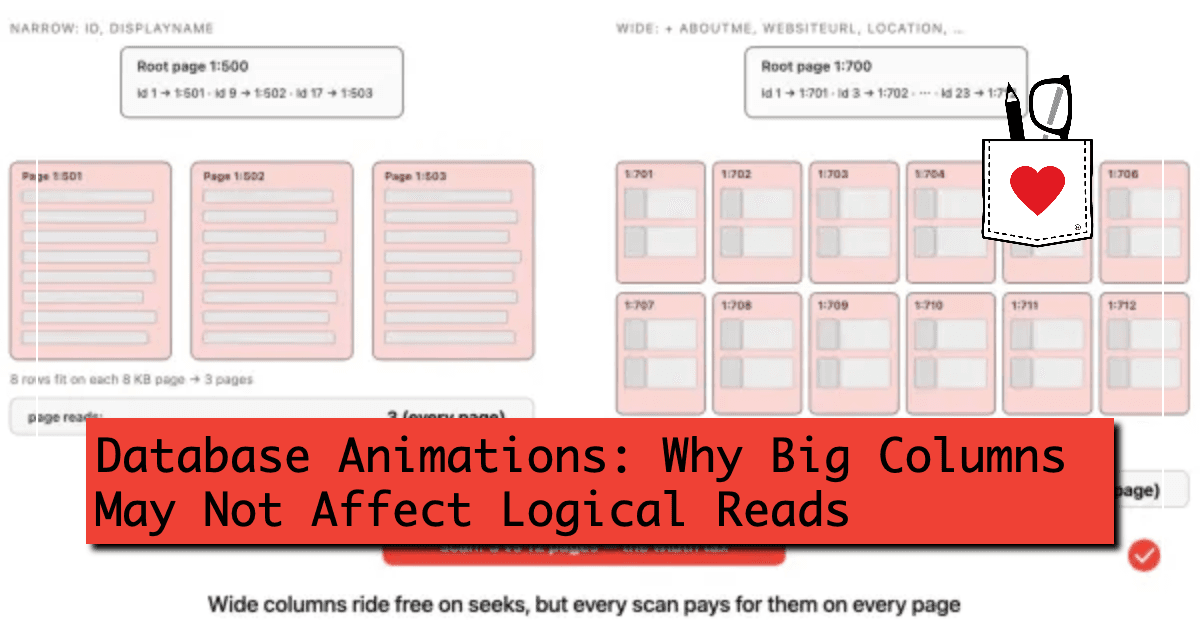
No universo do SQL Server, a performance de consultas é um tópico crítico, especialmente quando o design de tabelas envolve colunas de grande largura. Contrariamente ao senso comum, tais colunas afetam principalmente as operações que envolvem varreduras completas ou leituras de múltiplos registros. Para buscas pontuais, a eficiência pode ser mantida, já que os dados ainda conseguem se acomodar em uma única página de 8KB, minimizando o impacto nas leituras lógicas e otimizando o processamento de dados para aplicações que dependem de acesso rápido a registros específicos.
A governança de dados corporativos enfrenta um desafio central: a titularidade de dados (data ownership) perde eficácia quando a responsabilidade não é acompanhada de autonomia decisória. É crucial que os proprietários dos dados tenham a prerrogativa de definir limites de qualidade, gerenciar riscos e autorizar usos, evitando impasses que limitam a agilidade e a conformidade. Uma estrutura de governança robusta exige clareza nas autoridades e processos de escalonamento bem definidos, onde as decisões são tomadas pelos proprietários e implementadas pelos data stewards. Dessa forma, garante-se que cada decisão tenha um responsável claro e que a aceitação de riscos seja transparente e rastreável, fortalecendo a integridade e o valor estratégico dos ativos de dados.