
WHOOP Otimiza Pipelines de Inferência de IA em Batch para Seis Dias
Aprofundamento CEVIU
Aprofundamento
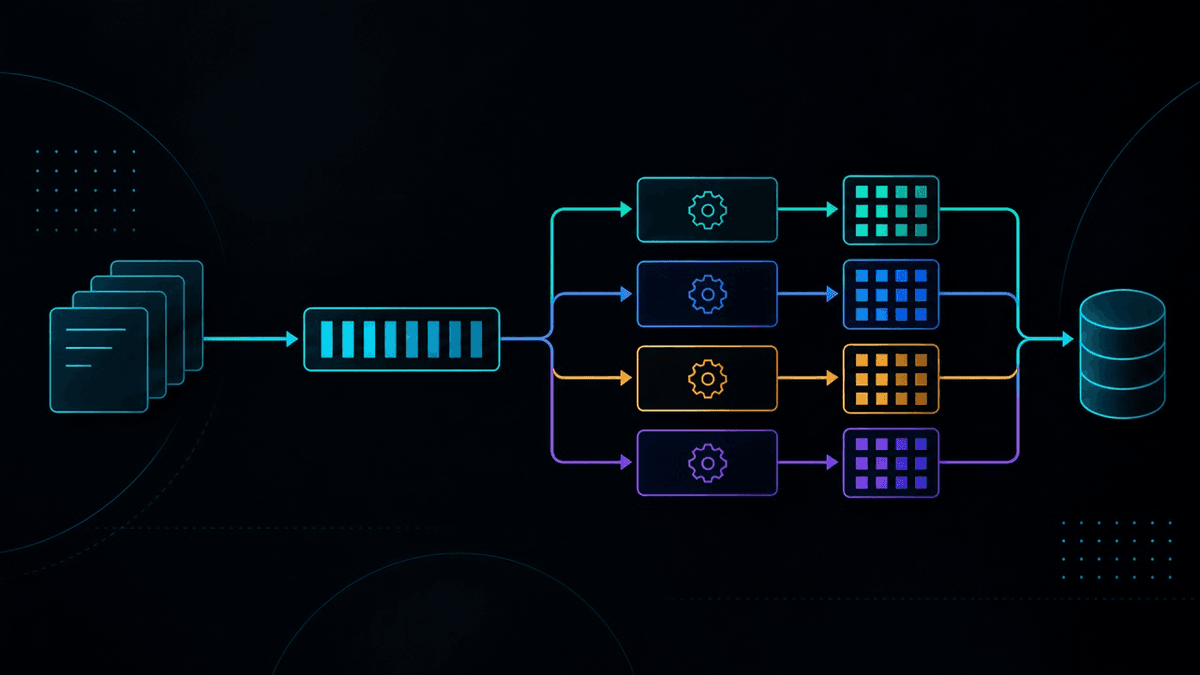
A WHOOP alcançou um feito notável na otimização de seus pipelines de inferência de IA em batch, cortando o tempo de processamento de meses para apenas seis dias. A chave foi atacar gargalos de latência e garantir a robustez do sistema em escala. A equipe eliminou as chamadas HTTP por tarefa, incorporando diretamente o modelo nos workers. Esta mudança sozinha reduziu o tempo por tarefa de 45 para 21 segundos. Também ajustou a alocação de CPU dos pods e resolveu deadlocks causados pelo método fork do Python em bibliotecas nativas, como XGBoost e NumPy, optando pelo spawn para isolar os processos.
Para garantir a integridade dos dados, especialmente com a entrega at-least-once do SQS, a WHOOP implementou um sistema de idempotência inteligente. Em vez de simplesmente sobrescrever arquivos, a solução agora captura a exceção de "arquivo já existe" durante as gravações atômicas no S3. Isso evita a duplicação de tarefas e o risco de inconsistências. A refatoração do encadeamento de estado via SQS permitiu que as mensagens carregassem o estado necessário para a próxima etapa, desacoplando a execução e possibilitando a distribuição do processamento em diferentes pods.
O que mudou
A abordagem da WHOOP para otimizar a inferência de IA em batch se soma a um conjunto de esforços recentes na indústria para escalar IA. Em 2 de setembro de 2026, por exemplo, o CEVIU News noticiou a "Otimização Revolucionária na Inferência de LLMs", que focava em redução de custos e eficiência para Grandes Modelos de Linguagem. Enquanto a otimização de LLMs se concentra na gestão de parâmetros e arquiteturas de modelos gigantes, a WHOOP detalha soluções práticas para gargalos de infraestrutura em pipelines de inferência, como chamadas de rede e gerenciamento de processos.
A evolução não é de uma tecnologia substituindo a outra, mas de diferentes frentes de otimização se complementando. As soluções da WHOOP, ao lidar com a eficiência de CPU, processamento paralelo e idempotência em larga escala, oferecem um blueprint para outras empresas que enfrentam desafios semelhantes em cargas de trabalho de IA com muitos dados. Este caso mostra que, além da otimização do modelo em si, a engenharia de pipeline continua sendo um pilar fundamental para a escalabilidade da IA.
Por que isso importa
A otimização dos pipelines de inferência de IA é crucial para empresas que dependem de análises de dados em grande escala. No caso da WHOOP, a capacidade de processar 15,8 milhões de tarefas em seis dias, em vez de dois meses, permite que as equipes de pesquisa obtenham insights rapidamente. Isso acelera o ciclo de desenvolvimento de produtos e a validação de hipóteses, dando à empresa uma vantagem competitiva significativa.
A capacidade de escalar a inferência de IA de forma eficiente também impacta diretamente os custos operacionais. Reduzir o tempo de processamento significa menos recursos computacionais sendo utilizados por longos períodos. As lições aprendidas pela WHOOP, como a importância de eliminar latências de rede e gerenciar a idempotência em sistemas distribuídos, fornecem insights valiosos para a arquitetura de sistemas de IA, tornando-os mais performáticos, econômicos e confiáveis.
Linha do tempo
CEVIU noticia otimização revolucionária na inferência de LLMs.
WHOOP otimiza pipelines de inferência de IA em batch, reduzindo tempo de processamento para seis dias.
Perguntas frequentes
Qual foi o principal problema que a WHOOP resolveu?
A WHOOP precisava acelerar a inferência de IA em batch para 15,8 milhões de tarefas. O processo original levaria mais de dois meses, o que era inaceitável para as necessidades de pesquisa da empresa. O principal problema era a latência por tarefa.
Como a WHOOP eliminou as chamadas HTTP, que eram um gargalo?
A equipe da WHOOP removeu as chamadas HTTP integrando o serviço de classificação diretamente ao worker como uma biblioteca. Isso permitiu que o modelo fosse carregado uma vez por processo e executado diretamente nos dados, reduzindo significativamente a latência de rede.
Por que o método <code>spawn</code> do Python foi crucial para a otimização?
O método spawn foi crucial porque o fork padrão do Python no Linux causava deadlocks. Bibliotecas nativas, como XGBoost e NumPy, inicializavam pools de threads e locks, que o fork copiava para os processos filhos sem os threads correspondentes. O spawn inicializa cada worker como um interpretador Python novo, evitando esse problema de locks herdados.
Como a WHOOP garantiu a idempotência com SQS e S3?
A WHOOP garantiu a idempotência fazendo com que as gravações no S3 fossem atômicas e capturando a exceção de "arquivo já existe". Se outro worker já tivesse completado a gravação, o worker atual sairia cedo sem re-enfileirar a próxima tarefa, evitando duplicações. O estado da tarefa encadeada também era passado via SQS, garantindo que o progresso fosse consistente mesmo com retentativas.
Fontes
- engineering.whoop.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 28 de setembro de 2026
- Editoria
- CEVIU Dados