
A Evolução da Modelagem de Dados: Desafios e Convergência em Cinco Campos Cruciais
Aprofundamento CEVIU
Aprofundamento
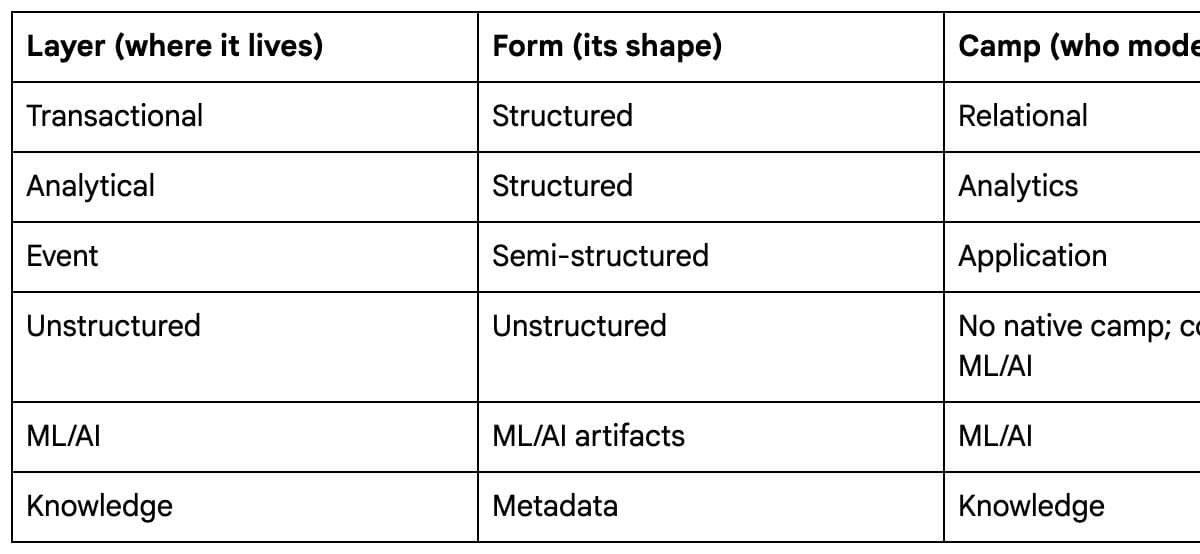
A modelagem de dados, antes vista como uma disciplina monolítica, hoje se manifesta em cinco vertentes principais: relacional, analítica, de aplicação, para ML/IA e de conhecimento/ontologia. Cada campo desenvolveu técnicas e focos específicos para resolver problemas distintos, como a integridade transacional dos sistemas relacionais ou a otimização de consultas em modelos analíticos. A consequência de ignorar a interconexão entre essas abordagens é a criação de silos de dados e complexidade desnecessária.
Um cenário comum, por exemplo, é a equipe de desenvolvimento usar um campo JSON robusto para um catálogo de produtos. Essa decisão agiliza o trabalho deles, mas pode criar um pesadelo para a equipe de analytics, que precisa extrair informações consistentes para dashboards. O mesmo vale para equipes de ML que tentam extrair features de dados sem uma estrutura clara. A falta de um vocabulário compartilhado e de definições coerentes entre esses campos gera pipelines frágeis, dashboards inconsistentes e projetos de IA que falham por falta de confiança nos dados.
O que mudou
A cobertura anterior do CEVIU já indicava a complexidade crescente do ecossistema de dados. Em maio de 2026, a matéria “Cinco Mundos da Engenharia de Dados” explorou os diferentes modelos operacionais. Em março de 2026, “Além do Armazenamento Vetorial: Construindo a Camada Completa de Dados para Aplicações de IA” e “A arquitetura de dados em camadas como pilar para a IA corporativa”, de agosto de 2026, destacaram a necessidade de camadas integradas e componentes além dos bancos de dados convencionais para suportar a IA.
O que antes era uma série de desafios e a identificação de componentes para a IA, como discutido na matéria de setembro de 2026, “Desafios e Estratégias na Análise de Dados com IA Agentiva”, agora converge para uma compreensão de que a integração dessas cinco vertentes da modelagem de dados não é uma opção, mas uma exigência. A notícia atual formaliza que a compreensão compartilhada e a integração são a chave, evoluindo da identificação das partes para a exigência de uma arquitetura unificada. A abordagem de “Canônicos Componíveis”, mencionada em julho de 2026, já apontava para essa direção, buscando unificar o conhecimento de domínio em modelos versionados.
Por que isso importa
A fragmentação na modelagem de dados é um dos maiores gargalos para a agilidade e a confiança nas decisões baseadas em dados. Quando cada equipe modela os dados de forma isolada, pensando apenas nas suas necessidades, o resultado são retrabalhos, projetos atrasados e dashboards que ninguém confia. Isso afeta diretamente a capacidade de uma empresa de inovar, especialmente com o avanço da IA.
A convergência dessas cinco vertentes da modelagem de dados é crucial para construir um stack de dados moderno e eficaz. Garante que os dados sejam consistentes, confiáveis e utilizáveis por todos os consumidores, desde as aplicações transacionais até os modelos de IA mais sofisticados. Adotar uma visão holística da modelagem de dados é essencial para evitar o cenário de “confiança zero” nos dados e permitir que as organizações escalem suas iniciativas de IA e análise.
Linha do tempo
CEVIU News publica 'Além do Armazenamento Vetorial: Construindo a Camada Completa de Dados para Aplicações de IA'.
CEVIU News publica 'Projeções para o Futuro do Stack de Dados Moderno'.
CEVIU News publica 'Cinco Mundos da Engenharia de Dados'.
CEVIU News publica 'Canônicos Componíveis: A Evolução da Governança de Dados e o Papel da IA'.
CEVIU News publica 'A arquitetura de dados em camadas como pilar para a IA corporativa: além dos bancos de dados convencionais'.
CEVIU News publica 'Desafios e Estratégias na Análise de Dados com IA Agentiva'.
CEVIU News publica 'A Evolução da Modelagem de Dados: Desafios e Convergência em Cinco Campos Cruciais'.
Perguntas frequentes
O que são os cinco campos da modelagem de dados?
São as cinco vertentes principais da modelagem de dados: relacional (para integridade transacional), analítica (para queries e relatórios), de aplicação (para performance de app), para ML/IA (para treinamento de algoritmos) e de conhecimento/ontologia (para definir termos de negócio e semântica). Cada um resolve problemas específicos, mas pode criar silos quando usado de forma isolada.
Por que a abordagem isolada de modelagem de dados é um problema?
Modelar dados em silos leva a problemas como pipelines de dados frágeis, dashboards inconsistentes e projetos de IA comprometidos. A falta de um entendimento comum e de uma arquitetura integrada entre as equipes resulta em retrabalho, perda de confiança nos dados e gargalos que impedem a inovação e a tomada de decisões eficazes.
Como a IA afeta a necessidade de uma modelagem de dados integrada?
A ascensão da IA, especialmente LLMs e agentes, exige que os dados sejam compreendidos de forma unificada. Um modelo de IA precisa que as representações dos dados (seja um registro transacional, uma feature ou um nó de grafo) sejam consistentes e façam sentido. A modelagem integrada é essencial para evitar que a IA gere resultados imprecisos ou sem contexto.
Qual a importância de uma arquitetura de dados em camadas para essa integração?
Uma arquitetura de dados em camadas, como discutido pelo CEVIU em agosto de 2026, permite que diferentes representações dos dados coexistam e se complementem. Isso inclui metadados, knowledge graphs e camadas semânticas. Essas camadas ajudam a unificar os dados de diferentes campos de modelagem, garantindo consistência e contexto para todas as aplicações, inclusive as de IA.
Fontes
- practicaldatamodeling.substack.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 01 de outubro de 2026
- Editoria
- CEVIU Dados