A equipe da Lorikeet demonstrou um feito impressionante ao otimizar consultas PostgreSQL, alcançando um aumento de desempenho de até 1.000 vezes. A melhoria foi obtida por meio da aplicação de um único typecast, que resolveu uma crucial incompatibilidade de tipos de dados entre `timestamp` e `timestamptz` sob o regime de Row Level Security (RLS). Essa correção permitiu o uso eficiente de índices, que antes estava comprometido, evidenciando o impacto significativo de detalhes técnicos na performance de bancos de dados. A abordagem sublinha a importância da gestão precisa de tipos de dados em ambientes de alta carga.
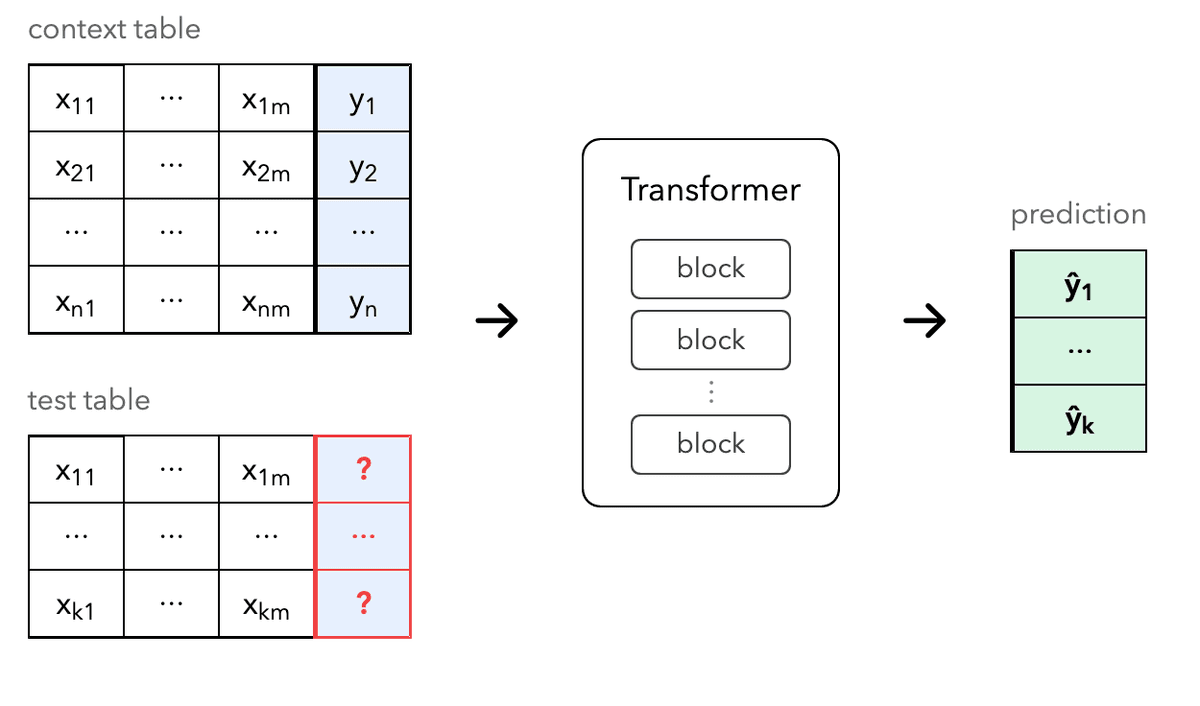
A ablação em modelos fundacionais tabulares pode levar a interpretações errôneas se a redundância for confundida com relevância causal. Análises de efeitos diretos e totais em quatro modelos distintos revelaram pouca evidência de autorreparo em camadas subsequentes, contrariando a expectativa. Este achado sugere que equipes de dados devem abordar saídas aparentemente estáveis após a ablação como um indicativo para aprofundar a investigação sobre a causalidade, e não como uma confirmação da irrelevância de determinada camada no modelo.
Pesquisadores desenvolveram um inovador framework de modelagem geoespacial capaz de gerar previsões de alta resolução. A solução integra e seleciona autonomamente dados de satélite, dados tabulares e informações provenientes de Foundation Models, estabelecendo um novo padrão para a combinação inteligente de fontes de dados heterogêneas no domínio da IA geoespacial.
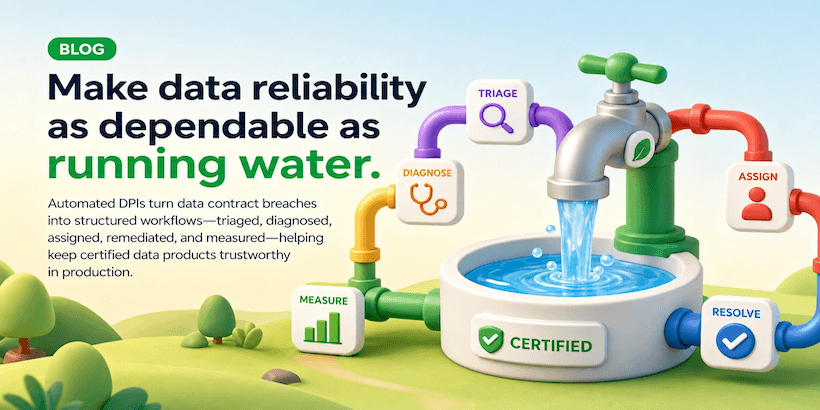
A Grab inova na gestão da qualidade de dados, tratando falhas contratuais como 'Data Production Issues' (DPIs) dentro de seu Data Mesh, utilizando um ciclo de vida de incidentes padronizado. A peça-chave é a 'Data Health API', uma interface estável que desacopla a orquestração de incidentes das especificidades da plataforma. Essa arquitetura permite categorizar falhas (upstream, de job ou de dados) para atribuir a causa raiz automaticamente. A Grab transforma, assim, a qualidade de dados de uma abordagem passiva para um modelo operacional de governança, garantindo que os incidentes só sejam encerrados após uma recuperação e verificação efetiva dos dados.
A recente ação legal movida pela X contra Nitter ressalta a vulnerabilidade e os riscos inerentes a plataformas fechadas, que detêm o poder de revogar o acesso a dados e serviços a qualquer momento, sufocando a concorrência e a inovação. Este cenário fortalece o debate sobre a descentralização e impulsiona alternativas como o AT Protocol. Essa tecnologia se destaca ao oferecer identidades digitais portáteis e permitir que aplicações repliquem, consultem e desenvolvam livremente sobre dados em tempo real, promovendo um ecossistema mais aberto e interoperável.
O Apache Spark acaba de lançar a versão 4.1.0, incorporando pipelines declarativos e um modo de streaming estruturado em tempo real, prometendo maior eficiência para processamento de dados. Entre as novidades, destaca-se o suporte nativo Arrow para User-Defined Functions (UDFs) e User-Defined Table Functions (UDTFs), otimizando a interoperabilidade. A atualização também generaliza o scripting SQL e o tipo VARIANT, além de integrar o Spark ML ao Connect para Python, visando uma experiência mais fluida para desenvolvedores. As melhorias focam na redução da latência em streaming, aprimoramento do caching e gerenciamento de memória, e na estabilidade geral para cargas de trabalho de grande escala.
O Pinterest implementou uma estratégia avançada para refinar a geração de candidatos em seu Home Feed, condicionando *embeddings* de recuperação a contextos explícitos dos usuários, como interesses, pastas e pins salvos. Essa abordagem, que inclui modelagem de sequência condicionada e *IDs* semânticos, permitiu que a plataforma represente múltiplas intenções do usuário em um único *feed* sem elevar exponencialmente os custos de *serving*. A arquitetura integra modelos unificados, roteamento de *slots*, deduplicação de requisições e *serving* via GPU, demonstrando um avanço significativo na personalização de conteúdo por meio de IA.
Grandes incidentes em infraestruturas de nuvem frequentemente derivam de riscos inerentes e desafiadores, como a saturação de recursos, falhas de rede, complexidades nos controles de segurança e alterações significativas, a exemplo de migrações. A busca por maior confiabilidade, paradoxalmente, pode introduzir camadas adicionais de complexidade, tornando a eliminação completa de interrupções uma meta inatingível. Diante desse cenário, equipes de dados e engenharia devem priorizar e investir substancialmente em estratégias robustas de resposta a incidentes para mitigar impactos.
No cenário atual da inteligência artificial, aprimorar a qualidade dos dados, integrar a expertise de especialistas e refinar iterativamente a rotulagem muitas vezes se mostram mais eficazes para impulsionar o desempenho de sistemas de Machine Learning do que a mera otimização dos modelos. Este foco na abordagem 'data-centric' sublinha a necessidade de estratégias robustas para coleta, tratamento e curadoria de dados, elementos fundamentais para o sucesso de qualquer implementação de IA.
A Twilio desenvolveu uma abordagem inovadora para monitorar a frescor de dados em seus pipelines Apache Hudi, que processam petabytes de informações. Diferente do lag tradicional do consumidor Kafka, que falha ao detectar desatualizações quando os checkpoints Hudi são armazenados no S3, a nova solução calcula o tempo de fila. Ela recupera o último checkpoint Hudi válido, identifica partições Kafka e, a partir do registro não commitado mais antigo, deriva uma métrica de "breach ratio", convertendo o "SLA drift" em um indicador acionável para operadores garantirem a qualidade e atualidade dos dados.
O Apache Kafka continua sendo uma solução robusta para o gerenciamento de logs, mas no cenário atual do streaming de dados, muitas cargas de trabalho ainda se dedicam à reconstrução de tabelas em object storage. Este artigo técnico explora a distinção entre pipelines que priorizam o log (log-first) e abordagens inovadoras de streaming que adotam o conceito de tabela desde o início (table-first), como o Fluss. A análise detalha como a semântica de atualização, compactação, snapshots e a integração de catálogos podem ser otimizadas e se tornarem mais eficientes ao serem aplicadas mais próximas do armazenamento de acesso rápido (hot storage), em vez de dependerem de jobs downstream em ambientes de lakehouse.
A criação de variáveis em modelos de IA, especialmente com técnicas como target encoding, médias móveis e shifted features, apresenta um risco significativo de vazamento de dados (data leakage) quando não é feita corretamente. O problema surge quando essas transformações são calculadas antes de uma divisão adequada dos dados em conjuntos de treino e teste, ou quando há mistura indevida de informações entre diferentes entidades. Para mitigar esse risco, um fluxo de trabalho seguro e robusto exige que os dados sejam primeiramente divididos. Em seguida, os encodings devem ser calculados out-of-fold no conjunto de treinamento, outras estatísticas devem ser ajustadas exclusivamente nos dados de treino, transformações devem ser aplicadas considerando grupos específicos e um fallback consistente deve ser implementado para categorias não observadas, garantindo a integridade e a validade preditiva do modelo.
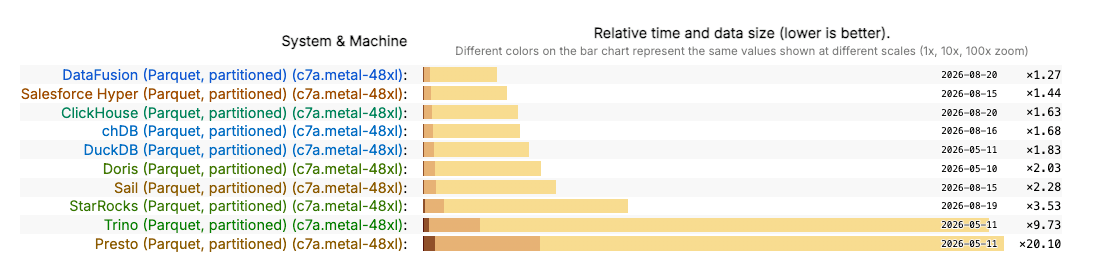
O Apache DataFusion anuncia o lançamento da versão 55.0.0, fruto de dez semanas de colaboração de 175 desenvolvedores. Esta atualização significativa introduz o comando MERGE INTO, funcionalidades avançadas de particionamento por range e pruning de grupos de linhas em tempo de execução, elementos cruciais para a otimização de operações em grandes volumes de dados. A versão também destaca ganhos notáveis de performance, incluindo o pruning TopK, avaliação mais eficiente para listas IN, redução de requisições a object-stores para CSV e otimização na leitura de colunas aninhadas em Parquet, além de menor uso de memória para operações GROUP BY em binários de tamanho fixo. Estas melhorias fortalecem o DataFusion como ferramenta essencial para engenharia de dados e analytics.
A DuckLabs confirmou sua integração à Amazon Web Services (AWS), uma movimentação estratégica para alavancar a infraestrutura robusta e os recursos da gigante da nuvem, visando escalar o DuckDB e todo o seu ecossistema, o Duck Stack. A empresa assegura que o DuckDB, DuckLake e Quack permanecerão como projetos open source sob a licença MIT, com a gestão independente da DuckDB Foundation. A expectativa é que essa parceria acelere o desenvolvimento e amplie a adoção dessas ferramentas no mercado de dados.
A complexidade crescente das tarefas atuais desafia a capacidade de agentes de IA individuais, mesmo com avanços em contexto e ferramentas. A Engenharia de Grafos surge como solução fundamental para superar essa limitação. Ela permite mapear tarefas, especializar agentes e gerenciar estados de sistema, coordenando execuções paralelas, verificações e persistência. Este paradigma transforma a inteligência de um único agente em uma robusta inteligência de sistema, crucial para a próxima geração de aplicações em IA.
O avanço da IA tem gerado um aumento exponencial na criação de pipelines e dependências, transformando engenheiros de dados em gargalos operacionais críticos. Para mitigar o risco de burnout e garantir a sustentabilidade das equipes, empresas precisam focar em infraestrutura de dados escalável, governança robusta e automação de operações. É fundamental alinhar essas estratégias às necessidades e capacidades reais da organização, promovendo um ambiente de trabalho mais eficiente e menos propenso à exaustão.
O time de secret-scanning do GitHub revelou uma abordagem robusta para avaliar Large Language Models (LLMs) antes de sua implantação em produção. Em vez de se basear apenas em benchmarks genéricos, a equipe priorizou otimizar a avaliação para a decisão de ir para produção, versionando prompts, modelos, construção de input e configurações de avaliação como código. Essa disciplina rigorosa, que simulou ambiguidades de produção, resultou em uma impressionante redução de 95% nos falsos positivos offline, ao mesmo tempo em que manteve o recall dentro dos parâmetros de segurança estabelecidos.
A performance de consultas utilizando expressões regulares no PostgreSQL pode ser drasticamente aprimorada com o uso de extensões adequadas. Em testes com uma tabela de 1,6 milhão de linhas (33 GB), a extensão pg_trgm reduziu o tempo de execução de uma varredura simples do tipo LIKE de 40 segundos para apenas 1,6 segundo. Novas opções como pg_tre introduzem a capacidade de correspondência difusa, apesar de apresentarem um tempo de construção de índice mais elevado. Já a pg_re2 se destaca pela execução mais rápida de regex, embora com um conjunto de recursos de linguagem mais limitado, oferecendo trade-offs importantes para engenheiros de dados.
Uma inovação na gestão de memória de Large Language Models (LLMs), a técnica PagedAttention, emula a paginação de memória virtual para otimizar o KV Cache. Ao substituir a alocação contígua por blocos de tamanho fixo e tabelas de blocos, a fragmentação do cache é drasticamente reduzida, elevando a utilização para cerca de 96%. Este avanço não só possibilita o suporte a "copy-on-write" para prompts compartilhados, mas também permite que uma única GPU atenda de 2 a 4 vezes mais usuários, mantendo a integridade dos resultados do mecanismo de atenção.
O mercado de software de aplicação empresarial segue em expansão, mas uma análise aprofundada dos dados revela que números agregados podem mascarar as nuances da influência da IA. Observa-se que setores com maior intensidade de workflow e potencial de automação, como Processamento de Linguagem Natural (PLN) e visão computacional, estão adotando a IA de forma mais acelerada. Em contraste, segmentos como atendimento ao cliente e Gestão de Capital Humano (HCM) demonstram um ritmo menos dinâmico. Para os compradores, a precificação e o modelo de empacotamento da IA se tornaram indicadores mais relevantes do valor gerado do que as estatísticas gerais de crescimento do mercado, exigindo uma visão mais granular para compreender o real impacto da tecnologia.