

A melhoria contínua no desenvolvimento de produtos é impulsionada por um processo iterativo e ágil. Ele envolve a coleta rigorosa de dados, a clara definição de problemas, a seleção de abordagens simplificadas, o estabelecimento de metas tangíveis e a execução acelerada. A capacidade de reiniciar este ciclo face a novas evidências não deve ser interpretada como hesitação, mas como um indicativo de que as equipes de desenvolvimento estão refinando suas estratégias com base em informações atualizadas. Este dinamismo é vital para aprimorar a entrega e a eficácia das soluções, promovendo uma adaptação constante a novos dados e a otimização contínua dos esforços.
CEVIU News
As melhores notícias de tecnologia, curadas diariamente para quem vive tech.
18838 notícias encontradas
A criação de um Language Server Protocol (LSP) robusto para Rust é uma empreitada complexa, conforme detalhado em recente análise. O desenvolvimento enfrenta obstáculos como a geração de respostas precisas a partir de código incompleto, a delimitação de workspaces ambíguos e a adaptação a um estado dinâmico do editor. A discussão técnica aprofunda-se nas distintas abordagens adotadas por projetos como rust-analyzer e Rust Glancer, abordando aspectos cruciais como a descoberta de workspaces, otimização da análise incremental de código e o isolamento de processos. Além disso, são exploradas as decisões de produto inerentes à implementação de um protocolo padronizado, destacando as implicações para a experiência do desenvolvedor (DX) e a manutenção de código de alta qualidade.
A Lovable anuncia a substituição do Vite por OJ em seus ambientes de pré-visualização, uma mudança estratégica que visa aprimorar a experiência do desenvolvedor. OJ, um servidor construído em Rust, mantém a compatibilidade com as configurações e plugins existentes do Vite, garantindo uma transição suave. Esta migração resultou em uma significativa redução do tempo médio de carregamento de pré-visualizações, caindo de 17,4 para apenas 8,0 segundos, e uma notável diminuição no consumo de memória, que foi reduzido em aproximadamente 6,5 vezes. A iniciativa reflete um esforço contínuo em otimização de performance e recursos no desenvolvimento de software.
Exploramos as engenharias criativas que desenvolvedores aplicavam no CSS para garantir compatibilidade entre navegadores, um desafio notório em épocas anteriores. A análise abrange desde o clássico 'star hack' para Internet Explorer e a correção `zoom: 1` para resolver problemas de layout, até as poderosas, porém controversas, CSS Expressions, que integravam JavaScript diretamente no CSS. Tais soluções, nascidas da experimentação e da necessidade, hoje servem como lembretes das complexidades enfrentadas na renderização web e da evolução das especificações de CSS, mostrando como a ausência de padrões unificados exigia abordagens criativas e por vezes peculiares.

O Dbt Charts emerge como uma ferramenta open-source inovadora, baseada em YAML, para a criação de dashboards. Sua proposta é permitir que tanto analistas de dados quanto agentes de IA construam visualizações governadas por código, dispensando as interfaces de ferramentas de BI tradicionais. Essa abordagem garante dashboards auditáveis, versionados junto aos modelos dbt e validados proativamente, identificando consultas problemáticas ou visualizações ineficazes antes da implementação. A ferramenta promete maior controle e transparência na geração de insights.
A ingestão de dados em formato JSON, um gargalo frequente em pipelines de dados, acaba de ganhar um impulso significativo. Uma nova implementação da biblioteca simdjson, agora, tira proveito da instrução SVE2 da arquitetura ARM para classificar caracteres estruturais de forma mais eficiente. Testes em processadores Graviton 4 e 5 demonstraram um aumento de 3-9% no throughput de indexação. Embora o ganho total no parser possa ser mais modesto, esta otimização ressalta o impacto de melhorias direcionadas via SIMD, mesmo em sistemas já altamente otimizados para processamento de dados.
A inclusão de um índice no PostgreSQL, especialmente para cláusulas ORDER BY, pode, surpreendentemente, degradar o desempenho de queries. Isso ocorre quando as linhas relevantes para o filtro estão localizadas muito adiante na estrutura indexada. Para mitigar o problema, é essencial analisar as 'Rows Removed by Filter' e realizar testes com dados representativos. Uma solução eficaz é a criação de índices compostos que abranjam tanto a condição de filtro quanto a de ordenação, garantindo que o otimizador escolha o plano de execução mais eficiente.
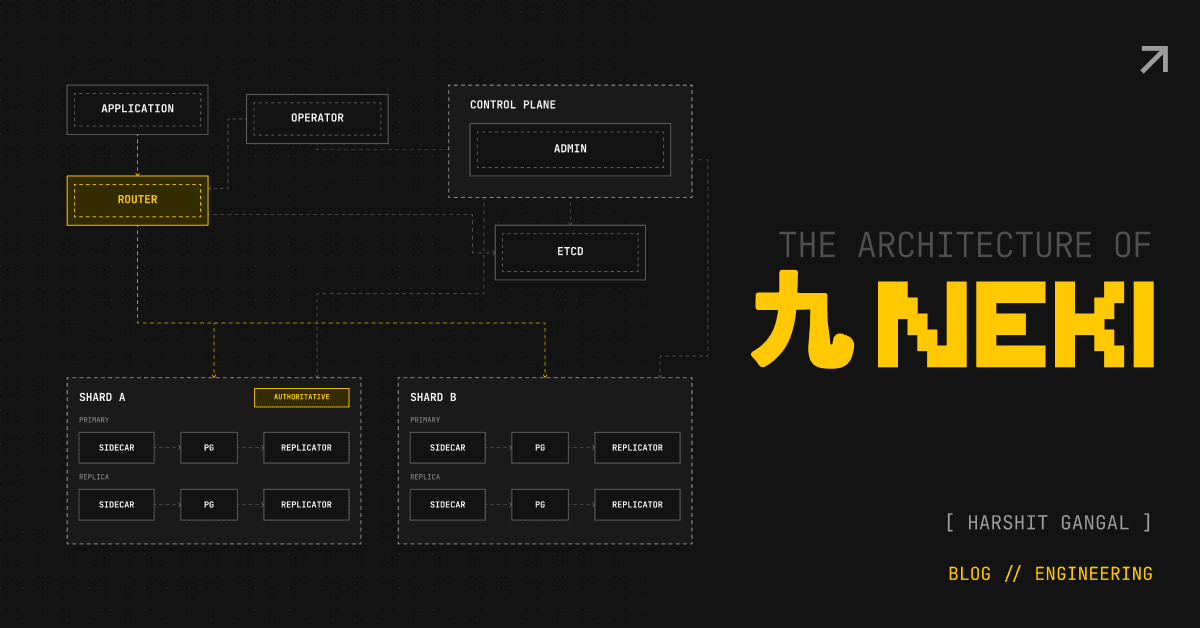
O Neki, solução da PlanetScale, implementa sharding horizontal para PostgreSQL padrão, abstraindo a complexidade de conexões distribuídas para as aplicações. Com roteadores, sidecars, replicação e failover automatizado, o Neki gerencia consultas e assegura alta disponibilidade. A plataforma também se destaca por permitir resharing de dados, movimentação de tabelas e alterações de schema online, minimizando o downtime.
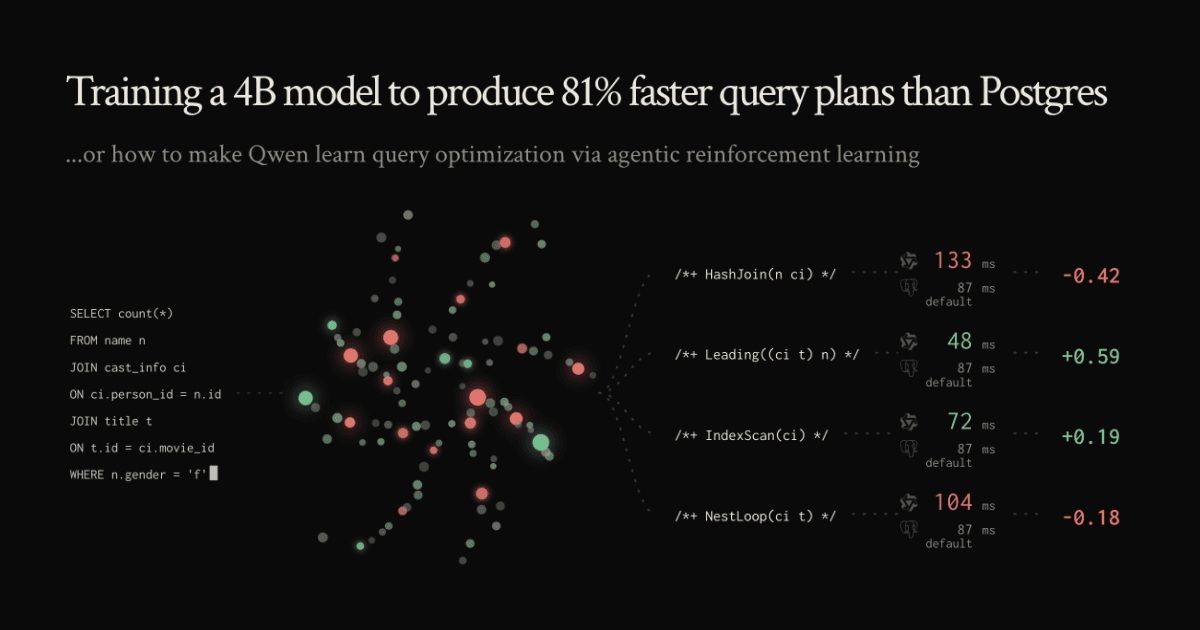
Um modelo Qwen de 4 bilhões de parâmetros, aprimorado com fine-tuning supervisionado e aprendizado por reforço, demonstrou capacidade notável para gerar planos de query PostgreSQL mais eficientes. Testado em 113 queries complexas com múltiplas junções, o modelo obteve um aumento médio de velocidade de 1,81x nos planos otimizados em comparação com as configurações padrão do PostgreSQL, além de uma redução de 44,7% na latência total da carga de trabalho. Este feito ressalta o potencial da IA, mesmo em modelos menores, para aprender e aplicar estratégias avançadas de otimização de banco de dados, utilizando feedback direto do tempo de execução para refinar suas abordagens.
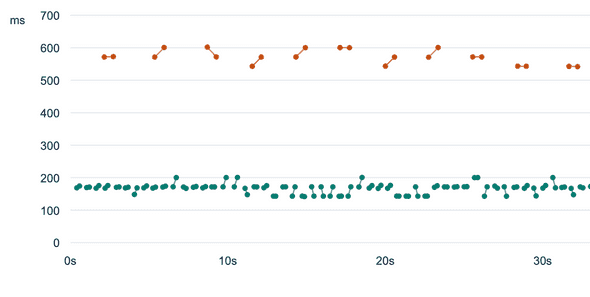
No universo do processamento de dados, os modelos 'System One' atuam como classificadores ágeis e generalistas, executando decisões simples e paralelas sem gerar extensas saídas. Para otimizar seu uso, destacam-se duas estratégias principais: a definição de metas em camadas para tarefas em tempo real, garantindo agilidade e relevância contextual; e a aplicação de comparações em formato de torneio, metodologia que aprimora a seleção da melhor opção a partir de um vasto conjunto de possibilidades, elevando a precisão analítica.
A Cloudflare demonstrou uma engenharia de dados notável ao economizar mais de 100 TB de RAM em seu proxy HTTP, Pingora. A empresa alcançou essa marca por meio de um redesenho inteligente da representação do hash-ring e da otimização da ordenação e implementação do hashing consistente. Em escala global, os pontos virtuais tradicionais para distribuição de carga consomem memória excessiva. A migração foi realizada em fases controladas, minimizando a oscilação do cache e garantindo a capacidade de rollback, um case de sucesso na aplicação de princípios matemáticos para eficiência operacional em infraestrutura de dados.
A ferramenta Jev surge como uma solução para aprimorar a extração de dados estruturados de declarações 10-K, atuando como uma camada de verificação ágil e de baixo custo. Sua funcionalidade principal é validar valores candidatos identificados por outras ferramentas, selecionando o dado correto e atribuindo um nível de confiança calibrado. Este método evita os tradicionais ciclos de geração e parseamento, que frequentemente carecem de confiabilidade, e direciona casos ambíguos para modelos mais robustos ou para intervenção humana, otimizando o processo de engenharia de dados.
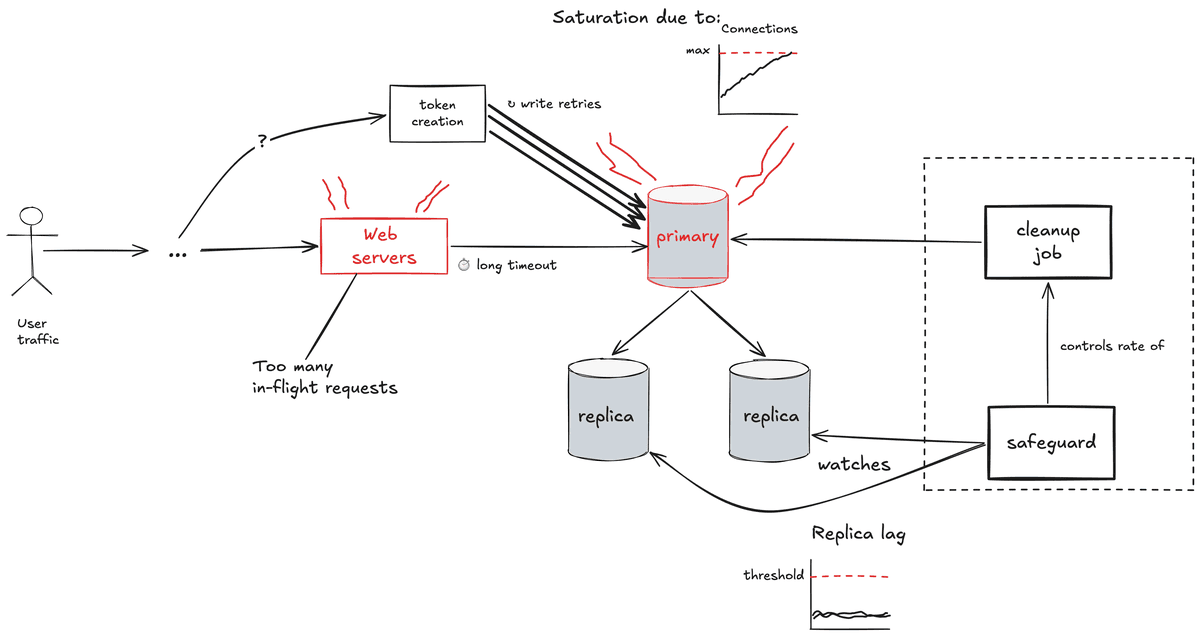
Uma recente interrupção no GitHub demonstrou as complexidades da robustez de sistemas distribuídos. O incidente começou com uma tarefa de limpeza de rotina, que, inesperadamente, saturou um banco de dados primário compartilhado. O ponto crítico foi que os sistemas de monitoramento não refletiram a gravidade da situação, exibindo o cluster como saudável ao focar apenas no atraso das réplicas, em vez da saturação real. A falha foi amplificada por tempos limite de requisição estendidos e múltiplas retentativas, que, em conjunto, transformaram uma questão de saturação de banco de dados em uma interrupção em cascata de larga escala, sublinhando a importância de uma visibilidade completa e estratégias de retentativa bem definidas em arquiteturas de dados.
Um atributo de *span* com alta cardinalidade pode elevar as séries métricas, mesmo com volumes de *traces* e amostragem estáveis. Embora a amostragem reduza o armazenamento de *traces*, ela não limita as combinações de *labels* distintas geradas pelas métricas de *span* na origem. É crucial gerenciar identificadores em *traces*, agrupá-los antes da agregação de métricas e estabelecer limites de cardinalidade e expiração. Essa prática evita que um único *deployment* transforme uma dimensão temporária em um aumento de custo permanente para a observabilidade.
Uma investigação sobre a inconsistência de latência em consultas de hypertable PostgreSQL revelou que a lentidão intermitente ocorria devido à alternância para planos genéricos por parte das instruções preparadas JDBC. Na ausência dos valores de parâmetros, o planejador do PostgreSQL falhava em excluir blocos antigos, resultando em um tempo de planejamento excessivo que se estendia por segundos. A depuração, que incluiu o registro detalhado da fase de vinculação, expôs a raiz do problema. A solução encontrada envolveu a desativação das instruções preparadas do lado do servidor e a redução do número de blocos, restabelecendo a previsibilidade da latência e otimizando a performance do banco de dados.
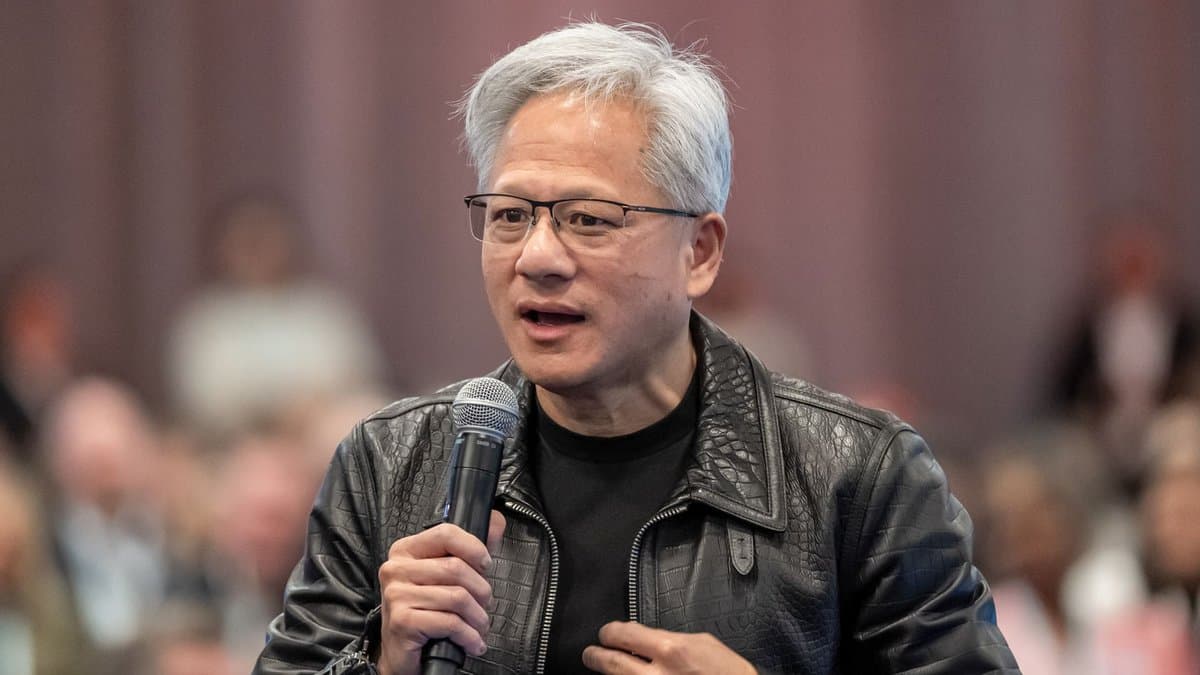

Jensen Huang, CEO da Nvidia, anunciou durante um evento na Escócia com o Rei Charles III que a empresa prevê um crescimento exponencial nas vendas de chips de IA, esperando dobrar o volume no próximo ano. Essa projeção otimista se soma à estimativa anterior de um aumento de 70% na receita para o ano fiscal de 2028, solidificando a posição da Nvidia no mercado de semicondutores de alto desempenho para IA.
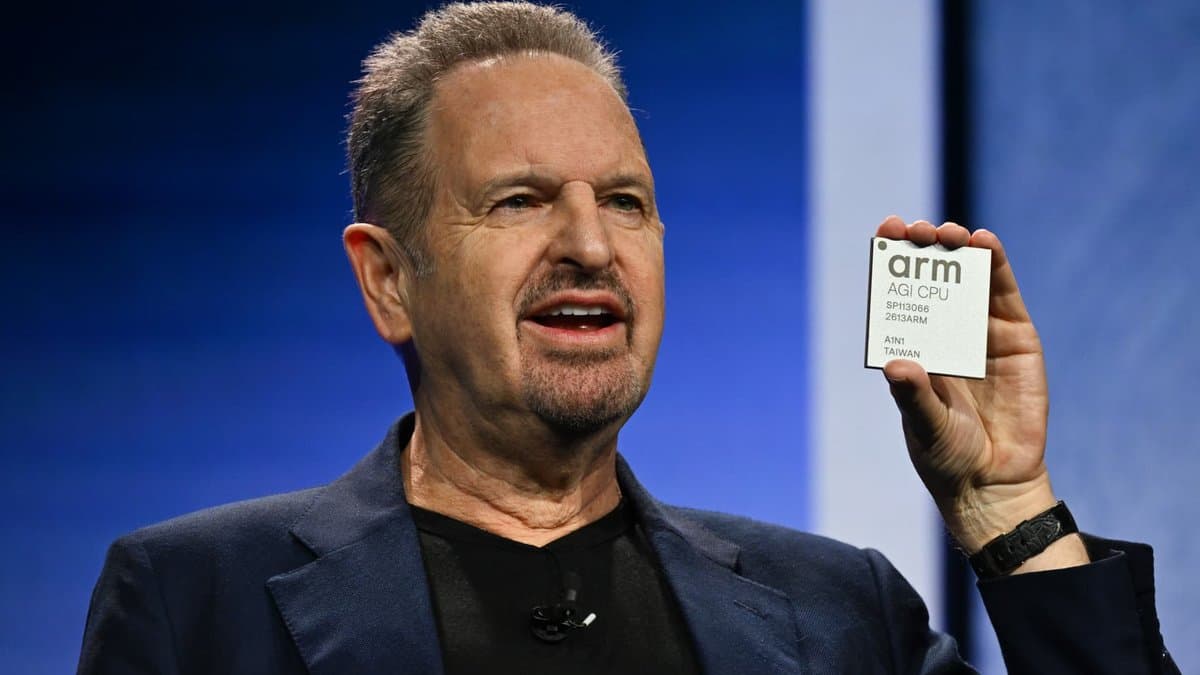
Rene Haas, CEO da Arm, abordou em entrevista à CNBC o otimismo da empresa em relação às metas de receita de IA, projetando um faturamento de US$ 2 bilhões com seu próprio chip dedicado. Haas destacou a arquitetura da Arm como um pilar fundamental na infraestrutura de IA, mesmo diante do crescimento competitivo de soluções RISC-V e silícios personalizados. A movimentação reforça a estratégia da empresa em consolidar sua posição no mercado de processadores para IA, adaptando-se às demandas por maior eficiência e capacidade de processamento.
Pesquisadores demonstram que modelos de IA Mixture-of-Experts (MoE), mesmo com grande capacidade, podem ser executados em placas de vídeo de consumidor. A chave reside no SSD-LLaMA, um projeto que otimiza o pipeline de I/O, permitindo que os extensos especialistas desses modelos, tradicionalmente limitados pela RAM e VRAM, utilizem o armazenamento SSD. O sistema emprega uma hierarquia de memória SSD-RAM-VRAM, gerenciando dinamicamente o armazenamento dos especialistas e garantindo execução híbrida CPU-GPU eficiente, sem comprometer a integridade do modelo, um avanço significativo para a inferência de IA local.
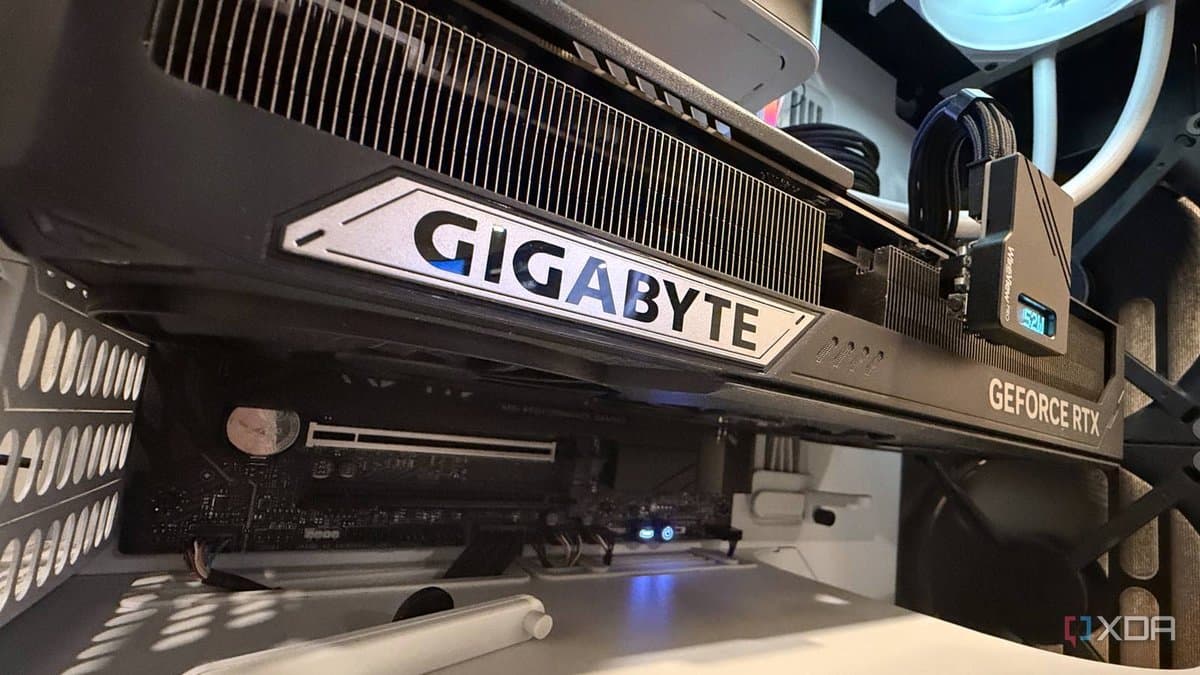
Os chips gráficos da Nvidia incorporam de 10 a 40 pequenos processadores RISC-V, dedicados a funções internas cruciais como gerenciamento de clock, memória e segurança, conforme revelado por Frans Sijstermans, vice-presidente da companhia. Esses núcleos, não programáveis pelo usuário, utilizam um bloqueio criptográfico robusto que impede a inicialização do firmware da GPU caso seja detectada qualquer alteração. Essa arquitetura visa garantir a integridade, segurança e eficiência operacional do hardware, reforçando o controle da Nvidia sobre seu ecossistema de GPUs.
A Delos Data, empresa fundada por ex-funcionários da Intel, garantiu um aporte de US$ 100 milhões em uma rodada de investimento liderada por Matrix Partners e Playground. O capital será direcionado ao desenvolvimento de chips de rede e softwares que visam acelerar a movimentação de dados entre processadores em data centers de IA. Com a crescente heterogeneidade desses ambientes, que agora combinam GPUs, XPUs, aceleradores, CPUs, memória e armazenamento de diversos fabricantes, como Nvidia, AMD e Cerebras, a eficiência na comunicação de dados torna-se um gargalo crítico, especialmente na transição do treinamento para a execução de cargas de trabalho de inferência persistentes e tolerantes a falhas.