A Cloudflare está elevando a segurança de aplicações web com uma nova ferramenta de teste dinâmico para seu Web Application Firewall (WAF), que utiliza Large Language Models (LLMs) para gerar e iterar payloads de ataque. Em um ciclo de testes abrangente, a ferramenta realizou 1.107 tentativas, cobrindo seis categorias de ataques, e identificou 49 anomalias que demandaram análise humana. Esse processo levou à implementação de novas detecções para Server-Side Request Forgery (SSRF) e ao aprimoramento de regras existentes de metadados de nuvem, fortalecendo a defesa contra vulnerabilidades emergentes e garantindo maior resiliência para as aplicações dos usuários.
A AWS anunciou uma novidade para o Amazon S3 Vectors: a pré-filtragem de metadados, que aprimora significativamente o recall em buscas filtradas. Este recurso processa os filtros de metadados antes da execução da busca de similaridade, suportando até 100 restrições por consulta. Em cenários de filtros seletivos, a pré-filtragem pode resultar em até cinco vezes mais vetores correspondentes. A funcionalidade já está disponível, não acarreta custos adicionais e opera sobre índices existentes, eliminando a necessidade de reingestão de dados.
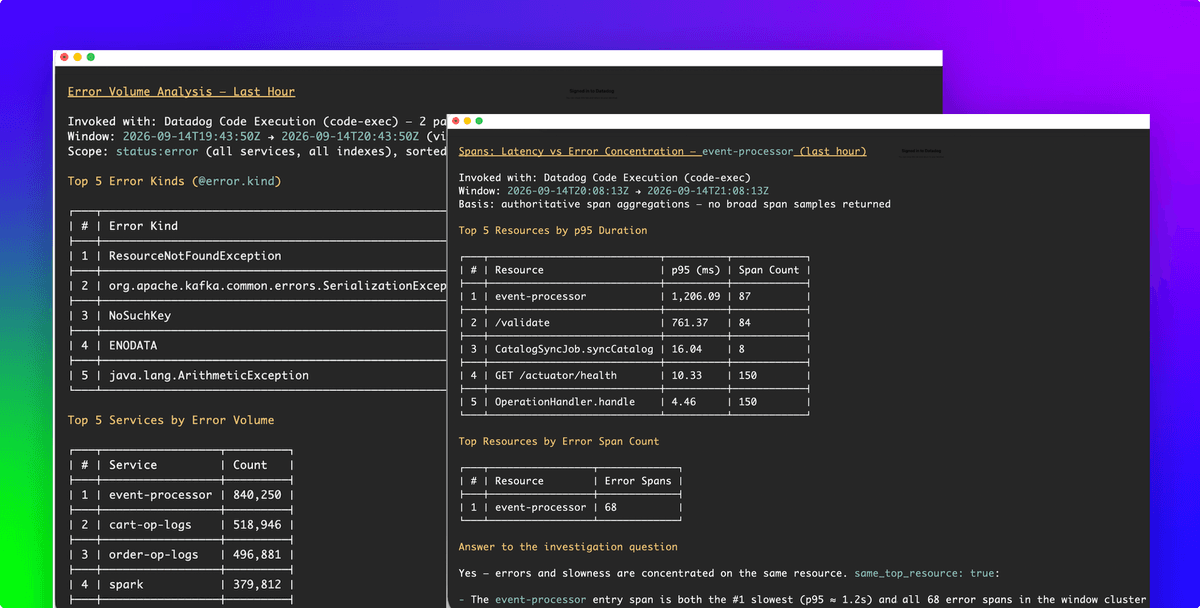
O Datadog introduz uma nova funcionalidade de Execução de Código que permite que agentes de IA rodem JavaScript em sandbox diretamente no servidor MCP. Essa capacidade aprimora a forma como os dados são processados, possibilitando consultas, junções e filtragens de múltiplas APIs, entregando apenas as informações mais relevantes aos modelos de IA. Testes realizados em quatro modelos distintos resultaram em um aumento de precisão de até 21,8 pontos percentuais, além de uma significativa redução de 73% nos tokens de entrada e 40% nas chamadas de tooling, otimizando recursos e performance.
O uso de IA na geração de código introduz um desafio notável: a carga cognitiva imposta aos desenvolvedores durante a revisão. A presença de abstrações ou nomenclaturas não familiares no código gerado pela IA exige um esforço adicional de tradução mental, o que pode retardar o processo de validação e manutenção. Este ponto é crucial para equipes de DevOps que buscam otimizar a velocidade e a qualidade da entrega, destacando a necessidade de ferramentas de IA que gerem código não apenas funcional, mas também legível e compreensível para humanos.
O investimento em plataformas internas se torna crucial diante de desafios emergentes em IA e nuvem. A Gartner projeta que 40% das empresas reduzirão o uso de agentes autônomos de IA até 2027, impulsionadas por falhas de governança após incidentes de produção. Esse cenário ressalta a necessidade de plataformas robustas que garantam controle e observabilidade. Dados da pesquisa DORA 2025 do Google revelam que 90% das organizações já operam com uma plataforma interna, sendo 76% com equipes dedicadas. Paralelamente, uma pesquisa da Broadcom aponta que 97% dos líderes de TI reconhecem o desperdício em gastos com nuvem pública, elevando o custo à principal preocupação, superando a segurança. A engenharia de plataformas emerge como ferramenta vital para mitigar esses riscos e otimizar recursos.
Erros persistentes na configuração do RBAC (Role-Based Access Control) no Kubernetes, como a atribuição de permissões de cluster-admin a contas de serviço, o uso indiscriminado de wildcards em políticas, acesso excessivo a secrets sensíveis e a presença de bindings obsoletos sem expiração, representam as falhas mais frequentes e críticas na segurança de clusters. Essas vulnerabilidades superam, em incidência, as explorações de novas vulnerabilidades, sendo o vetor principal para comprometimentos de sistemas.
A Harness anunciou a integração de seu gerenciador de postura de segurança e firewall de IA com o Amazon Bedrock AgentCore Gateway. Essa funcionalidade promete otimizar a descoberta e a segurança em tempo de execução para as cargas de trabalho de IA, automatizando o inventário de agentes, ferramentas e recursos em operação dentro dos ambientes AWS. A novidade visa aprimorar a visibilidade e controle sobre os ativos de IA, garantindo conformidade e proteção contra ameaças.
Engenheiros da Modal reestruturaram a arquitetura de sua plataforma de sandbox, afastando-se do modelo centralizado similar ao Kubernetes. A inovação focou na implementação de um estado de worker distribuído e escalonamento massivamente paralelo. Essa abordagem permitiu à empresa criar impressionante um milhão de sandboxes concorrentes em menos de 60 segundos, com tempos de inicialização abaixo de meio segundo. A mudança acende um debate crucial sobre a separação dos planos de coordenação e execução na infraestrutura moderna.
Ferramentas tradicionais de mocking de dependências não são adequadas para arquiteturas cloud native, nas quais os serviços são implantados de forma autônoma, e desvios de comportamento podem passar despercebidos. Uma solução eficaz deve compreender eventos de deploy, capturar o comportamento real a partir do tráfego em vez de depender de especificações, gerenciar campos não determinísticos de forma automática e fornecer visibilidade das diferenças entre os serviços. A técnica eBPF é destacada como uma abordagem promissora para capturar tráfego e suprir essas necessidades em ambientes distribuídos.
A TypeSafe IA anuncia o acesso antecipado ao Jev, um modelo inovador que emprega primitivos de decisão para otimizar o gerenciamento de infraestrutura. Em resposta, a Pulumi lança o GeoDeploy, uma ferramenta open-source que, utilizando o Jev, automatiza a comparação de custos e o provisionamento de clusters Kubernetes nas principais nuvens, AWS, Azure e Google Cloud, marcando um avanço significativo na automação e otimização de infraestrutura.
A Bolna realizou uma migração estratégica de seu sistema de análise de dados do Google BigQuery para o ClickHouse. A mudança envolveu a realocação da onerosa deduplicação de CDC para views materializadas e a correção de dados ausentes de JSONB TOASTed, utilizando o recurso REPLICA IDENTITY FULL. Essa otimização resultou em uma redução de aproximadamente 6 vezes nos custos de análise e uma significativa melhoria na disponibilidade dos dados, caindo de 5-15 minutos para apenas 1-2 minutos após a finalização das chamadas.
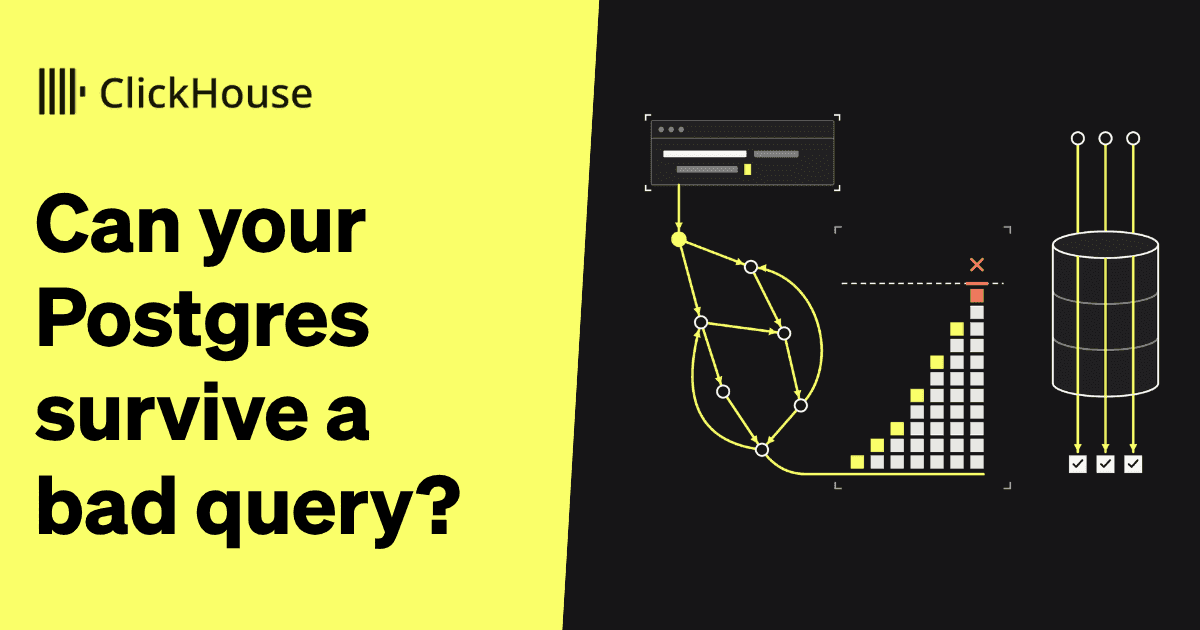
Engenheiros de plataforma e DevOps precisam estar cientes de como o Postgres gerencia a memória. Parâmetros como `work_mem` são aplicados por nó de execução e por *worker*, e não por *query* globalmente, o que pode levar a um consumo de memória muito superior ao configurado para uma única operação. Queries recursivas representam um risco ainda maior, pois certas tabelas hash do executor não conseguem descarregar dados para o disco. Esse comportamento eleva a criticidade de otimização de consultas, podendo esgotar os recursos de memória do sistema, mesmo com configurações conservadoras, impactando diretamente a confiabilidade do serviço.
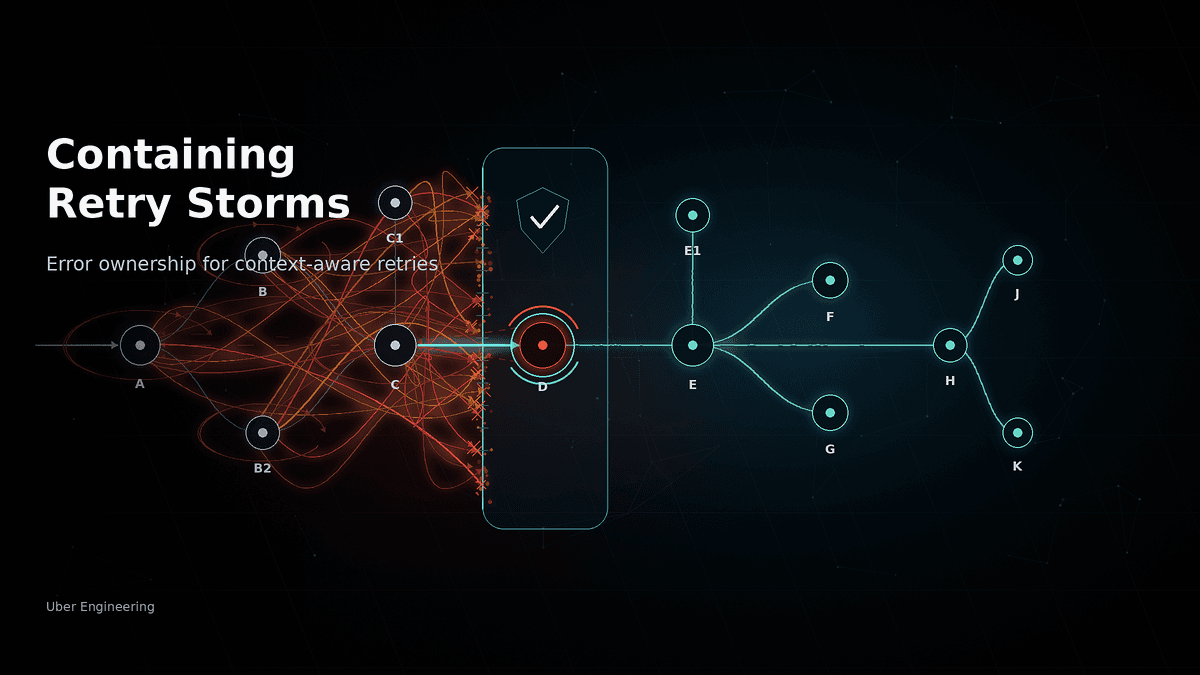
A Uber aprimorou significativamente sua infraestrutura de service mesh ao implementar um mecanismo de 'error ownership'. Essa abordagem permite que serviços de nível superior identifiquem a origem real de falhas, distinguindo entre erros próprios e aqueles propagados por dependências. Em um incidente recente, a inovação evitou cerca de 9,5 milhões de retries desnecessários e diminuiu o impacto de 'tempestades de retries' em APIs críticas, reduzindo o raio de propagação de até 25 para apenas 3 'saltos' (hops).
A HashiCorp anunciou a disponibilidade geral da versão 8.0 do Terraform Google Cloud Provider, trazendo mudanças significativas para a gestão de infraestrutura como código no Google Cloud. Esta atualização modifica o esquema padrão de balanceamento de carga, descontinua recursos ligados a serviços obsoletos, como Notebooks e IAP OAuth Admin, e converte atributos de lista para conjuntos. Essas alterações visam aprimorar a previsibilidade dos planos de execução do Terraform e otimizar a conformidade com as práticas mais recentes do Google Cloud, exigindo atenção dos times de DevOps e engenharia de plataformas.
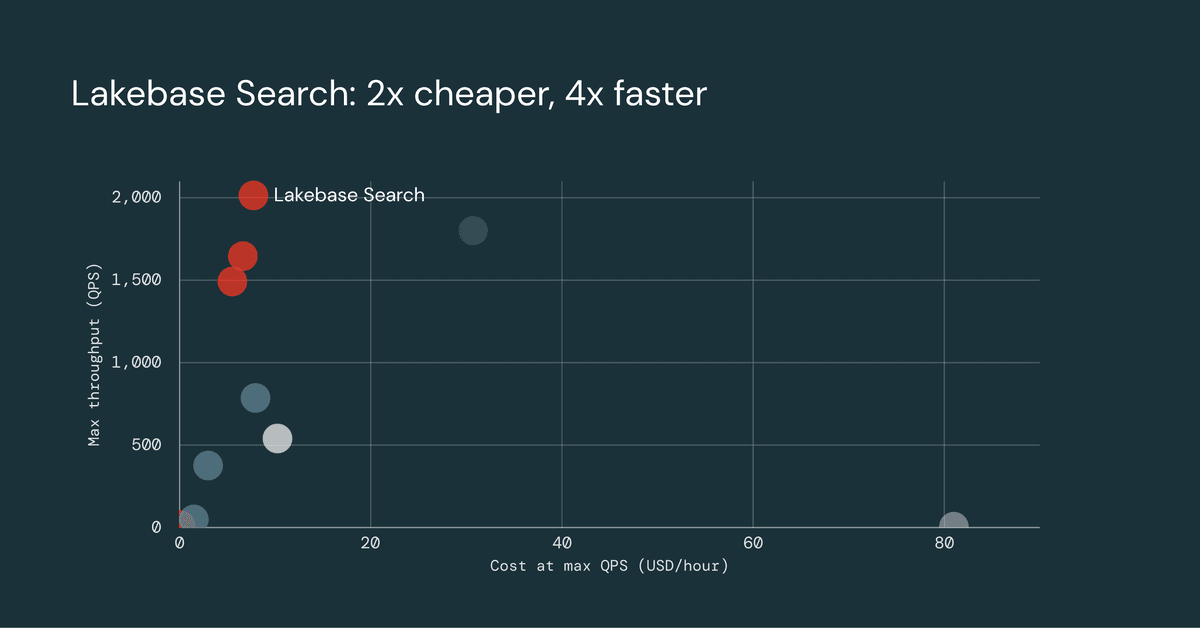
O Lakebase para PostgreSQL agora disponibiliza funcionalidades avançadas de pesquisa, com disponibilidade geral na AWS e Azure. A novidade chega através das extensões lakebase_vector e lakebase_text, que introduzem capacidades de pesquisa full-text e vetorial de última geração diretamente no banco de dados, alinhando o Postgres às demandas modernas de IA e análise de dados massivos.
A Cloudflare acaba de introduzir o 'cf', uma nova interface de linha de comando que revoluciona o acesso à sua API, abrangendo mais de 3.000 operações. Enquanto o 'Wrangler' suportava aproximadamente 280 comandos e teve um uso por agentes de 48% na última semana, o 'cf' padroniza comandos através de um pipeline unificado de geração de API, com saída JSON como padrão. A empresa assegura que o 'Wrangler' terá suporte de manutenção por 18 meses após o término da fase beta, facilitando a transição para a nova ferramenta.
A Cloudflare remediou uma vulnerabilidade crítica em seus serviços de Containers, identificada pelo pesquisador Oren Yomtov. A falha permitia a recuperação de dados residuais de blocos de armazenamento em hosts compartilhados, potencialmente expondo informações de outros clientes. O problema decorreu de uma configuração que falhava em zerar blocos recém-alocados, podendo vazar estruturas de diretórios, páginas de banco de dados e dados de aplicações. A correção foi aplicada em toda a infraestrutura e, segundo a empresa, não há evidências de exploração maliciosa.
A AWS acaba de aprimorar os custom event buses do Amazon EventBridge, facilitando o desenvolvimento de aplicações event-driven em larga escala. Agora, as organizações podem compartilhar esses recursos de forma centralizada entre todas as suas contas, promovendo uma arquitetura mais coesa e eficiente, essencial para equipes de DevOps que buscam otimizar a integração e a entrega contínua em ambientes corporativos complexos.
A AWS acaba de lançar o CloudWatch Omni, uma inovadora plataforma de observabilidade impulsionada por IA, projetada para consolidar telemetria de diversas fontes. Integrando o OpenTelemetry com a capacidade de escala do CloudWatch, a solução oferece uma visão unificada em contas, regiões e até mesmo outras nuvens, organizada por equipes. O CloudWatch Omni se destaca por permitir consultas em linguagem natural, mapear automaticamente dependências e fornecer um fluxo de trabalho especializado para monitorar agentes, suportando frameworks como LangGraph, CrewAI e Vercel AI SDK.
Ferramentas tradicionais de observabilidade podem confirmar a velocidade e disponibilidade de agentes de IA, além da ausência de erros operacionais. No entanto, elas falham em determinar a precisão e correção da saída gerada. Isso evidencia a necessidade crítica de métricas mais avançadas para avaliar a qualidade intrínseca do trabalho da IA, indo além da mera funcionalidade e confiabilidade da infraestrutura.