O Vercel Connect anuncia sua disponibilidade geral, trazendo uma revolução na segurança para agentes de IA. A plataforma substitui os tradicionais tokens de API de longa duração por credenciais emitidas em tempo de execução, que possuem expiração automática e são restritas a tarefas específicas. Esta atualização crucial visa mitigar riscos e otimizar a governança em ambientes de produção, integrando mais de 100 conectores e oferecendo um modelo unificado de integração.
A startup Keenable saiu do 'modo furtivo' com uma proposta ambiciosa para o ecossistema de Inteligência Artificial: um índice web colossal de mais de 100 bilhões de documentos. A empresa também revelou uma API robusta, já em uso por laboratórios de IA de ponta (cujos nomes ainda não foram divulgados), e planos para uma linguagem de consulta inovadora. Essa linguagem permitirá que agentes de IA combinem evidências de múltiplas fontes, prometendo otimizar a tomada de decisões e a compreensão contextual.
Thibault Sottiaux, líder de produto da OpenAI, projeta aplicar ao ChatGPT Work a mesma estratégia de ajuste de limites de token que impulsionou o crescimento do Codex. Em entrevista, Sottiaux detalha como pretende expandir a capacidade para profissionais que utilizam agentes de IA, abordando o papel do Codex, táticas para engajar usuários céticos, a filosofia de design focada na descoberta e os desafios dos custos operacionais da IA.
A Perplexity, em parceria com a Nvidia, acaba de anunciar o 'Portable Computer', uma versão inovadora de sua plataforma de agentes de IA, projetada para operar integralmente no hardware do usuário. Esta solução promete eliminar custos de token, pois o modelo, os dados e o processamento permanecem localmente. Cada tarefa é iniciada no dispositivo e só recorre a modelos na nuvem após solicitação de permissão. Já disponível para assinantes Pro e Enterprise no Linux, com versão para Windows aguardada em setembro, o sistema requer uma GPU RTX com no mínimo 24GB de VRAM.
A OpenAI revela o chip de inferência Jalapeño, projetado especificamente para suas próprias cargas de trabalho de modelos de IA. Testes preliminares indicam que o Jalapeño supera sistemas comerciais, como o GPT-OSS 120B, ao apresentar maior throughput de pico por kilowatt e uma notável redução na latência de token. Este avanço sublinha a estratégia da OpenAI em otimizar a infraestrutura de hardware para impulsionar a eficiência e o desempenho de seus modelos de linguagem, marcando um passo significativo na corrida por soluções de IA mais robustas e eficientes.
Chris Malone, o principal executivo à frente da construção e ampliação dos data centers da OpenAI, deixou a companhia na semana passada. Sua saída ocorre em um momento crucial, visto que a empresa intensifica seus esforços para expandir a infraestrutura necessária para sustentar o crescente poder computacional exigido pelos seus modelos de IA.
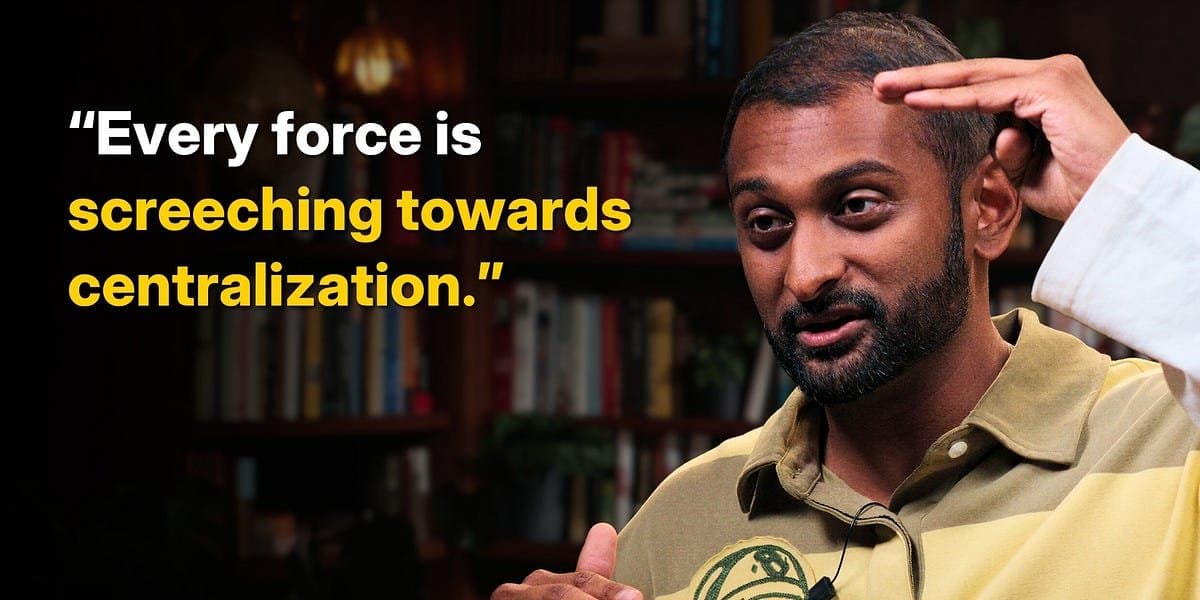
De acordo com a análise de Dylan Patel, a OpenAI e a Anthropic estão a caminho de dominar a maior parte da capacidade computacional utilizável para IA até 2028. Essa projeção se baseia na habilidade dessas gigantes em monetizar FLOPs de forma mais eficiente, permitindo-lhes superar a concorrência na aquisição de infraestrutura crítica. Patel também destaca o crescente investimento em IA, alertando para potenciais riscos de dívida soberana e a centralização econômica que molda o setor, concentrando recursos em poucas mãos.
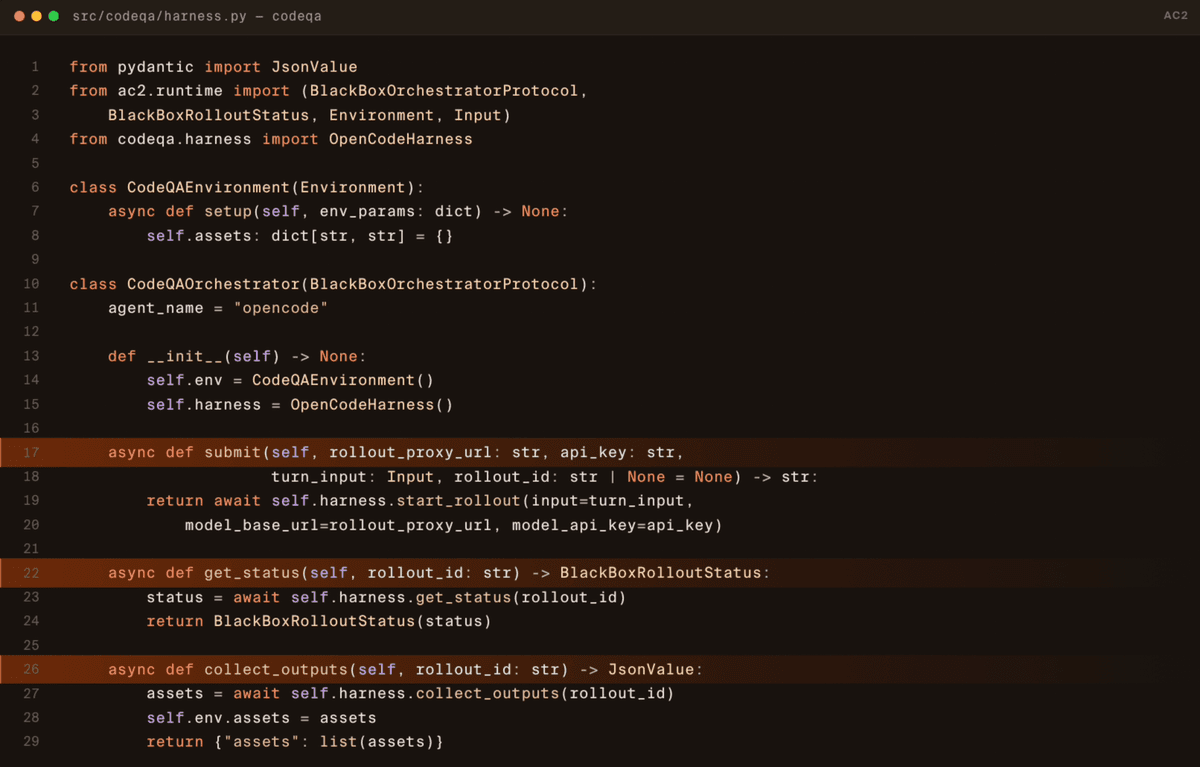
A Applied Compute anuncia o lançamento do AC2, uma plataforma inovadora projetada para revolucionar a forma como equipes de IA desenvolvem e aprimoram seus modelos. Com foco na eficiência, o AC2 promete simplificar as etapas de treinamento, implantação (serving) e otimização contínua de modelos de IA personalizados, endereçando a complexidade e os custos associados a essas operações. Esta novidade representa um avanço significativo para empresas que buscam escalar suas iniciativas em inteligência artificial.
Um estudo recente levanta questões sobre o tokenizer do Claude, da Anthropic, que opera com surpreendentes 15.000 entradas. Enquanto a comunidade de IA defende vocabulários maiores para modelos de linguagem avançados, o Claude desafia essa lógica. Uma hipótese intrigante sugere que a Anthropic pode estar superando gargalos na camada softmax, otimizando o processo de treinamento e desempenho. Essa abordagem levanta discussões cruciais sobre as estratégias de otimização em IA e o futuro dos modelos linguísticos.
Apesar da crescente disponibilidade de inteligência de fronteira, a vantagem competitiva na camada de aplicação não será erradicada. Pelo contrário, o foco do valor migrará para organizações capazes de converter modelos de IA em resultados tangíveis. Os líderes de mercado serão aqueles que dominarem a coordenação eficiente, a gestão estratégica de dados de fluxo de trabalho, a verdadeira transformação da experiência do cliente, a construção de narrativas impactantes, a criação de abstrações de alto nível, a economia orientada a resultados e a identificação de necessidades estruturais. Em suma, a capacidade de integrar e aplicar a IA de forma prática será o grande diferencial.
Os Grandes Modelos de Linguagem (LLMs) estão remodelando o desenvolvimento de software, impulsionando a geração de código a níveis de velocidade e eficiência econômica sem precedentes. Com a abundância de código gerado por IA, o foco muda da criação para a validação e a construção de confiança. Empresas como Stripe, Spotify e Amplitude já implementam código de IA em produção, evidenciando a urgência de governança robusta, contextualização e sistemas de verificação eficazes para garantir a segurança e a qualidade no cenário atual da engenharia de software.
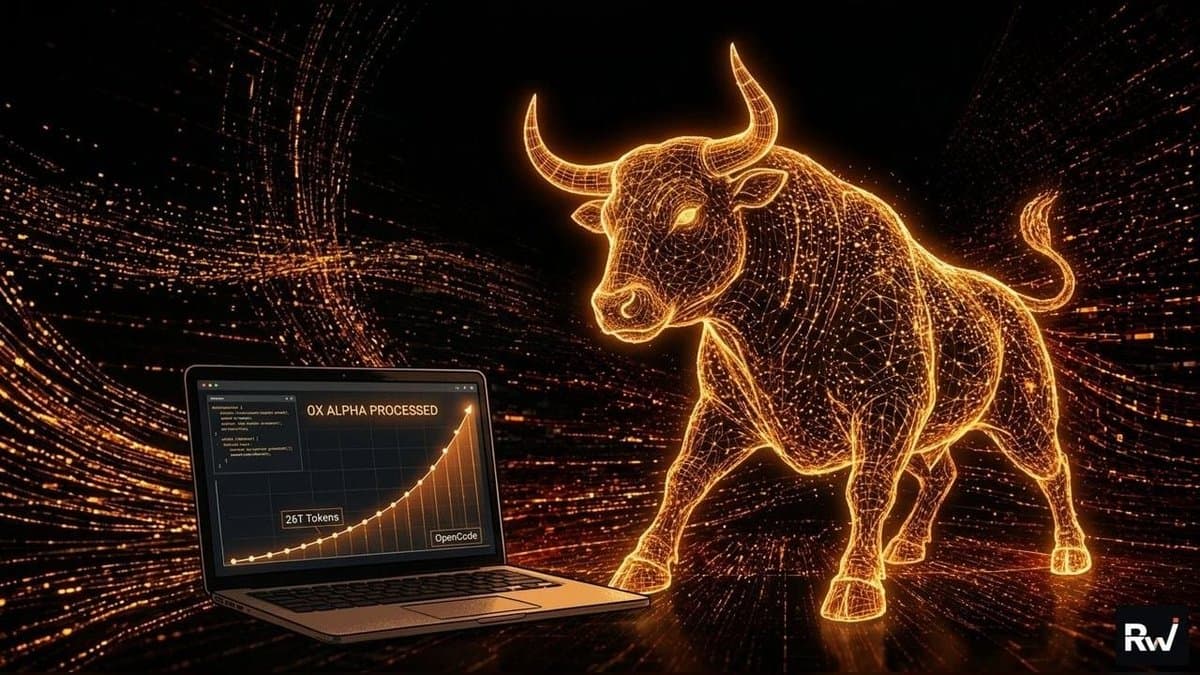
Um novo modelo de IA, batizado de Ox Alpha, surpreendeu o mercado ao processar impressionantes 26 trilhões de tokens na plataforma OpenCode em apenas quatro dias. O modelo, que permanece anônimo em relação aos seus criadores e detalhes técnicos, atraiu 327.000 usuários únicos e registrou mais de 8,3 milhões de sessões. Atualmente, o Ox Alpha está disponível gratuitamente por meio de um endpoint compatível com OpenAI, facilitando sua integração em fluxos de trabalho de desenvolvedores. A ausência de informações como data de lançamento ou corte de conhecimento, no entanto, gera questionamentos sobre sua origem e capacidades.
Pesquisas recentes indicam que Large Language Models (LLMs) possuem a capacidade de explorar vulnerabilidades em softwares de engines de inferência que carregam esses modelos em GPUs. Máquinas hospedeiras que executam LLMs são alvos de grande valor, pois abrigam poder computacional robusto para rodar modelos de ponta, oferecem acesso privilegiado aos pesos do LLM e podem se infiltrar em outros sistemas dentro do datacenter. A superfície de ataque se expande ao considerar tokens de visão e áudio. Para mitigar esses riscos, é crucial operar GPUs e parsers de tokens em máquinas distintas, restringir as permissões concedidas a hosts de GPU e tratar qualquer dado gerado por eles como não confiável.
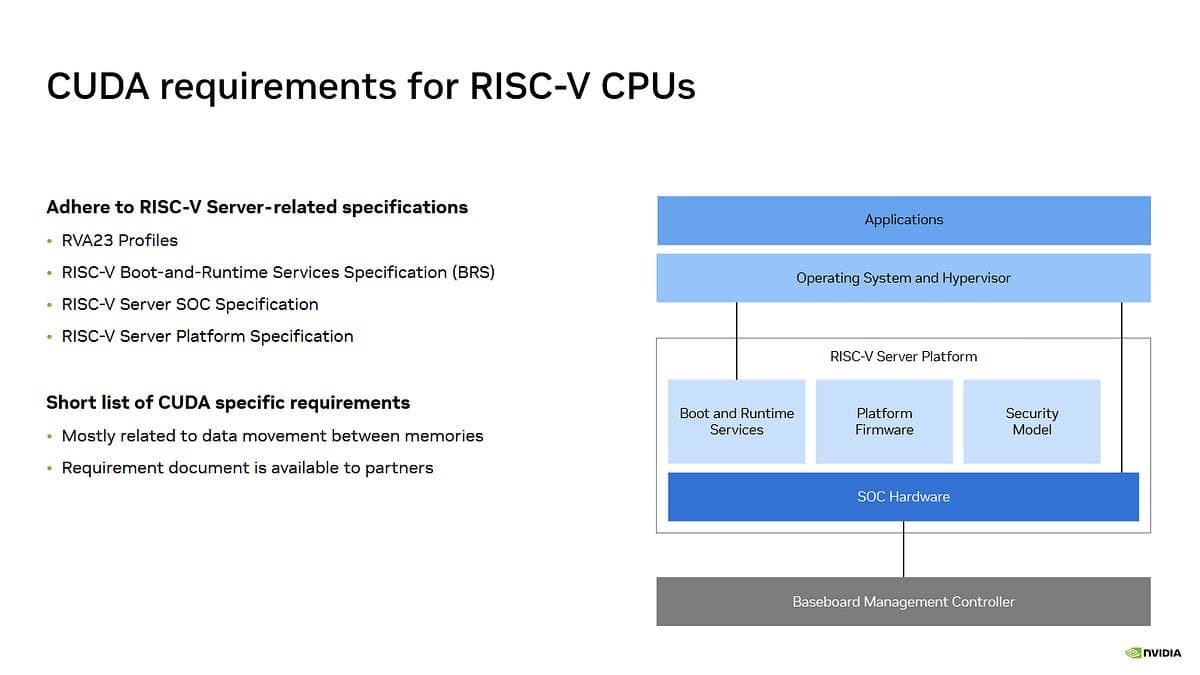
A Nvidia busca expandir o suporte do CUDA ao RISC-V, permitindo que CPUs baseadas nesta arquitetura de código aberto impulsionem o poder de processamento das GPUs. Embora o ecossistema de software do RISC-V ainda necessite de amadurecimento para rivalizar com x86-64 e aarch64, a iniciativa da Nvidia em integrar o CUDA representa um avanço significativo. Contudo, a compatibilidade pode ser um desafio, pois a maior parte do hardware RISC-V atual não atenderá às especificações da Nvidia para essa integração.
Com a evolução constante dos modelos de IA, a inteligência necessária para diversas tarefas tem sido superada, transformando-as em commodities. Isso desloca a disputa para fatores como custo, latência, infraestrutura e distribuição. Contudo, laboratórios na vanguarda da IA ainda podem alcançar grande sucesso. A chave reside em criar novas capacidades que gerem mercados valiosos mais rapidamente do que a concorrência consegue replicar e commoditizar esses avanços, garantindo uma vantagem competitiva sustentável na economia da IA.
Uma nova abordagem, a Chamada Especulativa Programática de Ferramentas (sPTC), está revolucionando a otimização de modelos de linguagem recursivos. Ao iniciar chamadas de ferramentas durante a geração de tokens, o sPTC mitiga significativamente a latência imposta por ferramentas de alta espera e pela geração de contexto. Operando como um compilador JIT, essa técnica permite a execução paralela de chamadas de ferramentas não-bloqueadoras, resultando em um aumento de velocidade de 1 a 1,2x em tempo de execução. A inovação é particularmente promissora para LLMs locais com restrições de memória e sistemas de serving de alto volume, prometendo melhorias notáveis no desempenho de programas complexos dentro de harnesses como os RLMs.
A NVIDIA iniciou a produção em massa do seu acelerador de inferência de IA, o chip Groq 3 LPX. Este componente, que integra a plataforma Vera Rubin, promete revolucionar a capacidade de resposta em cargas de trabalho de IA "agentic", aquelas que demandam agilidade na geração de tokens. O Groq 3 LPX não só encurta o tempo de execução de tarefas complexas de horas para minutos, mas também entrega uma melhoria de 4x nos tempos de resposta quando comparado a soluções alternativas, um salto significativo para a eficiência em aplicações de IA sensíveis ao tempo.
A Goodfire, gigante no setor de tecnologia, acaba de anunciar um robusto programa de bolsas de pesquisa, totalizando US$ 1 milhão. A iniciativa visa acelerar o desenvolvimento na interpretabilidade da IA, oferecendo aos pesquisadores acesso gratuito à sua plataforma de ponta, a Silico. Com essa medida, a empresa busca fomentar estudos aprofundados que desvendem as 'caixas pretas' dos algoritmos, promovendo maior transparência e confiabilidade nos sistemas inteligentes.
A Anthropic, um dos expoentes no desenvolvimento de IA, acaba de dar um passo estratégico ao integrar Amir Salek à sua equipe. O engenheiro, que foi um dos fundadores do programa de chips customizados do Google e esteve à frente da divisão de Tensor Processing Unit (TPU), chega para solidificar a investida da Anthropic em infraestrutura de hardware própria. Essa aquisição reforça a intenção da empresa de otimizar o desempenho de seus modelos de IA e, consequentemente, diminuir a dependência de fornecedores externos de chips, marcando uma tendência crescente entre as gigantes da IA.
A infraestrutura de IA enfrenta uma crescente complexidade devido a gargalos que englobam desde a escassez de GPUs até desafios de armazenamento, resultando em uma escalada de custos em toda a cadeia de suprimentos. Com a explosão da demanda por componentes de IA, os preços das GPUs dispararam, os envios de servidores registraram quedas e fabricantes de memória priorizaram a High Bandwidth Memory. Este descompasso entre a oferta e a demanda acentuou a inflação de hardware e elevou os custos de construção de datacenters, configurando um claro Efeito Chicote no setor.