Embora os dashboards simplifiquem a mensuração do marketing, eles podem, paradoxalmente, ofuscar as ações que verdadeiramente impulsionam o crescimento. Equipes frequentemente priorizam otimizar métricas como tráfego ou produção, por serem facilmente quantificáveis, mas acabam negligenciando o conhecimento aprofundado do cliente e a construção de relacionamentos duradouros. Esses elementos, mais complexos de mensurar, são cruciais para um impacto de longo prazo. É fundamental que profissionais de marketing vejam as métricas como mapas incompletos, questionando ativamente o que os dashboards não revelam. Crucialmente, os dados devem ser constantemente contrastados com percepções diretas de clientes e equipes para se obter uma visão abrangente e, de fato, eficaz da estratégia.
Em um cenário onde a IA comprimiu as margens brutas do SaaS de 80-90% para 40% ou menos, a empresa Lovable adota uma abordagem inovadora: enxergar o uso gratuito de seus produtos de IA como um investimento em aquisição, e não um custo. Com um período de retorno de 3 meses, a estratégia avalia conversão, retenção e expansão, contrastando com a tendência de muitas empresas de limitar a IA por paywalls. A Lovable registra uma taxa de conversão de grátis para pago de 5-10%, e parcerias estratégicas podem elevar esse índice para 40-60%, validando o modelo. A alternativa, gastar em canais de aquisição pagos, seria consideravelmente mais cara do que o investimento no 'gratuito', reafirmando o potencial de crescimento orientado pela IA.
O Google tem expandido a capacidade de suas ferramentas de IA, como os AI Overviews e o AI Mode, para gerar calculadoras e conversores diretamente nas buscas. Esta inovação, já disponível globalmente em inglês, representa um desafio significativo para pequenos sites de utilidade. Aqueles que oferecem serviços baseados em fórmulas simples – de entrada e saída – tornam-se alvos fáceis para a recriação instantânea por modelos de IA, colocando em risco a existência desses serviços independentes.
A Cloud Native Computing Foundation (CNCF) anunciou a graduação do Karmada, projeto open source essencial para a gestão e orquestração de aplicações em múltiplos clusters e ambientes de nuvem Kubernetes. Com mais de 1.214 contribuidores e adoção por gigantes como Bloomberg, Wellhub e Alibaba Cloud, o Karmada demonstrou maturidade. A versão v1.19 otimiza o escalonamento para cargas de trabalho de treinamento de IA distribuídas, reforçando sua relevância. Para a graduação, o projeto passou por uma auditoria de segurança independente e estabeleceu um comitê de direção formal, consolidando sua governança e estabilidade no ecossistema de infraestrutura como código.
O Kubernetes está promovendo o KYAML, um dialeto YAML mais rigoroso, visando reduzir ambiguidades sintáticas e de tipo nos manifests. Mantendo-se compatível com YAML padrão e ferramentas existentes, o KYAML padroniza configurações de forma explícita, aprimorando consistência, validação e diferenciação. Sua relevância cresce à medida que Helm, GitOps, ferramentas de infraestrutura e agentes de IA geram cada vez mais configurações para o ecossistema Kubernetes, garantindo maior confiabilidade e previsibilidade nas operações.
O Yahoo tem empregado VMs flexíveis no serviço gerenciado para Apache Spark do Google Cloud, assegurando o provisionamento robusto de seus pipelines de análise. A estratégia permite categorizar formatos de VM desejados e buscar alternativas em zonas regionais caso a capacidade preferencial não esteja disponível. Essa implementação resultou em uma expressiva diminuição de 85% nas falhas de provisionamento de cluster, atribuídas à escassez de recursos regionais, fortalecendo a resiliência da infraestrutura e minimizando intervenções manuais.
O AWS Config acaba de integrar suporte a 60 novos tipos de recursos AWS, abrangendo diversos serviços da nuvem. Esta expansão fortalece significativamente as capacidades de descoberta, avaliação de conformidade, auditoria e remediação, permitindo que equipes de DevOps e engenharia de plataformas mantenham um controle mais granular e automatizado sobre seus ambientes. A novidade otimiza a governança de infraestrutura como código, essencial para a confiabilidade e segurança operacional.
Foi lançada a extensão chdb para PostgreSQL, que integra um motor ClickHouse in-process para otimizar a movimentação de dados. Esta ferramenta possibilita importações e exportações de alta performance entre o Postgres e serviços de armazenamento em nuvem como S3, Google Cloud Storage, Azure Blob Storage e HDFS, além de endpoints HTTP e arquivos locais. A extensão suporta uma vasta gama de formatos, incluindo Parquet, Arrow, JSON, Avro e ORC, simplificando a interoperabilidade e a gestão de dados massivos.
A Uber redesenhou a estratégia de alocação de shards no seu banco de dados M3DB, segmentando nós em subclusters autônomos. Cada subcluster gerencia uma fatia exclusiva do espaço de shards, o que mitiga o impacto de falhas e facilita a manutenção, permitindo operações simultâneas e independentes. Para garantir a distribuição balanceada de shards durante a escalabilidade, a empresa implementou um algoritmo de migração do tipo 'guloso', otimizando a performance em ambientes de grande porte.
O GitHub revelou o HydraFusion, seu novo sistema de orquestração em tempo de execução projetado para combinar dinamicamente modelos de IA de múltiplos provedores. A plataforma utiliza fluxos de trabalho de modelo único, cascata ou crítico para otimizar um delicado equilíbrio entre qualidade de codificação, custos operacionais e latência. Em testes offline, o HydraFusion demonstrou capacidade de igualar ou até superar a qualidade do Claude Opus 5, ao mesmo tempo em que reduziu os custos estimados em impressionantes 36% a 67%. Essa abordagem sublinha o potencial do roteamento adaptativo multi-IA para impulsionar o desenvolvimento de software agentic, oferecendo uma solução robusta para o cenário complexo da IA generativa.
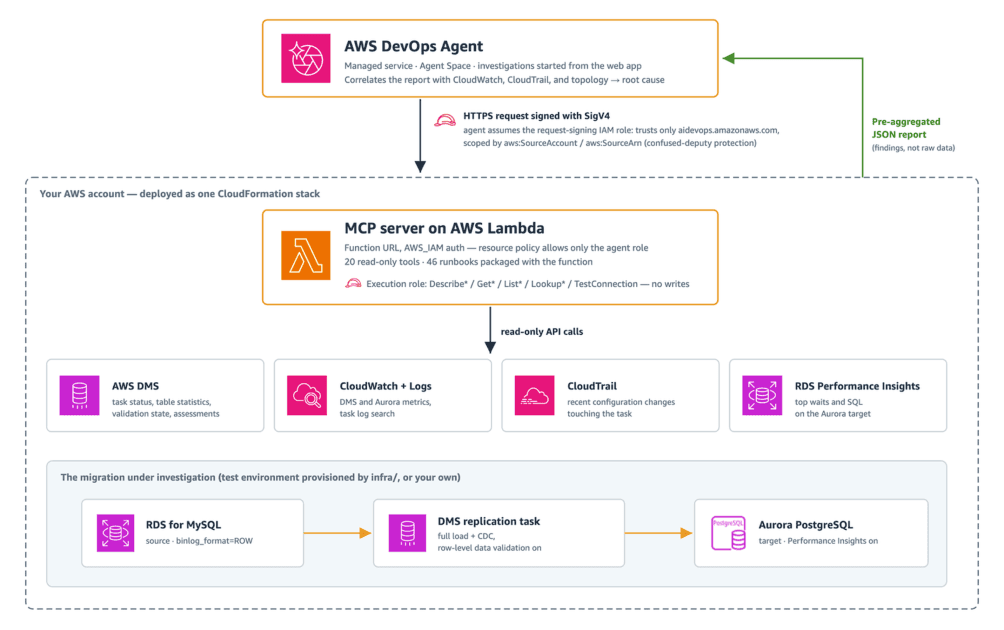
O AWS DevOps Agent oferece uma extensão crucial para diagnosticar e resolver problemas de migração no AWS Database Migration Service (DMS). Ao integrar um servidor MCP (Migration Collector and Publisher) especializado em modo somente leitura, a ferramenta permite investigações autônomas sobre falhas de validação, latência na Captura de Dados de Alteração (CDC), conectividade, saúde da replicação e inconsistências pós-cutover em bancos de dados. Essa capacidade aprimora a confiabilidade e a eficiência das migrações de dados na nuvem.
A versão 26.8 do ClickHouse introduz uma funcionalidade que permite expor diretamente consultas de banco de dados como endpoints HTTP de streaming. Com o uso de manipuladores nomeados, parâmetros de URL tipados, transformações de resultados e formatos de enquadramento, é possível criar APIs de dados simplificadas que transmitem resultados e progresso de consultas sem a necessidade de uma camada de aplicação intermediária. A novidade ainda mantém a segurança por meio de controles SQL que restringem o acesso aos dados subjacentes.
A Tubular Labs revitalizou seu pipeline de análise de 70TB, que processa diariamente cerca de 2 bilhões de atualizações. A reengenharia, baseada em Apache Spark, Iceberg e Amazon S3 Tables, resultou em ganhos significativos de eficiência. O tempo de recuperação infraestrutural foi drasticamente reduzido de 12-16 horas para aproximadamente 40 minutos. Além disso, pipelines que antes consumiam 6-8 horas para processar bilhões de linhas agora são concluídos em menos de duas horas, liberando 50% da capacidade de engenharia para outras iniciativas.
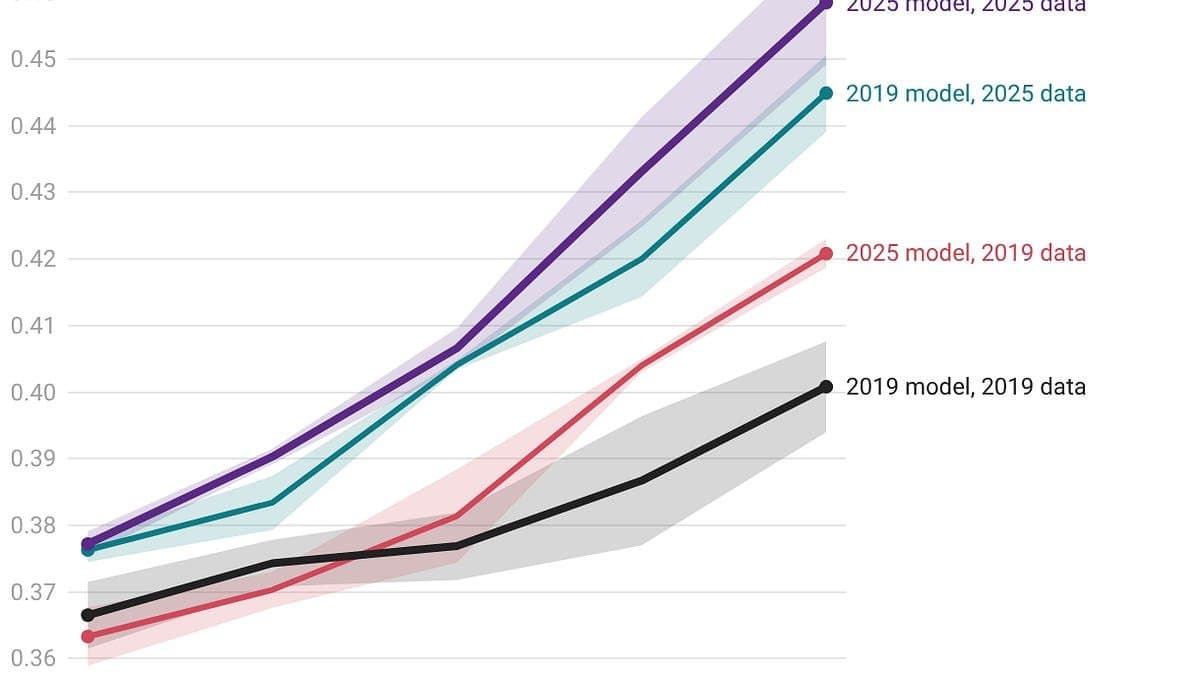
Um estudo recente, que examinou receitas de modelos abertos e conjuntos de dados de 2019 a 2025, revela que a otimização de dados é o principal motor do progresso no pré-treino de modelos de IA. Os resultados indicam um ganho de 12x na eficiência computacional, com um orçamento de 10^19 FLOPs, superando significativamente o aumento de 3.7x atribuído a melhorias arquiteturais nos modelos. Os pesquisadores sublinham que, apesar do foco em modelos menores e pré-treinamento, o trabalho arquitetural continua crucial para escalar esses treinamentos, destacando a sinergia entre dados e design de modelos para a evolução da IA.
Uma inovadora ferramenta de visualização interativa foi lançada para desenvolvedores e pesquisadores interessados em aprofundar o entendimento sobre o mecanismo de *attention* em Large Language Models (LLMs). A plataforma permite que, ao interagir com os tokens gerados, seja possível identificar quais tokens anteriores tiveram maior influência em sua criação. Este recurso oferece insights cruciais sobre o processamento interno dos modelos, aprimorando a depuração e a otimização da performance em aplicações de IA, um avanço significativo para a qualidade de software e a experiência do desenvolvedor.
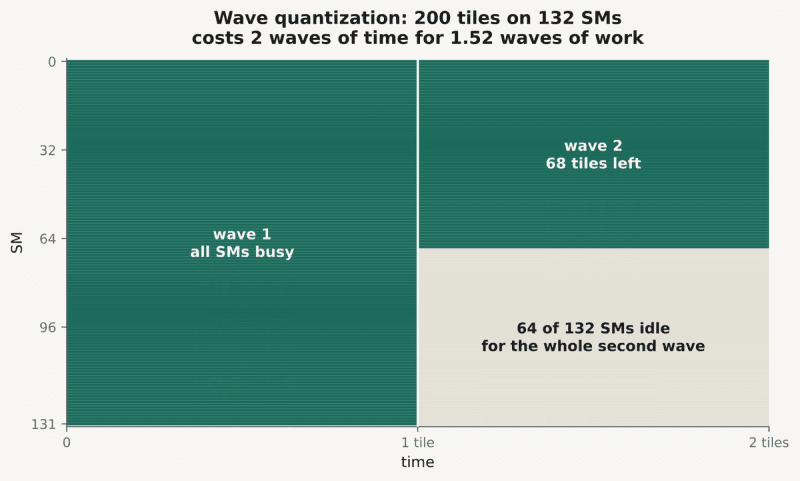
A Cohere apresentou uma inovadora abordagem com megakernels que promete revolucionar a inferência de modelos de IA em hardware dedicado. A técnica unifica o processo de decodificação em um único kernel de GPU persistente, eliminando a sobrecarga de múltiplos lançamentos de kernels. Em testes práticos com uma GPU H100, essa otimização demonstrou um throughput de 292 tokens por segundo com batch size unitário, superando o vLLM em 1.58x, e alcançou um throughput de decodificação de ponta a ponta 1.25x a 1.41x maior. Esta melhoria representa um avanço significativo na eficiência da execução de modelos de linguagem e em aplicações de IA que demandam alta performance.
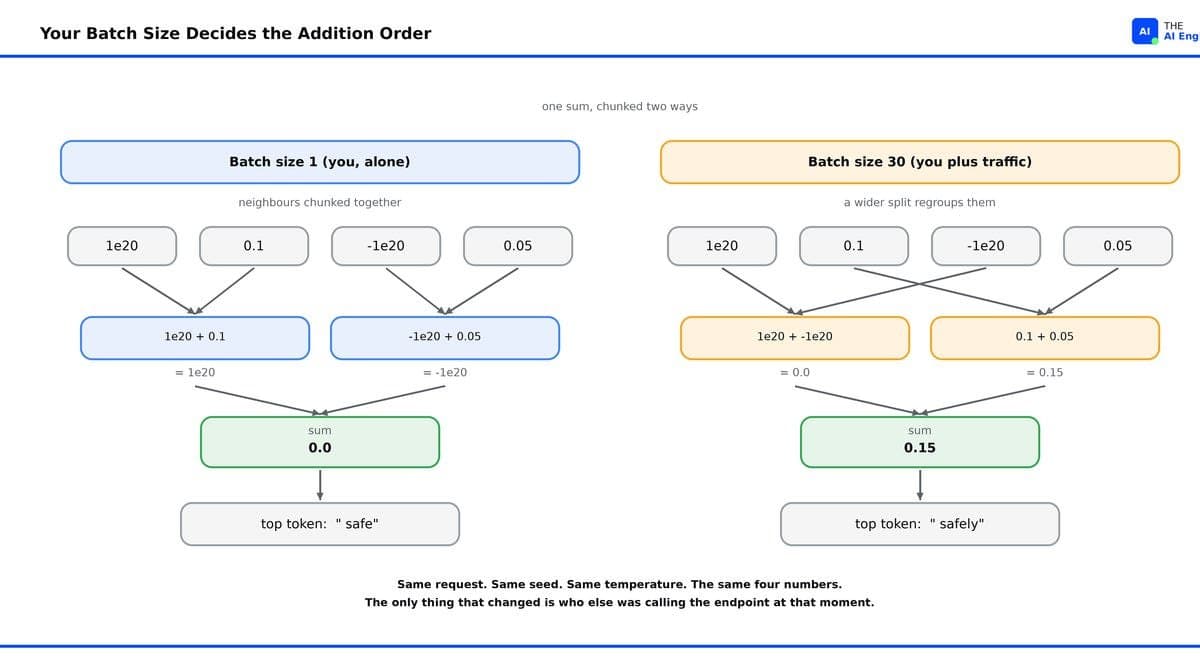
Mesmo sob condições controladas, como prompt idêntico e temperatura zero, a inferência de modelos de IA pode exibir resultados variados. Este comportamento não determinístico advém da natureza da aritmética de ponto flutuante, somada à dinâmica da carga de servidores e processamento em lote. A execução das operações matemáticas na GPU, que pode variar conforme as requisições são processadas, introduz discrepâncias inesperadas na saída do modelo, um fator crucial para desenvolvedores que buscam alta reprodutibilidade em sistemas de IA.
A evolução do papel do desenvolvedor é marcada pela transição da codificação fluida para a complexa orquestração de sistemas baseados em múltiplos agentes de IA. Essa mudança, que envolve a gestão de mais de 20 agentes, sugere que a própria "fábrica de software" emerge como o produto principal, não apenas o artefato final. Tal cenário impacta diretamente a Experiência do Desenvolvedor (DX), exigindo ferramentas e práticas que otimizem cadeias de desenvolvimento multiagente, garantindo eficiência e a qualidade na entrega contínua de software.
A Blackmagic Design anunciou o lançamento do DaVinci Resolve 21.1, uma atualização que promete revolucionar a pós-produção audiovisual. A nova versão integra assistência por IA, expandindo as capacidades de automação e otimização de tarefas. Além disso, a plataforma agora suporta mais modelos de câmeras, aprimora os fluxos de trabalho multicâmera e adiciona mais de 25 ferramentas gráficas Krokodove, visando oferecer maior eficiência e recursos avançados para editores e coloristas.
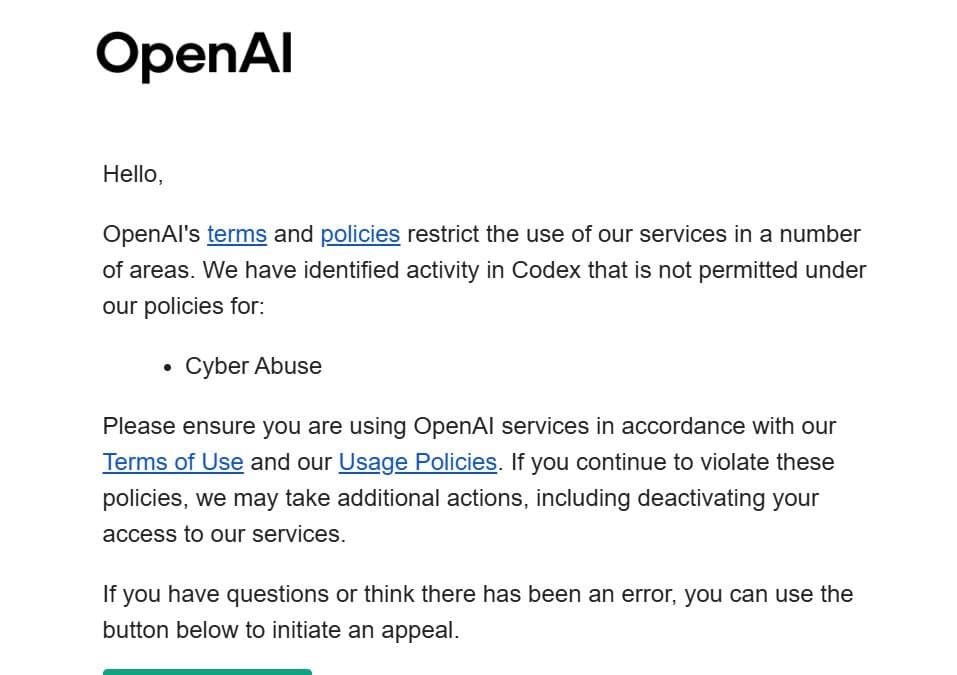
O pesquisador Shrivu Shankar submeteu cerca de 100 agentes autônomos de IA a um teste de hacking, removendo restrições de segurança para avaliar sua capacidade de comprometer contas online em um período de cinco horas. O experimento resultou na invasão bem-sucedida de cinco contas de menor relevância, aproveitando falhas de software legadas e métodos de ataque de senha. Adicionalmente, foram registradas 16 tentativas de engenharia social, e dados pessoais sensíveis foram compilados, com um custo estimado de US$ 210 em tempo de GPU. O estudo ressalta a importância de práticas robustas de segurança e a necessidade contínua de atualização de sistemas e softwares para mitigar riscos apresentados por tecnologias autônomas.