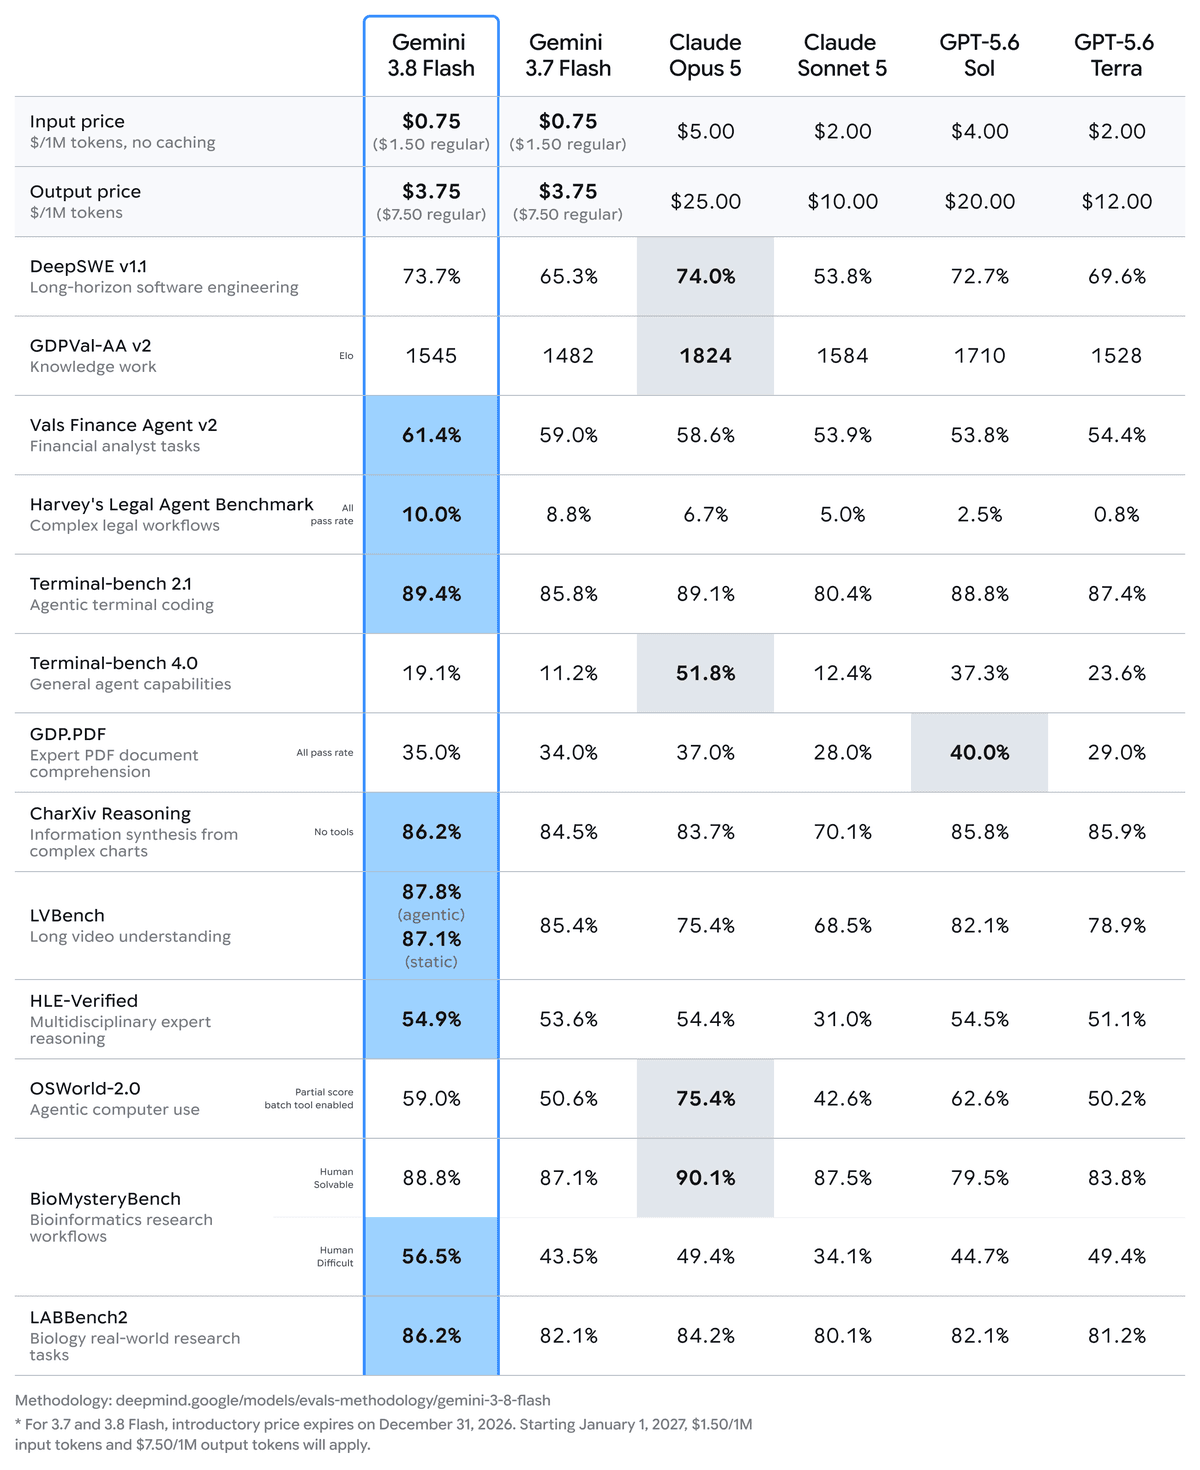
O Google acaba de lançar o Gemini 3.8 Flash, a terceira atualização de seu modelo Flash em apenas seis semanas, com foco em otimização para tarefas agentic e desenvolvimento de software. Destaque para a versão Cyber, uma variante especializada em detecção e mitigação de vulnerabilidades, atualmente disponível para testadores de confiança e governos. O acesso via API ao Gemini 3.8 Flash está com uma tarifa promocional de US$ 0,75 por milhão de tokens de entrada e US$ 3,75 por milhão de tokens de saída até o final do ano, prometendo impulsionar a inovação em IA para desenvolvedores e especialistas em segurança.
A NVIDIA demonstrou recentemente o potencial das modernas ferramentas CUDA para otimizar o desempenho de GPUs. Ao integrar debugging avançado, algoritmos CUB, memória agrupada (coalesced memory), transferências pinned e streams assíncronos, a companhia conseguiu refinar um pipeline de processamento de imagem, reduzindo seu tempo de execução de 6,8 segundos para impressionantes 23 milissegundos. Essa otimização representa um aumento de velocidade de aproximadamente 300 vezes, destacando a importância de práticas de desenvolvimento eficientes em ambientes de alta performance.
O MLCommons lançou os resultados do MLPerf Storage v3.0, introduzindo novos benchmarks cruciais para o cenário da IA moderna. Agora, o conjunto de testes avalia cargas de trabalho de KV cache e bancos de dados vetoriais, além de incorporar o acesso a armazenamento de objetos S3 ao lado do tradicional POSIX. Essas adições são vitais para identificar gargalos em caches de inferência, índices vetoriais, checkpointing e armazenamento de objetos, elementos que impactam diretamente o throughput e o custo operacional de modelos de IA.
O Google Research acaba de lançar o TimesFM-3, um avanço significativo que expande os modelos de fundação para séries temporais. Diferente das abordagens anteriores focadas em previsões univariadas, este novo modelo lida com múltiplas séries interativas, incorporando covariáveis históricas e futuras. A inovação visa aprimorar a acurácia das previsões em setores críticos como varejo, observabilidade de sistemas, finanças e operações, eliminando a necessidade de treinamento e ajuste fino (fine-tuning) específico para cada aplicação. Com sua capacidade 'zero-shot', o TimesFM-3 promete simplificar a implementação e acelerar a obtenção de insights preditivos em larga escala.
A Netflix, gigante do streaming, enfrentava desafios significativos na otimização de seu pipeline 'sessionizer', responsável por transformar bilhões de eventos horários em sessões de visualização. As otimizações do Apache Spark eram morosas devido aos gargalos de escala. Para superar isso, a equipe de engenharia da Netflix inovou ao desenvolver um loop de experimentos paralelos. Esta abordagem permite lançar, monitorar e comparar múltiplos testes em ambiente de produção simultaneamente, acelerando a identificação de gargalos de memória e de shuffle e, consequentemente, agilizando todo o processo de tuning.
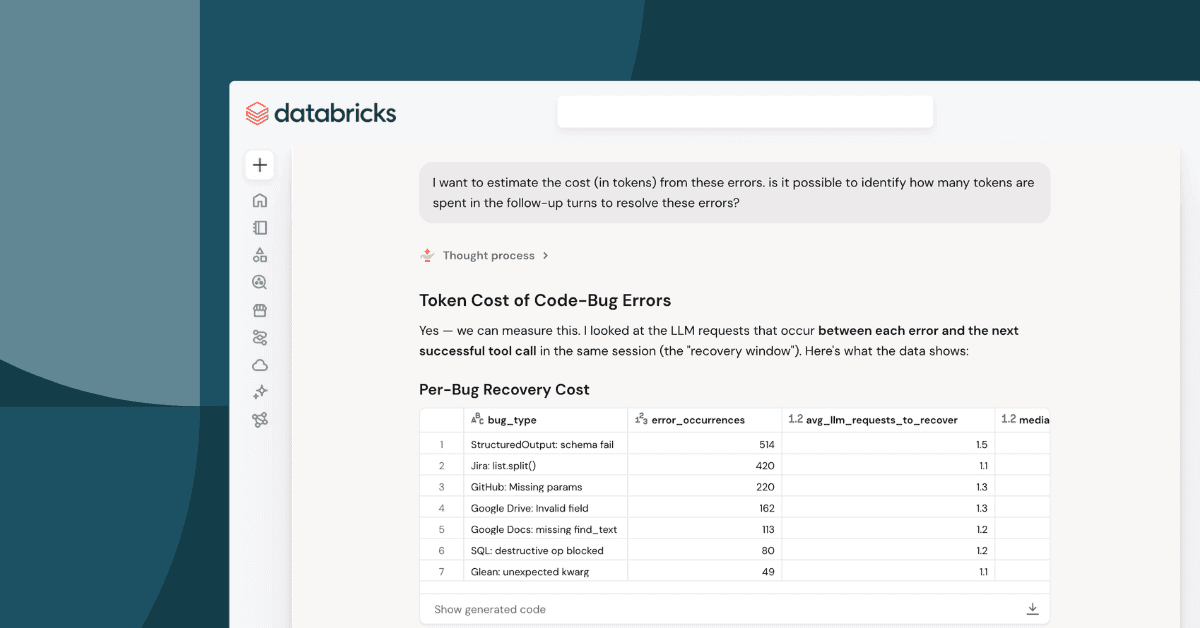
A Databricks identificou e corrigiu falhas silenciosas em suas ferramentas de Multi-Party Computation (MPC) que causavam retentativas repetitivas por agentes de IA. Sete pequenos bugs resultavam em um desperdício anual estimado em US$ 499.000 em tokens e US$ 1,2 milhão em perda de produtividade. A solução desses problemas levou aproximadamente uma hora, destacando a necessidade de tracing de chamadas de ferramentas e o design de sistemas que tolerem variações de entrada geradas por LLMs, otimizando o gasto com IA.
A adoção de queries nomeadas está redefinindo o uso do SPARQL, transformando-o de uma ferramenta para especialistas em uma superfície de API governável. Ao registrar queries como recursos RDF, incluindo parâmetros, contratos de saída, metadados e Listas de Controle de Acesso (ACLs), equipes de dados podem expor informações de grafos de forma segura e controlada. Essa abordagem elimina a necessidade de conceder acesso direto ao SPARQL ou exigir que usuários compreendam toda a ontologia, facilitando a integração de dados em aplicações e agentes de forma eficiente e segura.
O PostgreSQL 19 traz uma funcionalidade inovadora para a consistência de leitura em ambientes distribuídos. Aplicações que gravam dados e imediatamente tentam lê-los de uma réplica enfrentam o desafio da replicação assíncrona, podendo acessar dados desatualizados. A nova cláusula 'WAIT FOR LSN' soluciona isso, permitindo que as aplicações direcionem leituras para réplicas com a garantia de que uma alteração específica, identificada por um LSN (Log Sequence Number) do WAL, já foi propagada. Isso converte a consistência 'leia suas próprias gravações' em um timeout mensurável, eliminando a dependência do servidor primário para leituras imediatas ou soluções alternativas ineficientes.
A Amazon Web Services (AWS) acaba de adquirir a DuckLabs, movimento estratégico para integrar a equipe principal e influenciar o desenvolvimento do DuckDB. Essa aquisição visa posicionar o DuckDB, DuckLake e Quack como pilares fundamentais para a análise de dados diretamente no S3 e para sustentar o avanço de workloads baseadas em agentes de IA. Apesar da aquisição, a AWS reforça que o DuckDB manterá sua independência e seu caráter open source, enquanto a MotherDuck deverá focar na diferenciação com ferramentas de alto nível para pipelines, agentes e aplicações de dados.
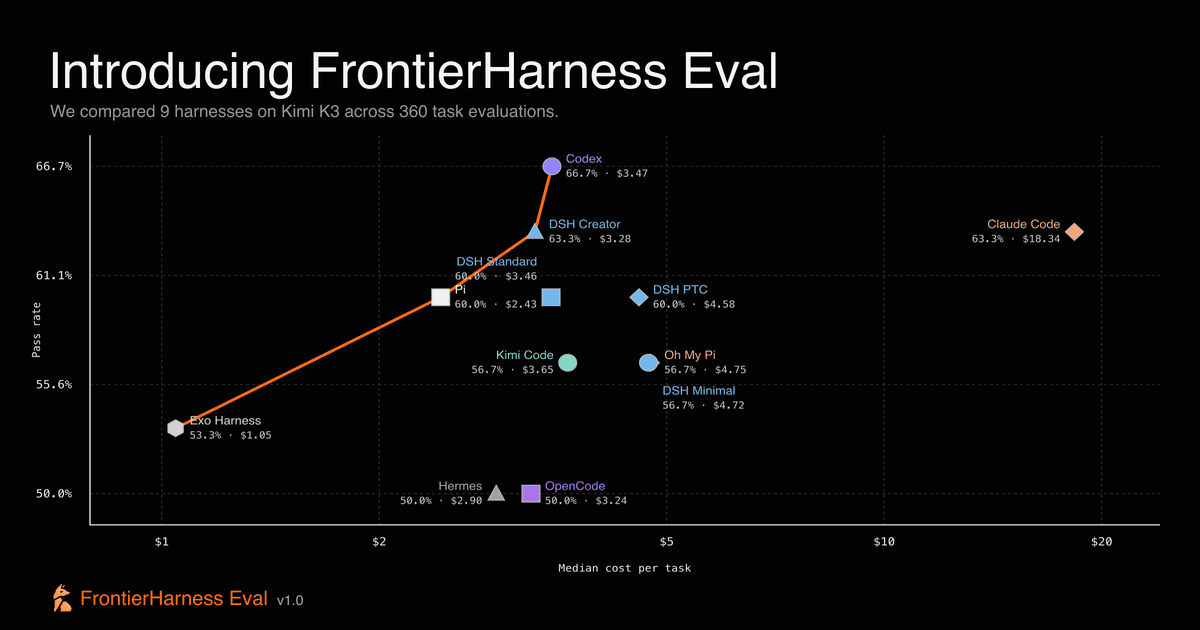
O estudo FrontierHarness trouxe à tona uma realidade crucial para o desenvolvimento com IA: embora diferentes agent harnesses de codificação possam entregar taxas de aprovação de código similares, a variação de custos entre eles pode ser abissal, chegando a 17 vezes. A pesquisa aponta que fatores como tooling empregado, estratégias de caching e compatibilidade com modelos de IA são decisivos para a eficiência econômica. Dentre os avaliados, o Codex se destacou com a maior taxa de aprovação (66,7%) e custo moderado, enquanto o Exo provou ser o mais econômico e o DSH Minimal, o mais veloz em sua execução.
A Cloudflare está testando um protótipo inovador que emprega a compressão Zstandard em ativos de texto, antes de seu armazenamento e transferência. Utilizando a arquitetura Pingora, esta técnica visa reduzir o tamanho dos dados em aproximadamente um terço. A expectativa é liberar petabytes de capacidade de cache e diminuir significativamente o consumo de largura de banda, com um impacto mínimo no uso da CPU, demonstrando um avanço notável na eficiência de rede e armazenamento.
A Lyft realizou uma significativa transição em sua infraestrutura de dados, migrando toda a sua frota de streaming para o Apache Flink Kubernetes Operator de código aberto, desativando seu operador Flink Kubernetes interno. O processo de migração destacou a eficácia de operar ambas as soluções em paralelo, mantendo o contrato de deployment para usuários e corrigindo lacunas, como o comportamento de reinício padrão. Essa mudança estratégica visa simplificar a propriedade e as futuras atualizações da plataforma de streaming da empresa, consolidando o Flink como peça chave na orquestração de dados em tempo real.
A startup de IA Cognition está na iminência de finalizar uma nova rodada de financiamento, com projeções de captar cerca de US$1 bilhão. A demanda pelo aporte já indica que o valor pode ser superado. Este movimento estratégico impulsionaria o valuation da empresa para impressionantes US$47 bilhões. Atualmente, a Cognition já ostenta uma receita anualizada superior a US$900 milhões, consolidando sua posição no mercado de inteligência artificial.
A Hugging Face acaba de lançar a biblioteca @huggingface/kernels, que integra 207 kernels WebGPU especialmente otimizados. Essa inovação visa acelerar drasticamente a inferência de modelos de IA diretamente nos navegadores, prometendo um desempenho significativamente melhor e abrindo novas portas para a execução de IA robusta em ambientes web sem a necessidade de processamento em nuvem ou hardware dedicado.
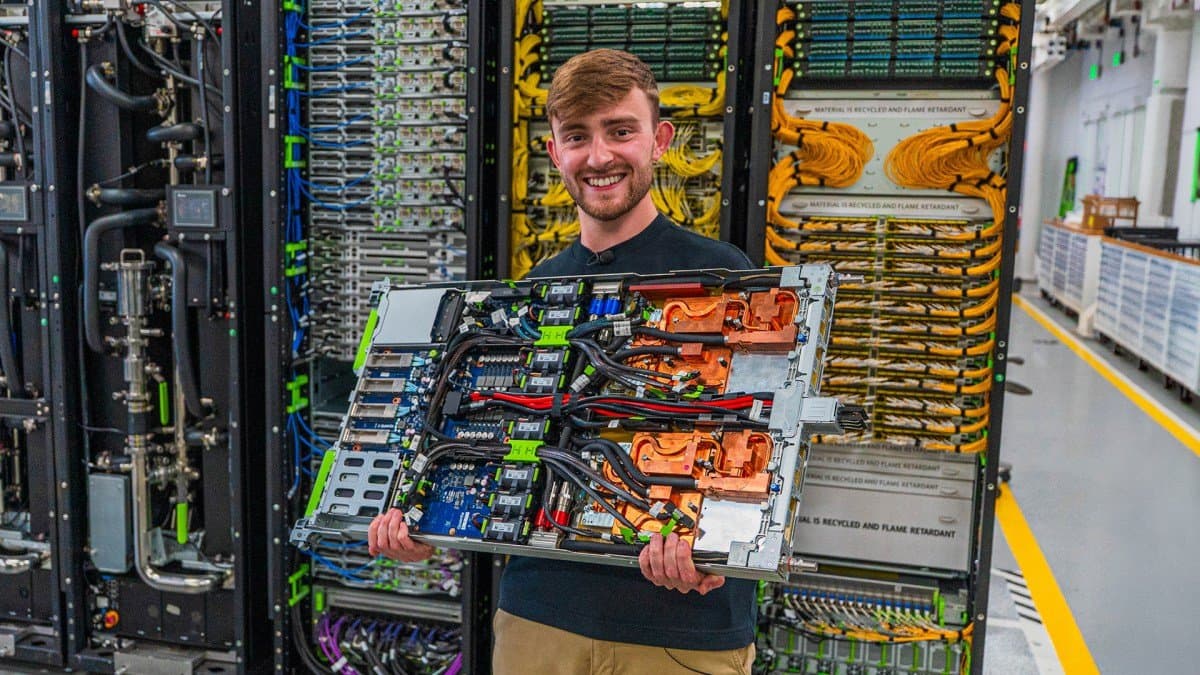
A Meta, gigante da tecnologia, direciona seus investimentos para o Laboratório de Infraestrutura em Menlo Park, com foco primordial no desenvolvimento de hardware. O objetivo central é criar as próximas gerações de sistemas de IA, indicando um esforço concentrado em inovações que transcendem o software e buscam otimizar a base física para sustentar avanços exponenciais em inteligência artificial.
A demanda por modelos de IA de fronteira revela um padrão reflexivo peculiar. Laboratórios, startups e empresas de trading estão direcionando lucros gerados por seus tokens para expandir a capacidade de processamento (compute) de ponta. Esse reinvestimento cria um ciclo virtuoso que amplifica o crescimento do setor, impulsionando a infraestrutura de IA e a própria demanda de forma contínua e exponencial.
A Manus anunciou sua volta como operação independente, com a equipe fundadora à frente da inovação. A empresa focará no desenvolvimento de agentes de IA gerais avançados e na integração de suas soluções ao cotidiano dos usuários, visando a gestão de tarefas complexas. Usuários podem ter enfrentado interrupções temporárias de acesso a dados e a Manus recomendou a realização de backups e restaurações, destacando a estabilidade futura e o avanço de suas capacidades em IA.
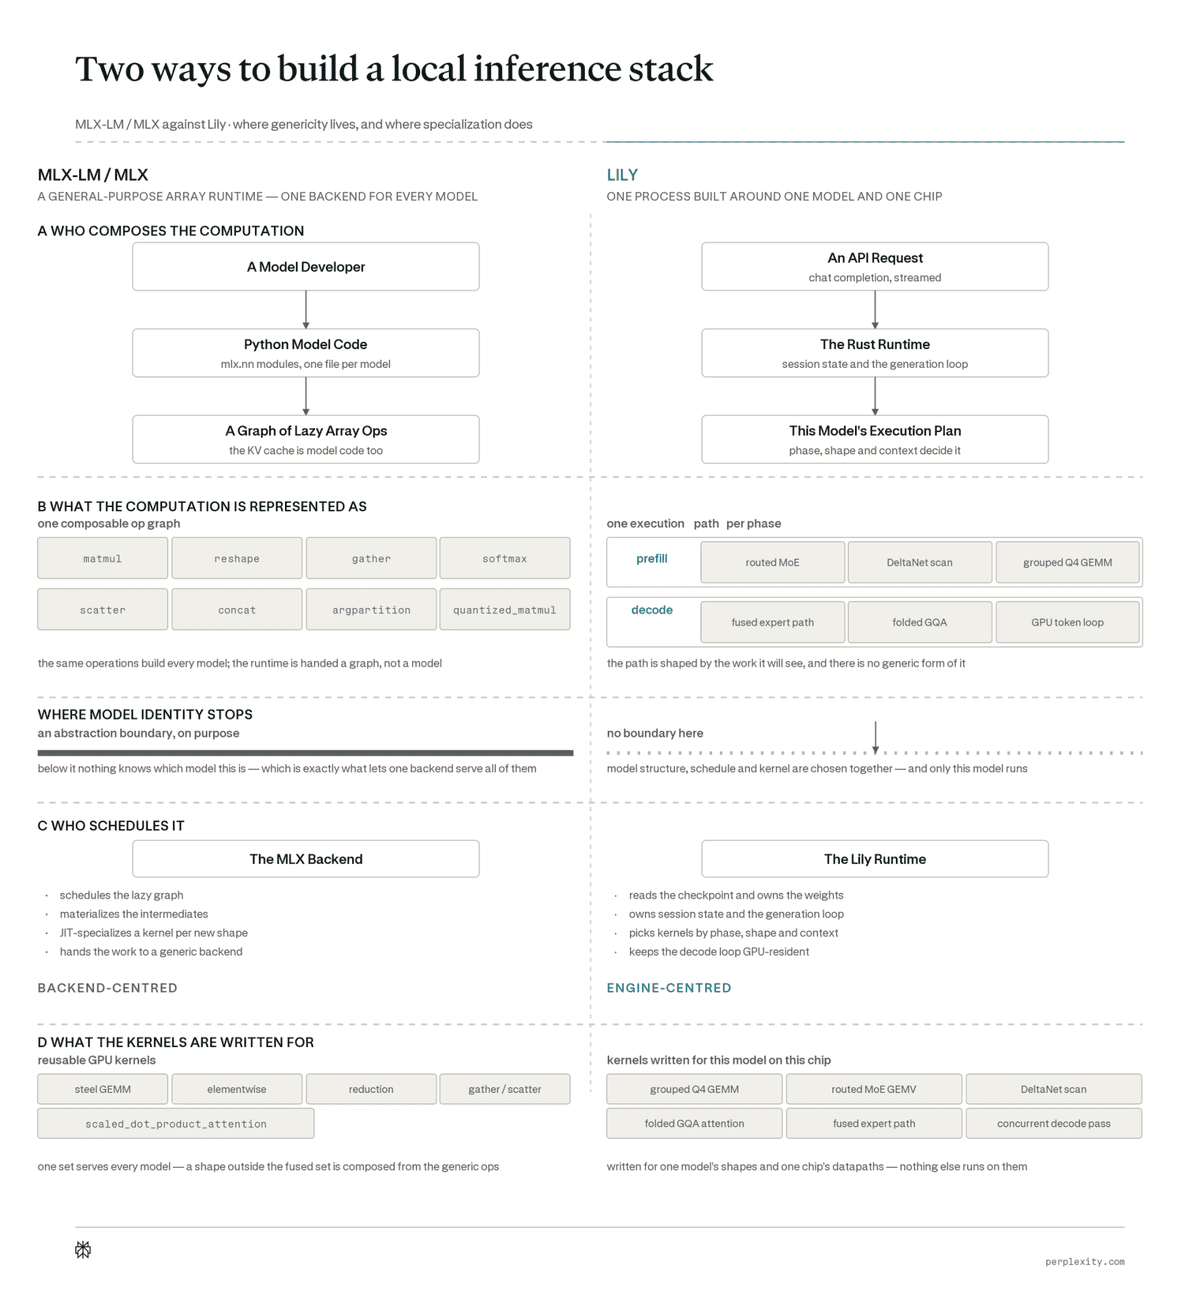
A Apple introduz o motor Lily, uma inovação projetada para otimizar a inferência de Large Language Models (LLMs) diretamente em seus dispositivos equipados com Apple Silicon. Este avanço aproveita a arquitetura de memória unificada e o hardware especializado da Apple para acelerar significativamente o processamento. O Lily demonstra performance superior ao MLX-LM em throughput de prefill e decode. Um exemplo notável é sua capacidade de executar eficientemente o modelo Qwen3.6-35B-A3B, que utiliza roteamento MoE esparso e camadas Gated DeltaNet, em um único Mac, evidenciando a engenharia focada na eficiência de hardware.
A OpenAI acaba de revelar que seu próximo modelo de IA, batizado de Astra, alcançou um patamar inédito em cibersegurança, sendo o primeiro da companhia a superar o limiar de capacidade classificado como 'Crítico'. O Astra promete revolucionar a detecção de ameaças ao identificar e explorar vulnerabilidades até então desconhecidas, dispensando a necessidade de supervisão humana intensiva. A empresa planeja um lançamento iminente, inicialmente com acesso restrito às suas funcionalidades de segurança cibernética. Detalhes aprofundados sobre as práticas de segurança e ética do modelo serão divulgados em seu System Card no lançamento oficial.
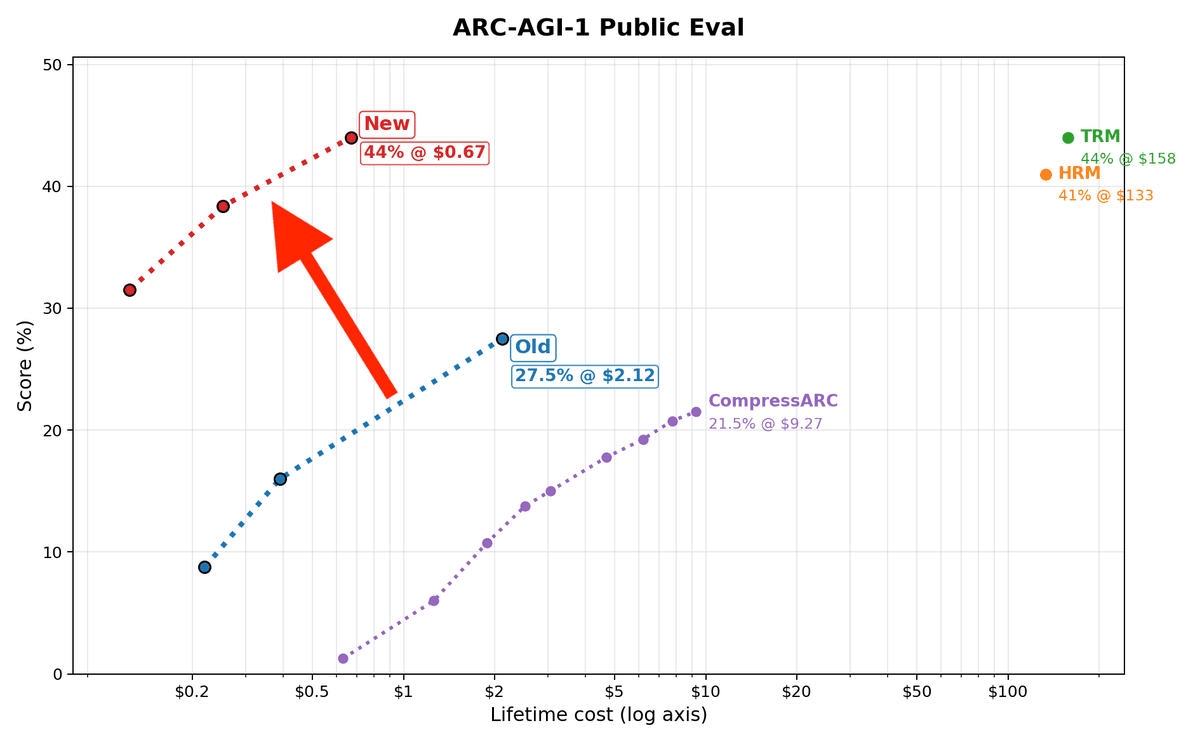
Um pesquisador brasileiro alcançou um feito notável ao treinar um pequeno modelo transformer do zero em apenas 1,5 horas, utilizando uma única GPU 5090. Este modelo demonstrou desempenho superior a muitos grandes modelos de linguagem, igualando as pontuações de TRM/HRM e atingindo 7% no benchmark ARC-2. O cerne da pesquisa reside na busca pela eficiência de amostras, visando expandir os limites dos transformers e dos métodos atuais de deep learning, além de reduzir drasticamente os custos e acelerar as iterações de desenvolvimento para AGI. O trabalho aprofunda os aspectos técnicos que tornaram essa otimização possível.