

A integração da IA na engenharia de software transformou o fluxo de trabalho dos desenvolvedores, deslocando o foco da codificação criativa para a supervisão de código gerado por IA. Essa forte dependência de ferramentas automatizadas traz o risco de corroer as habilidades e o conhecimento técnico dos profissionais, uma vez que a resolução de problemas complexos pode acabar sendo deixada em segundo plano.
CEVIU News
As melhores notícias de tecnologia, curadas diariamente para quem vive tech.
1954 notícias encontradas

Os service workers têm perdido relevância devido a complicações como estratégias de cache ineficazes e o surgimento de alternativas mais simples. Embora eles ofereçam funcionalidades exclusivas, como suporte offline e sincronização em segundo plano, muitos casos de uso podem ser tratados de forma mais eficiente sem a complexidade dessa tecnologia.

Este tutorial apresenta um guia prático para a configuração de agentes de código locais utilizando ferramentas e modelos de código aberto, destacando as vantagens dessa abordagem em relação aos serviços proprietários. O uso de LLMs locais proporciona maior transparência, controle, eficiência de custos e privacidade para o fluxo de desenvolvimento. O artigo também aborda as melhores práticas para avaliar o desempenho dos modelos, garantir a segurança durante a implementação através de protocolos de safety e otimizar os ambientes locais, promovendo um uso eficiente e responsável dessas ferramentas.

O avanço da IA na matemática acendeu um debate entre pesquisadores sobre o papel dos matemáticos humanos, suas motivações e o futuro da disciplina, à medida que sistemas de IA começam a resolver tarefas antes consideradas exclusivamente humanas. Embora alguns matemáticos prevejam um futuro colaborativo, onde humanos e IA trabalham juntos para solucionar problemas complexos, persistem preocupações sobre o potencial da tecnologia de reduzir o pensamento crítico e a criatividade.

Uma startup em rápido crescimento enfrentou sérios desafios com seu sistema de faturamento legado, que se tornou cada vez mais complexo devido a inúmeras gambiarras e regras de negócio não documentadas. Ao simplificar o modelo de dados e implementar mudanças direcionadas com base no feedback dos usuários, a equipe conseguiu automatizar a emissão de notas fiscais, reduzindo o tempo de processamento de uma semana para apenas dois dias.
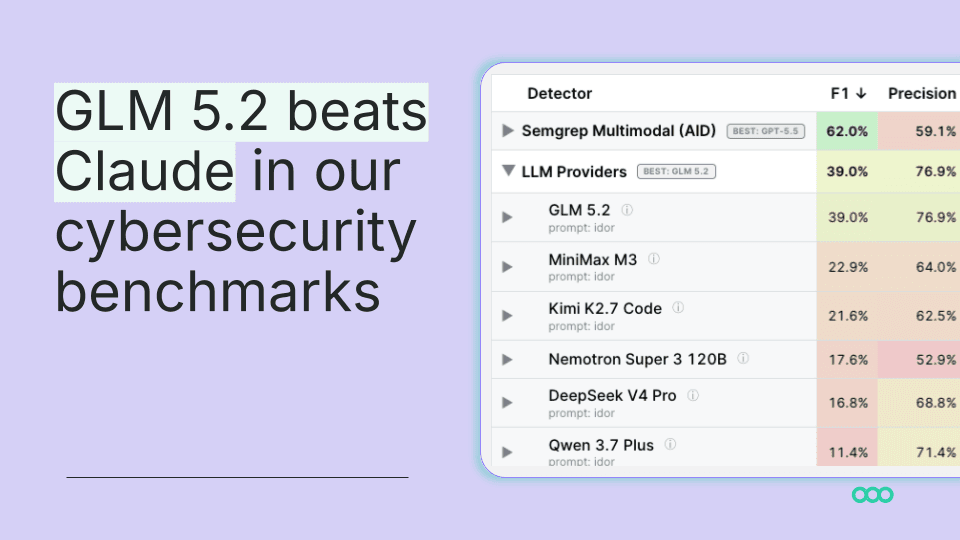
Testes recentes da Semgrep mostraram que o modelo open-weight GLM 5.2 superou o Claude Code na detecção de Referências Indiretas Inseguras a Objetos (IDORs). O resultado foi alcançado mesmo sem o modelo contar com as capacidades avançadas de harnessing utilizadas no pipeline multimodal da Semgrep.

O mercado de trabalho para desenvolvedores está passando por profundas transformações impulsionadas pelo avanço da IA, resultando em demissões em massa e na redução do valor percebido dos cargos de desenvolvimento de software. Com a criação de software cada vez mais facilitada e um número maior de pessoas capazes de avaliá-lo, o setor caminha para um cenário em que as empresas passam a focar na venda de serviços em vez de produtos.

O conceito de "tokenmaxxing" já foi visto como uma abordagem imprudente para o consumo de recursos de token nas empresas, mas pode ter evoluído de aplicações equivocadas para uma implantação muito mais estratégica em iniciativas de IA.

Startups asiáticas de IA introduziram no mercado os modelos Tulongfeng e Fugu, projetados para competir diretamente no setor enquanto as restrições de exportação dos produtos da Anthropic impostas pelos EUA continuam em vigor.

ATUALIZAÇÃO (02/07/2026): não é mais rumor, foi lançado. 22 de junho de 2026. Astro 7.0 foi lançado com foco em performance, apresentando um compilador .astro reescrito em Rust, o que contribui para construções 15-61% mais rápidas. A versão também incorpora o Vite 8 com o bundler Rolldown, baseado em Rust, que substitui o esbuild e o Rollup, sendo 10-30 vezes mais rápido que o Rollup em benchmarks. Além disso, o processamento de Markdown e MDX agora utiliza um pipeline baseado em Rust chamado Sätteri, otimizando ainda mais o desempenho para sites com muito conteúdo. (Rumor original) O Astro 7.0 foi lançado oficialmente com foco principal em melhorias significativas de desempenho. O compilador .astro foi reescrito em Rust e o processamento de Markdown e MDX agora utiliza o novo pipeline Sätteri, também baseado em Rust. Com o motor de renderização baseado em fila e a atualização para o Vite 8, que traz o empacotador Rolldown, o tempo de build do Astro 7.0 está de 15% a 61% mais rápido, além de builds gerais ficarem até 30 vezes mais velozes. A nova versão também estabilizou o caching de rotas com uma API agnóstica de plataforma e suporte experimental a CDNs como Netlify, Vercel e Cloudflare. Outras novidades incluem o Roteamento Avançado com suporte ao Hono para middleware, detecção de agentes de codificação com logs JSON estruturados e um compilador Rust mais rigoroso que não corrige HTML silenciosamente, emitindo erros para tags não fechadas. Anteriormente, a versão 6.0 havia reestruturado o servidor de desenvolvimento para rodar o mesmo runtime de produção e introduzido recursos como Live Content Collections e suporte nativo a CSP.
O Redis 8.8.0 consolida-se como a versão mais estável, trazendo a nova estrutura Array, o limitador de taxa INCREX e ganhos de desempenho em HyperLogLog, MGET/MSET, HGETALL e SCAN, além do agregador COUNT para conjuntos ordenados e notificações por campo em hashes. Já o Redis 8.2 (agosto/2025) otimizou uso de memória e introduziu o índice vetorial SVS-VAMANA para buscas nativas em cargas de IA, com correção 8.2.7 em junho/2026. O roadmap aponta lançamento anual do Redis 9, com foco em nuvem, pipelines de IA em tempo real e transformação em plataforma translytical unificada, suportando operações críticas e RAG.
O .NET 10 já foi disponibilizado pela Microsoft como uma versão de Long Term Support (LTS), trazendo melhorias de desempenho no compilador JIT, suporte a AVX10.2, aprimoramentos no NativeAOT e recursos de criptografia pós-quântica. O ecossistema também foi atualizado com o C# 14, F# 10, ASP.NET Core 10.0 e EF Core 10, que inclui suporte a busca vetorial para Azure Cosmos DB. Seguindo o ciclo anual de lançamentos da empresa, a expectativa agora se volta para o .NET 11. Previsto para novembro de 2026, o .NET 11 deve ser a próxima grande versão da plataforma, embora ainda não tenham sido divulgados detalhes oficiais ou rumores específicos sobre seus novos recursos.
O MongoDB 8.0 segue como versão estável mais recente, com GA anunciada no final de 2024 e atualizações contínuas nas séries 8.2 e 8.3. O MongoDB Atlas está disponível em AWS, Google Cloud e Azure, além de opções on-premises e Community Edition. Embora o MongoDB 9.0 já conste em documentos oficiais sobre versionamento e migração, não há data de lançamento nem detalhes técnicos divulgados. É importante destacar que as versões Mongoid 9.0 são do ODM para Ruby, não do servidor MongoDB.
ATUALIZAÇÃO (02/07/2026): não é mais rumor, foi lançado. 25 de outubro de 2025. O MySQL 9.5.0 foi lançado como parte da trilha "Innovation" da Oracle, que oferece os recursos e melhorias mais recentes. Ele faz parte do modelo de lançamento dual da Oracle para o MySQL, que inclui trilhas "Innovation" e "LTS" (Long-Term Support) para atender a diferentes necessidades dos usuários. A versão 9.5.0 está disponível para download em diversas plataformas e é recomendada para uso em sistemas de produção. (Rumor original) O MySQL Server 9.5.0 Innovation foi lançado em outubro de 2025, com destaque para o MySQL AI 9.5.0, que traz AutoML baseado em PyTorch e detecção de anomalias via embeddings, e o MySQL HeatWave 9.5.0, voltado à automação de formatos temporais e suporte nativo a Delta Lake. Enquanto isso, a versão LTS 9.7 chegou em abril de 2026, consolidando estabilidade. A Oracle mantém duas trilhas: Innovation (novos recursos a cada três meses) e LTS (atualizações críticas por cinco anos), alinhadas às necessidades de desenvolvedores e ambientes produtivos.

Duas vulnerabilidades foram identificadas em aplicações web da Johnson & Johnson. A primeira afetou um sistema de recrutamento de campus, expondo dados de quase mil estudantes devido a uma falha simples de configuração que utilizava uma chave de API em vez de autenticação por token adequada. A segunda brecha permitia o controle administrativo de um sistema de auditoria interna utilizado por 20 empresas, possibilitando acesso não autenticado a informações confidenciais de funcionários por meio de APIs mal protegidas.

Uma divisão está surgindo entre aqueles que adotam a tecnologia de IA e aqueles que a rejeitam, criando experiências e oportunidades distintas para cada grupo. Indivíduos que utilizam IA tendem a ser muito mais produtivos e inovadores, o que intensifica os sentimentos de injustiça e frustração entre aqueles que permanecem céticos ou desengajados.
A Cloudflare introduziu o suporte a OAuth autogerenciado, permitindo que desenvolvedores criem e gerenciem seus próprios clientes OAuth para acesso seguro a APIs.
Uma decisão recente de um tribunal alemão determinou que o Google é legalmente responsável por imprecisões apresentadas em seus resumos de busca gerados por IA.
As scaling laws no aprendizado profundo demonstram como a perda de treinamento diminui de forma previsível à medida que o tamanho do modelo, o volume do conjunto de dados e os recursos de compute aumentam, seguindo geralmente uma relação de lei de potência. Estudos empíricos revelam que modelos e conjuntos de dados maiores proporcionam um aprendizado mais eficiente. Os resultados sugerem que a alocação ideal de recursos entre o tamanho do modelo e o volume de dados é fundamental para minimizar o erro de generalização.
Muitas empresas que lidam com cargas de trabalho em infraestrutura de nuvem enfrentam repetidamente gargalos de latência causados pelo acesso lento a dados. Esse cenário força as equipes de infraestrutura a desenvolverem soluções próprias de cache do zero, embora esses projetos quase sempre convirjam para designs extremamente semelhantes. A dependência cada vez maior de instâncias computacionais efêmeras e o crescimento constante no volume de dados agravam o problema. Como consequência, múltiplos times acabam projetando seus próprios métodos proprietários de cache de forma isolada, sem o compartilhamento dessas soluções entre si.