O ecossistema de LLMs open source está mais maduro e diversificado em meados de 2026. Destacam-se o GLM-5.1 da Zhipu AI, voltado para agentes autônomos e tarefas complexas, e o MiMo-V2.5-Pro da Xiaomi, com arquitetura Mixture-of-Experts. A Moonshot AI lançou o Kimi-K2.6, otimizado para codificação e contexto longo; a Alibaba Cloud trouxe o Qwen3.5-397B-A17B; e há ainda o DeepSeek-V4-Pro, o Llama 4 da Meta, a Gemma 4 do Google e o Phi-4 Reasoning da Microsoft, este último focado em raciocínio avançado e eficiência operacional.
A Anthropic tem intensificado sua estratégia de aquisições desde dezembro de 2025, incorporando empresas como Bun, Vercept, Coefficient Bio, Stainless e Fractional AI para fortalecer seu ecossistema de desenvolvimento, agentes de IA e consultoria empresarial. Agora, surgem especulações de que a companhia estaria em negociações avançadas para adquirir a Atlassian, movimento que permitiria integrar o Claude ao Jira e Confluence, aproveitando o vasto conjunto de dados de tarefas da Atlassian. Embora a viabilidade da operação seja debatida devido à escala da empresa e às demandas de capital da Anthropic, que possui avaliação de 965 bilhões de dólares e planeja seu IPO para o segundo semestre de 2026, a movimentação ilustra a busca por expansão estratégica antes da entrada no mercado de capitais.
A aquisição mais recente anunciada pela OpenAI é a da alemã Ona, uma plataforma de orquestração de agentes de IA, com o objetivo de fortalecer o Codex e permitir tarefas de longa duração em ambientes de nuvem. A OpenAI não revelou os valores do negócio, que ainda aguarda aprovação regulatória. Além da Ona, a empresa adquiriu diversas startups entre 2023 e 2026, incluindo nomes como Astral, Promptfoo e OpenClaw, demonstrando uma estratégia contínua de expansão via M&A. Não há rumores sobre novos alvos de compra no momento, sendo que negociações anteriores, como a da Windsurf em 2025, enfrentaram impasses contratuais.
O ano de 2026 registra um aumento acentuado de demissões atribuídas à IA, que se consolidou como o principal motivo declarado para cortes de vagas nos EUA. Estima-se que dezenas de milhares de postos de trabalho foram eliminados sob essa justificativa, com projeções indicando uma intensificação da tendência. Entre maio de 2026 e períodos anteriores, setores de tecnologia e grandes empresas como Intuit, Meta, Cisco, Cloudflare e Oracle anunciaram reestruturações citando a IA como fator central. O impacto é especialmente sentido em funções de nível júnior, que enfrentam maior dificuldade de contratação, enquanto cresce o debate sobre a possível lavagem de IA, onde a tecnologia é usada para mascarar cortes estruturais de outra natureza.
O debate sobre agentes de IA substituindo o modelo SaaS deixou de ser um rumor e consolidou-se como realidade. Com 79% das organizações já utilizando agentes e a previsão da Gartner de que 40% dos aplicativos empresariais incorporarão essas tecnologias até 2026, o cenário de ferramentas de software está em transformação. Plataformas como Microsoft, Salesforce, ServiceNow e editores como o Cursor já integram capacidades onde agentes executam fluxos de trabalho completos em vez de apenas responder a perguntas. Esse movimento, apelidado de SaaSpocalipse, reflete o declínio nas avaliações de empresas SaaS tradicionais. Projeções indicam que 35% das ferramentas SaaS de produto único poderão ser absorvidas por ecossistemas de agentes até 2030, embora analistas prevejam uma transição gradual com a persistência de sistemas legados por anos.
O ecossistema de Large Language Models gratuitos e open-weight apresentou avanços significativos em 2026. Entre as principais liberações estão o Qwen 3.7 Max da Alibaba Cloud, com suporte a 1 milhão de tokens, o DeepSeek V4 Pro, otimizado para código e matemática, e o Kimi K2.6 da Moonshot AI, focado em agentes e capacidades multimodais. Outros modelos relevantes incluem o GLM-5.1 da Zhipu AI, a série MiMo-V2.5 da Xiaomi, o Gemma 4 do Google, a linha Llama 4 da Meta e o Phi-4 da Microsoft. O mercado atual encontra-se em uma fase de rápida adoção e avaliação técnica dessas novas versões.
Redes de modelos de IA menores estão superando todos os sistemas de IA de fronteira atuais em termos de velocidade, precisão e custo. Assim como a visão sobre os mainframes na década de 1960 estava equivocada, o pensamento atual sobre a IA centralizada também está. O futuro aponta para uma rede de redes neurais.
A contagem de objetos permanece fragmentada entre datasets e tarefas específicas de cada domínio. Os modelos atuais de contagem são frequentemente adaptados a cenários restritos, apresentando dificuldades para generalizar entre categorias, domínios visuais, escalas de objetos e distribuições de densidade. Este artigo apresenta um modelo generalista para contagem de objetos guiada por texto que alcança alta precisão e capacidade de generalização em múltiplos domínios.
ATUALIZAÇÃO (16/06/2026): não é mais rumor, foi lançado. 08/06/2026. A Apple lançou oficialmente a Siri AI na WWDC 2026, revelando uma versão significativamente aprimorada da Siri. Esta nova Siri AI é alimentada pelos "Apple Foundation Models" da própria empresa e, notavelmente, integra modelos Gemini do Google através de uma "colaboração profunda" para expandir suas capacidades. Entretanto, o sistema de extensões para IA de terceiros, que permitiria aos usuários do iPhone alternar entre diferentes modelos como ChatGPT, Claude da Anthropic e Gemini do Google diretamente na Siri, (Rumor original) O beta do iOS 27 contém um sistema de extensões para IA de terceiros, incluindo um painel de configurações e uma seção dedicada na App Store. Embora ambos tenham sido desenvolvidos, eles estão desativados no backend. A Apple manteve discussões com grandes provedores de IA para conceder autorizações para o framework, mas a empresa decidiu não anunciar o recurso por enquanto.
Rafa Schwinger faz engenharia reversa do Claude Mythos e do Fable, argumentando que a verdadeira vantagem competitiva não reside na arquitetura, mas no ambiente de desenvolvimento, o foundry. A capacidade é decomposta como a base de fundação multiplicada pelo sinal graduável extraído, tornando a recompensa verificável o insumo escasso e decisivo, uma vez que o texto e o compute bruto deixaram de ser. A receita combina pretraining denso, RL com verificador estilo GRPO, onde a solidez contra o reward-hacking é a restrição real, e recompensas de processo de longo horizonte com context-folding aprendido que supera janelas de um milhão de tokens operando a 32K ativos, além do test-time compute de best-of-N exposto como um controle de esforço.
Satya Nadella, CEO da Microsoft, defende que toda empresa precisa construir tanto capital humano quanto capital de token para sustentar sua evolução tecnológica.
Esta thread analisa a teoria de que o foco da DeepSeek em modelos open-source, compartilhamento de pesquisas e desenvolvimento de infraestrutura faz parte de uma estratégia mais ampla. O objetivo seria se tornar uma infraestrutura de IA fundamental, em vez de competir diretamente no mercado de produtos de consumo.
O Open Knowledge Format é uma especificação aberta que formaliza o padrão LLM-wiki em um formato portátil e interoperável. A solução é agnóstica a fornecedores e projetada para ser amigável tanto para agentes quanto para humanos. Este padrão permite representar metadados, contexto e o conhecimento curado que sistemas de IA modernos exigem.
A Anthropic informou que desativou o Fable 5 e o Mythos 5 para todos os usuários após receber uma diretriz de controle de exportação do governo dos Estados Unidos, vinculada a preocupações de segurança nacional e riscos reportados de jailbreak.
A plataforma Blackwell Ultra NVL72 da NVIDIA lidera o benchmark AgentPerf, entregando 20 vezes mais throughput de agentes por megawatt em comparação com a arquitetura NVIDIA Hopper.
OpenAI e Anthropic adotam estratégias distintas para a gestão de contexto em modelos de linguagem. A OpenAI utiliza técnicas de compactação, comprimindo os dados para manter apenas as informações relevantes em uma única thread longa, o que preserva a coerência. Por outro lado, a Anthropic segmenta as janelas de contexto entre vários agentes, onde cada um processa subproblemas independentes. Nesse modelo, os subagentes executam tarefas complexas e devolvem apenas o necessário para o agente principal, embora essa abordagem possa gerar redundância, perda de informações e um consumo maior de tokens.
O sistema de engenharia do Devin garante uma produtividade superior ao custo operacional, com o compromisso de US$ 10 milhões por cliente. A eficácia da plataforma é validada por meio de dados independentes, reforçando a confiança na produtividade de engenharia entregue pelo sistema.
A Ramp disponibilizou seu próprio benchmark privado, construído a partir de desafios reais de engenharia enfrentados internamente. O objetivo é fornecer à equipe uma forma precisa de avaliar modelos de codificação dentro do seu ecossistema real de software financeiro.
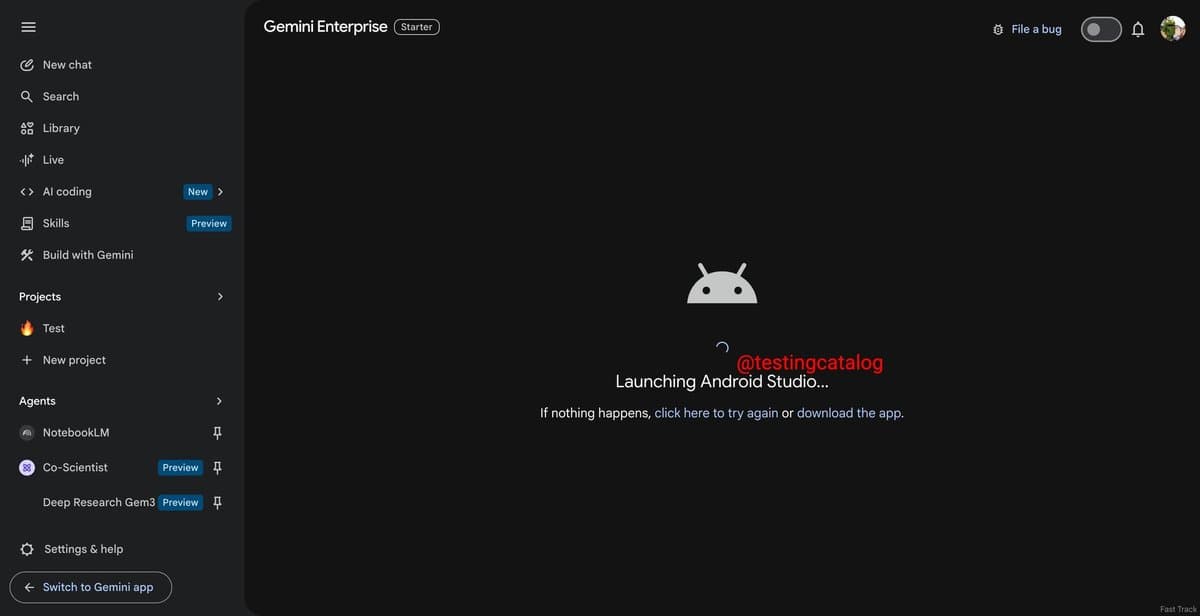
ATUALIZAÇÃO (16/06/2026): não é mais rumor, foi lançado. 22/04/2026 O Google anunciou oficialmente o "Agent Marketplace integrado à Agent Gallery" para o Gemini Enterprise durante o Google Cloud Next '26. Este marketplace permite que as organizações encontrem e implementem agentes especializados de terceiros de parceiros como Accenture, Oracle e ServiceNow. Embora o conceito de um "Skills Marketplace" mais amplo para o Gemini Business esteja em desenvolvimento e novas funcionalidades estejam sendo lançadas (como a conexão com o Google Business Profile em junho de 2026), o anúncio do Agent Marketplace no Cloud Next '26 marca um lançamento oficial de uma plataforma de marketplace para habilidades de IA no contexto do Gemini Enterprise. (Rumor original) O Google está integrando seus produtos sob o Gemini Enterprise com uma nova aba de Skills Marketplace para habilidades pré-definidas e otimizadas pelo Google. O marketplace, voltado para ajudar equipes a desenvolverem dashboards e ferramentas de relatórios sem atrasos de engenharia, inclui uma UI de gerenciamento de habilidades, um construtor de habilidades e o próprio marketplace.
Para estimar o preço por usuário, é necessário considerar especificações de hardware de GPU, tamanho do contexto, contagem de parâmetros ativos do modelo e fatores específicos do produto. Surpreendentemente, as particularidades da arquitetura do modelo importam pouco, exceto em casos como diffusion. Este artigo detalha como realizar esses cálculos matemáticos, demonstrando como otimizações em motores de inference permitem que produtos SaaS mantenham a lucratividade.