A OpenAI adquiriu a Orchestra Bio, plataforma em que pessoas e agentes de IA trabalham juntos em programas de desenvolvimento de medicamentos. Equipe e tecnologia passam a integrar o Rosalind, conjunto de modelos e ferramentas da empresa para ciências da vida, que já inclui o GPT‑Rosalind e o Rosalind Workbench. A aposta: levar tratamentos mais cedo aos pacientes, num processo que leva de 10 a 15 anos. Os agentes monitoram estudos, identificam o impacto de falhas, como um lote defeituoso que atrasa um ensaio clínico, e comparam respostas. A OpenAI cita ainda parcerias com Novo Nordisk e Moderna.
Um ano após o lançamento, o AnyLanguageModel chega à versão 1.0, junto com swift-huggingface 1.0 e swift-xet 1.0. A biblioteca segue como substituto drop-in do Foundation Models da Apple: basta trocar o import para usar o mesmo código de sessão com o modelo do sistema, modelos open-weight via llama.cpp, MLX e Core ML, ou providers hospedados como OpenAI, Anthropic, Private Cloud Compute e Hugging Face Inference Providers. Tool calling e guided generation agora funcionam em todos os providers, com suporte a imagens nos prompts, reasoning no transcript e chaves de API via closure. Entre os modelos recomendados estão Gemma 4 E2B (~3,4 GB) e LFM2.5 2.6B (~1,7 GB), que cabem em um iPhone, e o Qwen3.8 27B em MLX, para Macs com 32 GB ou mais. A biblioteca também roda em Linux.
A equipe de PyTorch da Hugging Face detalha as novidades do MPS no PyTorch 2.15. O FP8 chega com tensores float8_e4m3fn, metade do espaço do BF16, e suporte a F.scaled_mm. Em modelos MoE, o decoding fica de 5 a 6,5× mais rápido que no 2.14: o Qwen3.6-35B-A3B vai de 9,4 para 61,3 tokens/s num M3 Ultra, graças a grouped matmul nativo, menos sincronizações GPU-CPU e roteamento top-k mais ágil. O LFM2.5-8B-A1B salta de 23,6 para 123,6 tokens/s com torch.compile. O decode do VAE do Wan2.2 cai de 270 GiB para cerca de 8 GiB de pico, e o Qwen-Image-2.1 ganha correção de padding no encoder VAE (PSNR de 10,06 para 29,95 dB). Agora exige macOS 15+ e Python 3.11+. No 2.16, vêm attention totalmente em Metal.
O AI Factory Accelerator Programme do Barcelona Supercomputing Center (BSC) saiu da fase-piloto e já opera a pleno vapor, oferecendo a startups compute soberano, suporte técnico e treinamento. Parte dos serviços agora está no portal do NVIDIA Inception, e uma futura extensão do MareNostrum 5 ampliará o acesso à supercomputação. Primeira AI factory da Espanha, o BSC AI Factory entregou mais de 800 serviços desde abril de 2025. Entre os AI Champions estão a Qatium, com modelos de IA para redes de água treinados no MareNostrum 5; a OneCareAI, que detecta fibrilação atrial oculta em eletrocardiogramas para prevenir AVCs; e a Avatia, com agentes de voz para farmacêuticas, usando NVIDIA NIM, Nemotron 3 e NeMo Curator.
O Eval Agent da Terminal X avalia as respostas dos agentes com uma rubrica de 54 critérios e, com o GPT‑6.1 Sol, detectou cerca de 25% mais desvios em relação ao mandato de um fundo, rodando os mesmos workflows com cerca de 30% menos custo por consulta que o segundo melhor modelo. A startup quer atacar o que chama de memory debt: o raciocínio dos investidores seniores some quando eles saem, mesmo com os documentos guardados. Seu sistema Capital Memory codifica a forma de investir de cada gestora em agentes on-premise ou na nuvem do cliente. O GPT‑6.1 Sol cuida das etapas de julgamento e contexto longo, enquanto o GPT‑6 Luna assume os passos de alto volume. Cada consulta é auditável, e uma firma de private equity relatou US$ 2,4 milhões em economia anualizada.
Ted Taylor, franqueado de Schlotzsky's e Cinnabon no Novo México, vem de 25 anos na indústria de semicondutores e hoje opera três restaurantes co-branded. Ele usa o ChatGPT Work para cruzar dados de preços, vendas, previsões, escalas e mão de obra, e para saber onde cada unidade precisa de atenção. A reprecificação anual dos cardápios caiu de 5 dias para 1 a 2 horas (redução de 95%), e o workflow pode liberar até US$ 100 mil em fluxo de caixa. Com acesso somente leitura aos dados, a ferramenta compara horas escaladas, orçadas e realizadas com as vendas e sinaliza horas extras e lacunas de cobertura. Resultado: 4 horas a menos de trabalho manual por folha de pagamento e conciliação mensal de caixa 94% mais rápida.
O resumo disponível não traz o conteúdo do artigo sobre como três Java Champions usam o GitHub Copilot, apenas chamadas de outros textos do GitHub Blog. Entre elas, como retomar uma sessão do GitHub Copilot app no VS Code sem perder conversa, alterações de código ou contexto, e a visão da ambient intelligence, com IA, agentes, voz e controles físicos. O classificador de segredos com reconhecimento de contexto eleva a weighted acceptance em 11,5% e reduz em 86% o tempo mediano do scan. Há ainda um guia para ensinar o Copilot sobre seu codebase, com custom instructions, skills, custom agents e servidores MCP como o Playwright. O GitHub Universe acontece em 28 e 29 de outubro, em San Francisco e online.
O FairStress é um benchmark que mede a justiça demográfica em LLMs além da escolha final do modelo em decisões que afetam pessoas, como triagem de candidatos, crédito e saúde. Em vez de só trocar identidades demográficas, ele testa o quanto o modelo resiste a argumentos persuasivos (adversarial prefixes). Testes com Olmo, Llama, Qwen, Gemma, Claude e GPT mostraram que a facilidade de mudar de decisão varia conforme o grupo favorecido. São 300 cenários em 29 domínios, e o benchmark já está disponível para download e entrando no Olmo-eval.
O ALTK-Evolve, da IBM Research, mostra que dá para subir de nível sem treinar o modelo. Com o GPT-4.1, antigo e sem raciocínio, um agente básico chega a 67,5% de Pass^4 no τ²-bench retail, acima de todas as entradas do leaderboard de 12 de outubro de 2026. O truque: o próprio modelo analisa tentativas em tarefas de treino e destila sucessos e falhas em regras curtas, como autenticar o cliente ou tratar devoluções. Essas diretrizes entram no system prompt do scaffold ReAct, sem atualizar pesos nem anotação humana. Antes testada em agentes de código, a abordagem agora enfrenta o atendimento, onde seguir políticas e usar ferramentas é essencial.
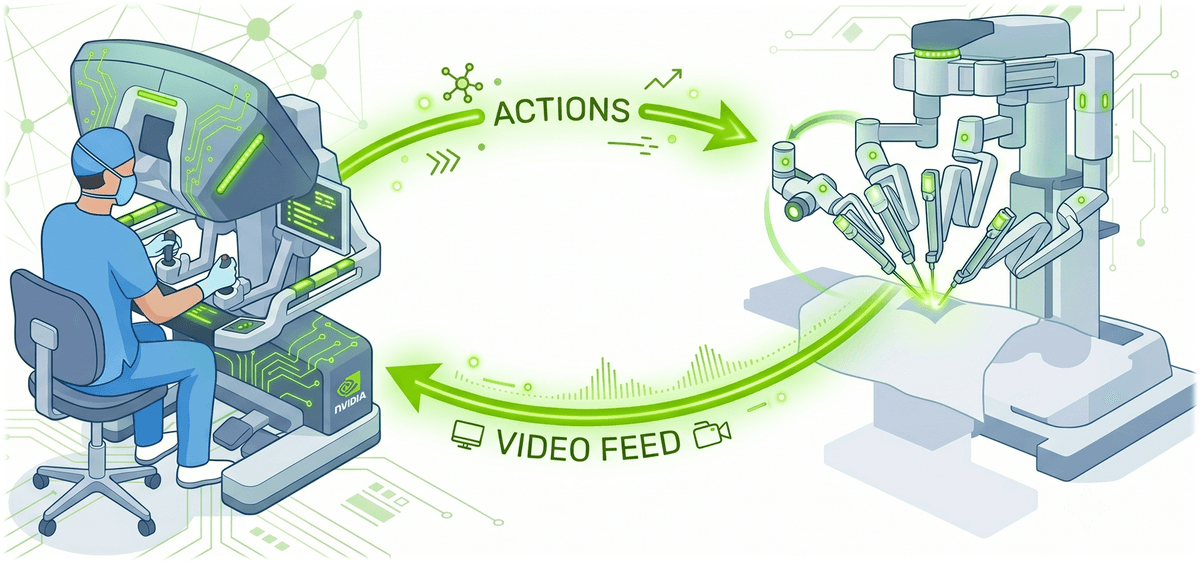
A NVIDIA apresentou o Cosmos3-H-Dreams, simulador cirúrgico generativo que responde em tempo real a comandos como mover o Cadiere grasper e levantar a vesícula biliar. Treinado em vídeo e cinemática de colecistectomias clínicas da plataforma Versius, da CMR Surgical, é, segundo a empresa, o primeiro do tipo com controle cinemático ao vivo. Baseado no Cosmos 3 e acelerado pelo FlashDreams, roda em uma única GPU RTX PRO 6000. O modelo parte do Cosmos3-H-Embodied-Nano (16 bilhões de parâmetros), usa 28 dimensões de ação e vídeo 832 x 480 a 10 Hz, com distillation de teacher para students de quatro e dois passos. A NVIDIA ressalta que realismo visual não prova precisão biomecânica: os comandos precisam gerar consequências anatômicas coerentes.
O Google Cloud liberou o Claude Opus 5.5 (para tarefas complexas) e o Claude Sonnet 5.5 (mais rápido e barato) no Antigravity. Depois de habilitados por um administrador, aparecem no seletor de modelos do Antigravity 2.0, da CLI e das extensões para VS Code, JetBrains IntelliJ e Visual Studio, com faturamento e segurança unificados. Os administradores também podem escolher modelos Gemini, como Gemini 3.8 Flash e Gemini 4 Argon. O post destaca dois padrões: verificação cruzada entre modelos (LLM-as-a-Judge), em que uma família implementa e outra valida o código, evitando pontos cegos; e a combinação de modelos de raciocínio com subagents Flash (.agents/agents/*.md, níveis inherit, flash ou pro), que delegam buscas e triagem de alto volume, reduzindo latência e custo. No Gemini for business, modelos de parceiros não consomem a cota mensal de tokens do Gemini Enterprise Standard e Plus: o uso é cobrado por consumo no Google Cloud Billing, com excedente habilitado.
Na PyTorch Conference 2026, o Google anunciou que o TorchTPU, stack nativo de PyTorch para TPUs, agora é open source no GitHub. Desenvolvido com a Meta, ele torna as TPUs uma opção nativa ao lado de GPUs e CPUs, rodando workloads existentes com mudanças mínimas de código. Dá para depurar em eager mode e migrar para produção via torch.compile. A integração inclui vLLM, SGLang, llm-d, TorchTitan, Ray, TorchRec, Hugging Face e LiteRT. Com a Hugging Face, o deploy no Transformers v5 é só passar device_map="tpu", e o Diffusers roda nativamente com tensor parallelism. Para segurar custo e latência de inference, o Google combina roteamento Kubernetes entre TPUs e GPUs, buscando mais throughput por dólar.
O Google anunciou, em preview, recursos de enterprise search com Gemini no Google Distributed Cloud (GDC) air-gapped, acelerado por NVIDIA Blackwell Ultra. A busca RAG é totalmente gerenciada e roda dentro do perímetro físico de segurança, sem conexão com a internet pública nem com o Google Cloud global. Isso evita meses de montagem de infraestrutura própria para agências e organizações reguladas. As equipes enviam arquivos e pedem ao Gemini que busque, resuma, compare ou traduza, com respostas que citam as fontes. Há suporte multimodal (áudio, vídeo, imagens, planilhas) sem etapas separadas de OCR ou transcrição, além de acesso restrito por grupos do provedor de identidade. Embeddings e vector database em PostgreSQL ficam na rede do cliente.
A IA generativa já é parte essencial da rotina de 243 milhões de pessoas no Sudeste Asiático, segundo a 11ª edição do relatório e-Conomy SEA. A economia digital da região segue em alta e deve chegar a US$ 1 trilhão até 2035, com a IA crescendo quatro vezes mais rápido que a internet móvel e impulsionando os principais setores. Os consumidores já confiam em IA para tarefas complexas, o que aponta para o agentic commerce: agentes que comparam preços e compram por eles. Para sustentar o ritmo, a região precisa expandir data centers, melhorar a eficiência energética e unificar políticas de comércio digital, com apoio de novos acordos comerciais regionais.
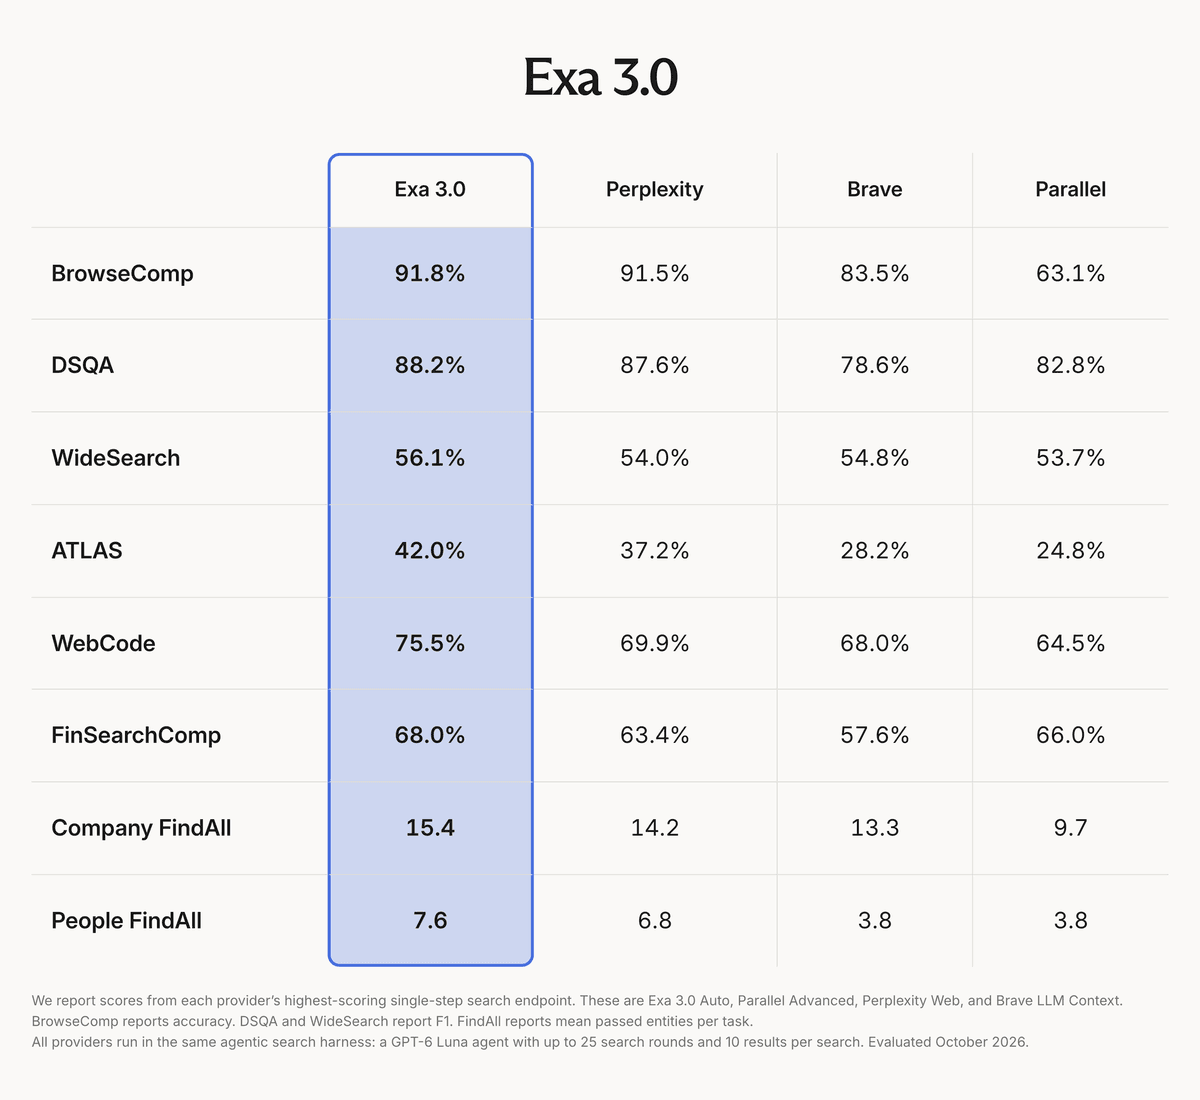
O Exa 3.0 consolida sua liderança em avaliações de IA, com desempenho notável em codificação, finanças, pesquisa e inteligência corporativa. A novidade é o lançamento do Exa Lite, uma opção de busca mais acessível, custando apenas US$ 4 por mil requisições. O diferencial do Exa reside em seu crawler e índice independentes, que monitoram mais de 2 trilhões de URLs e servem 100 bilhões de páginas, expandindo-se dinamicamente. Seu índice robusto integra 1,27 bilhão de listagens de e-commerce com detalhes de preços e disponibilidade, mais de 211 milhões de negócios locais com horários e avaliações, além de notícias em tempo real, esportes, clima, dados de mercado, voos, eventos e podcasts. Uma plataforma poderosa para diversas necessidades de informação.
A Cloudflare acaba de apresentar o Clairic, uma inovadora classe de modelos de extração no estilo System One, desenvolvida para processar dados não estruturados. Diferente dos LLMs tradicionais, o Clairic foca em extrair, calcular, estimar e prever valores sem gerar tokens, eliminando assim problemas como erros de digitação e as temidas alucinações. Embora a precisão não seja 100% garantida, o modelo oferece scores de confiança, permitindo aos usuários avaliar a confiabilidade de cada saída e otimizar suas operações.
A Meta revelou detalhes da engenharia por trás do Prometheus, seu colosso de IA em escala de gigawatts, projetado para impulsionar a família de modelos Muse. A empresa aprofundou-se no design complexo da infraestrutura, ambicionando expandi-la para cerca de um milhão de GPUs. Um dos destaques é a inovadora tecnologia de resfriamento líquido de ciclo fechado, crucial para a performance e sustentabilidade dessa máquina que redefine os limites da computação de IA.
A evolução da IA é cada vez mais moldada por benchmarks que, embora essenciais na avaliação de modelos, podem desviar o foco da inovação se mal formulados. O fenômeno do 'benchmaxxing', onde modelos são otimizados para superar testes específicos em vez de desenvolver capacidades genuinamente úteis, levanta um alerta crucial. Para garantir que os avanços em IA sirvam aos propósitos desejados, a indústria deve reavaliar a construção de seus benchmarks, focando em métricas que reflitam os objetivos reais e a utilidade prática da tecnologia, e não apenas o desempenho em cenários controlados.
O engine vLLM acaba de implementar uma nova metodologia de transferência KV (key-value) baseada em push. O objetivo é claro: reduzir drasticamente o Time To First Token (TTFT) e o Time Per Output Token (TPOT) em ambientes de inferência desagregada. Essa inovação é crucial para otimizar a latência e o throughput em arquiteturas distribuídas, onde o cache KV e o processamento computacional operam de forma independente, um desafio recorrente em deployments de IA em grande escala.
O MiniMax M3.1 Flash surge como um divisor de águas, prometendo revolucionar o desempenho e a eficiência de custos para agentes de IA. Este novo modelo entrega inferência online quase três vezes mais rápida e corta os custos operacionais em impressionantes 70%. Projetado para otimizar tarefas agentic, codificação, uso computacional e cibersegurança, o M3.1 Flash já está disponível via API da MiniMax, Plano M e MiniMax Code, com a liberação dos pesos do modelo prevista para breve.