O JavaScript SDK v11 do Sentry passou a medir LCP, CLS e INP em navegações do lado do cliente, o que expõe rotas lentas que as métricas de carregamento inicial da página não captam. O suporte atualmente exige Chromium 151 ou posterior. Além disso, as pontuações precisam ser filtradas separadamente das de carregamento de página, porque seus relógios começam em pontos diferentes.
O Node.js 26 agora é a versão padrão da Vercel para novos projetos. Projetos já existentes serão atualizados no próximo deployment, desde que o intervalo definido em engines.node permita essa versão.
A Microsoft anunciou o Hardware Audit Logging para o Azure Cloud HSM, recurso que coleta os registros de auditoria gerados pelo próprio HSM para as operações de gerenciamento suportadas. A ideia é atender organizações com workloads regulados e sensíveis, que precisam de evidências confiáveis sobre quais usuários autenticados executaram operações de gerenciamento, quais ações realizaram e quando. Times de segurança, conformidade e operações podem usar essas evidências, originadas no hardware, em monitoramento, relatórios de conformidade e investigações forenses. O recurso captura eventos de autenticação e sessão de usuários, gerenciamento de usuários e administradores, mudanças de política e configuração, e operações de backup e restore. Os clientes têm acesso a registros legíveis, aos dados de auditoria binários assinados pelo HSM, às assinaturas e aos certificados do HSM necessários para verificar de forma independente a autenticidade e a integridade dos lotes de auditoria assinados. O logging é habilitado como uma política imutável da partição do HSM, o que ajuda a manter cobertura consistente e reduz o risco de desativação durante a administração de rotina. A responsabilidade dos clientes continua: configurar o acesso ao ambiente de monitoramento, definir requisitos de retenção, estabelecer processos de alerta e revisão e determinar como a evidência será usada em seu framework de controles. O recurso foi pensado para organizações com requisitos rigorosos de conformidade e segurança, como serviços financeiros e pagamentos.
A versão 27.0.0-alpha.0.0.0 (Alpha) do Node.js, datada de 29/10/2026 e publicada por @RafaelGSS, atualiza o V8 para a 15.6.75.13, ante a 14.6 do Node.js 26. Entre os destaques, estão recursos de linguagem habilitados por padrão: Math.sumPrecise(), Intl.Locale.prototype.variants, Iterator.prototype.join(), Iterator.prototype.includes(), Iterator.zip() e Iterator.zipKeyed(). Há também recursos experimentais atrás de flags: import defer (--js-defer-import-eval), Immutable ArrayBuffer (--js-immutable-arraybuffer) e RegExp buffer boundaries (--js-regexp-buffer-boundaries). Na memória, quando --max-old-space-size não é definido, o limite padrão do heap passa a ser metade da memória física, entre 256 MB e 4 GB, e a memória de instâncias de Buffer e ArrayBuffer agora conta para esse limite. Aplicações que dependiam dos padrões anteriores devem definir --max-old-space-size explicitamente. Na serialização, v8.serialize(), structuredClone() e postMessage() usam um novo formato que versões anteriores do Node.js não conseguem ler. v8.cachedDataVersionTag() e o compile cache também mudam a cada patch do V8 no Node.js, e não só em mudanças de versão do V8. Há mudanças de comportamento observáveis: os métodos de Math passam a usar a libm do LLVM e podem diferir no último bit; as sequências de Math.random() mudam para um mesmo --random-seed; error.stack não é mais buscado pela cadeia de protótipos; await gera menos microtasks; Array.prototype.sort() usa PowerSort em arrays grandes e continua stable. Os heap snapshots passam a incluir objetos internos, valores numéricos e o código-fonte completo dos scripts, levam cerca de duas vezes mais tempo para serem gerados e o arquivo fica cerca de duas vezes maior. Em WebAssembly, asm.js deixa de ser compilado para WebAssembly e as flags --experimental-wasm-<name> foram renomeadas para --wasm-<name>. O changelog completo das mudanças do V8 entre 14.6 e 15.6 será divulgado em breve. A contribuição é de Joyee Cheung (#65161, #66537 e #66601). A lista de commits SEMVER-MAJOR inclui a remoção do build do FIPS provider embutido, a exigência de OpenSSL 3 ou posterior, o rebaixamento do suporte a macOS em Intel para experimental, o fim do suporte a engines do OpenSSL e a atualização do OpenSSL para 4.1.0 e do npm para 12.1.0. Em crypto, há validação de encodings de entrada e saída, DEP0093, DEP0198, DEP0203 e DEP0204 movidos para End-of-Life, rejeição de resizable backing stores em parâmetros de buffer do Web Crypto, erro em computeSecret de DH não inicializado e descontinuação em runtime de chamar Hmac.digest() mais de uma vez. Em dgram, o lookup customizado é ignorado para endereços IP literais e, em dns, o arquivo hosts não é mais consultado em reverse lookups.
O Strix, ferramenta open-source de teste de intrusão com IA, agora pode rodar em qualquer um dos mais de 400 modelos disponíveis no Vercel AI Gateway. Com isso, a ferramenta acessa modelos de Anthropic, OpenAI, Kimi, GLM, Deepseek e outros por meio de uma única API, sem markup e sem a necessidade de criar conta em vários provedores. O uso e o custo de todos os modelos são acompanhados no AI Gateway. O Strix seleciona o Gateway pela variável STRIX_LLM, em que o modelo é o ID padrão do AI Gateway no formato <provider>/<model>, precedido pelo prefixo vercel_ai_gateway/. Para configurar, consulte o guia de configuração do AI Gateway na documentação do Strix.
O Vercel Connect agora oferece suporte a webhook triggers para Resend, X, Twilio, Notion e Telegram. O Connect recebe eventos de webhook, como mensagens de bots do Telegram ou e-mails recebidos no domínio do Resend, e os encaminha para um endpoint no seu projeto da Vercel. Ele também verifica as requisições recebidas e cuida dos heartbeats e dos verification challenges dos provedores. Para ativar, abra o Vercel Connect no dashboard e habilite os triggers ao criar um conector para o provedor ou nas configurações de um conector existente. O Connect registra os webhooks automaticamente para Resend e Telegram. No caso de Twilio, Notion e X, é preciso usar a URL de webhook fornecida pelo Connect e seguir as instruções para concluir a configuração nas configurações do provedor. Depois, basta adicionar um trigger destination para escolher o projeto e o endpoint que devem receber os eventos. Os triggers podem ser ativados ou desativados depois, nas configurações do conector, e a aba Observability permite acompanhar os eventos recebidos em tempo real com a opção Live. Os novos conectores se somam ao suporte a triggers que já existia para Slack, Discord, Microsoft Teams, GitHub e Linear.
As equipes de Data Analytics, BI e Database do Google Cloud reuniram as atualizações recentes de produtos. Em 4 de novembro, está previsto o evento Agentic Data Cloud, voltado a líderes de produto e à arquitetura de soluções agentic. Entre 19 e 23 de outubro: o GoogleSQL no BigQuery passou a oferecer suporte a column aliases em cláusulas SELECT e WHERE (GA opt-in), o que evita subqueries aninhadas e simplifica migrações do Snowflake e do Teradata. A cópia de tabelas entre regiões também chegou a general availability, facilitando a replicação regional de dados e a recuperação de desastres. O conversational analytics no BigQuery agora está disponível em Montréal (northamerica-northeast1) e Toronto (northamerica-northeast2), atendendo a requisitos canadenses de residência de dados, e permite exportar respostas do agente (texto, tabelas, gráficos e citações) para CSV ou PDF (GA). O AlloyDB Omni 18.4.0 está em GA e traz o PostgreSQL 18.4 para ambientes self-hosted e multicloud, com a extensão google_insights_v2 para diagnóstico granular da execução de queries e wait events, além de suporte ao Thales CipherTrust Manager para Transparent Data Encryption (TDE), junto com o HashiCorp Vault. No Cloud SQL for PostgreSQL, agora é possível ativar o managed connection pooling em instâncias existentes com Private Service Connect (PSC) para escalar workloads de alta concorrência, e o PSC passou a ser a opção padrão de IP privado em novas instâncias de projetos novos. Em estudo de caso, a plataforma de identidade digital Unico migrou clusters Spark/Scala do Databricks para BigQuery e Spanner, unificando streams de transações em tempo real com analytics em escala de petabytes; a verificação de identidade de baixa latência já evitou mais de US$ 5 bilhões em fraudes. Há ainda um guia para desenvolvedores sobre os Looker Data Apps, com padrões práticos para criar aplicações orientadas por prompt dentro do Looker. Entre 12 e 16 de outubro: os Looker Data Apps entraram em Preview para criar e hospedar, nativamente no Looker, aplicações interativas geradas por agentes a partir de prompts em linguagem natural, do Antigravity CLI ou do Claude Code. Elas permitem testar cenários, ajustar parâmetros e disparar workflows em plataformas downstream, herdando a modelagem semântica LookML, a row-level security e os controles de acesso, sem custo de tokens de LLM em runtime. Também foi publicado um walkthrough de ponta a ponta que mostra como criar, testar e agendar pipelines de machine learning direto do editor de código preferido com o Data Agent Kit, que já está em general availability. Por fim, equipes de dados agora podem gerenciar agentes de dashboard como código, declarando parâmetros, configurações e instruções de prompt junto aos arquivos do dashboard, com Git, revisão por pares, branching e validação automatizada de CI/CD antes que as alterações cheguem aos usuários finais.
Na Vercel, o Vercel Flags SDK agora inicializa mais rápido em cold starts, e o reporte de uso não mantém mais as funções em execução depois da resposta. Duas mudanças aceleram a inicialização: o SDK carrega e faz o parse do datafile de flags incluído no deployment assim que o client é criado, ficando pronto antes de o código avaliar a primeira flag; e cada invocação de função agora inclui a revisão atual do datafile, o que permite ao SDK verificar se o datafile embutido está atualizado sem fazer uma requisição de rede. Em testes internos, eliminar a espera pela rede reduziu o tempo de inicialização do SDK em cold start no p75 de mais de 70 ms para 10 ms, cerca de 7x mais rápido. Depois de inicializado, as leituras de flags são praticamente instantâneas: entre invocações cold e warm, a latency de leitura no p99 fica abaixo de 1 ms. Antes, o SDK usava waitUntil para o reporte de uso, mantendo as funções em execução após o envio da resposta. Agora, ele repassa os eventos de uso ao runtime da Vercel, e o reporte deixa de somar à duração da função. Para aproveitar, atualize o @flags-sdk/vercel para a versão 1.5.3 ou superior e faça o redeploy da aplicação.
Já é possível registrar em log ou bloquear, de forma separada, requisições de crawlers de IA e de assistentes de IA com o ruleset gerenciado AI Bots do Vercel Firewall. Crawlers de IA são bots que coletam conteúdo para indexação e treinamento de modelos. Já os assistentes de IA buscam páginas em resposta a ações do usuário ou a consultas de busca. Na prática, dá para bloquear os crawlers de IA e, ao mesmo tempo, permitir que os assistentes acessem seu conteúdo para responder às perguntas dos usuários. A Vercel atualiza as regras conforme novos bots são adicionados. Pelo painel, abra Security > Firewall > Rules no projeto. Em Bot Management, ative AI Bots e clique no ícone de engrenagem ao lado. Defina uma ação para crawlers de IA e outra para assistentes de IA, depois revise e publique as alterações. Também dá para fazer isso pela Vercel CLI: configure o ruleset AI Bots para bloquear crawlers de IA e permitir assistentes de IA, revise as mudanças com vercel firewall diff e aplique-as com vercel firewall publish. O ruleset gerenciado AI Bots está disponível em todos os planos.
A geolocalização por IP na Vercel agora resolve a localização dos visitantes com granularidade de rede mais fina: há dados em nível de cidade para quase todas as requisições e dados de código postal para 90% do tráfego. Os dados também são atualizados com mais frequência, de modo que as localizações acompanham a reatribuição de faixas de IP e as mudanças de roteamento. O recurso já está habilitado para todos os projetos, sem necessidade de alterar código ou configuração. Os headers de geolocalização existentes e o helper geolocation() do @vercel/functions retornam os mesmos campos para Vercel Functions e Routing Middleware. Quem usa geolocalização para controle de acesso, localização ou compliance deve ficar atento: alguns visitantes agora serão resolvidos para uma cidade ou país diferente, principalmente o tráfego de VPNs, provedores de hospedagem e faixas de IP alugadas. Subnets anunciadas por um provedor de hospedagem em um país diferente do registrado no regional internet registry (RIR) passam a ser resolvidas para o data center onde o tráfego realmente termina. Para testar rotas que dependem de geolocalização, verifique as regras de acesso com base na localização ativa de rede do IP, e não na alocação estática do registro. A documentação de request headers lista todos os headers e campos de geolocalização disponíveis.
À medida que os modelos ficam mais inteligentes e executam ações de maior consequência no mundo, não basta interpretar instruções específicas: eles também precisam compreender intenções e valores humanos para exercer bom julgamento onde as instruções não chegam, sem abrir mão da fidelidade à intenção e à supervisão humanas. A OpenAI atualizou o Model Spec, sua descrição pública de como quer que os modelos se comportem. A revisão reorganiza as diretrizes em cinco valores: fidelidade à intenção humana, minimização de danos, honestidade e transparência, autonomia humana (human agency) e cuidado. A mudança reflete o objetivo do trabalho de value alignment: que os modelos entendam e apliquem valores humanos em situações desconhecidas, sem perder a fidelidade à intenção humana. Além de explicar melhor princípios existentes, a atualização traz orientações sobre contexto, supervisão e agency, ajusta alguns comportamentos padrão e aposenta grande parte das diretrizes detalhadas de estilo. Segundo a empresa, a fidelidade à intenção humana é a base da abordagem: a OpenAI escreve o Spec, define limites e treina os modelos para respeitá-los; desenvolvedores direcionam as aplicações dentro desses limites; e usuários direcionam o trabalho do modelo sujeito a essas restrições. Fidelidade vai além de seguir instruções literalmente: é entender o que OpenAI, desenvolvedores e usuários pretendem e valorizam, e agir com sabedoria quando esse entendimento é incompleto. Também implica reconhecer que crenças e valores das pessoas mudam, ajudando-as a refletir e evoluir sem direcioná-las silenciosamente nem anular suas escolhas. Ao ajudar alguém a comparar ofertas de emprego, por exemplo, o modelo pode usar prioridades já compartilhadas, como horários previsíveis, deixando essas premissas visíveis e fáceis de corrigir. Os outros quatro valores explicitam considerações de longo prazo e efeitos sobre terceiros: minimizar danos é respeitar limites firmes de safety e considerar as consequências previsíveis das ações do modelo; honestidade e transparência é ser verdadeiro sobre o que o modelo sabe, faz e sobre o que é incerto; facilitar a human agency é fortalecer a capacidade das pessoas de entender, escolher e agir por conta própria; e cuidado é atentar às circunstâncias dos afetados.
O Mistral Large 4, da Mistral, agora roda com pesos atualizados no AI Gateway, com preços menores para tokens de entrada, entrada em cache e saída. Segundo o anúncio de release da Mistral, os novos pesos melhoram a codificação com agentes (agentic coding) e a cibersegurança defensiva, com maior eficiência de tokens em tarefas de código. O release também aprimora a criação e edição de planilhas, a pesquisa na web e a resistência a prompt injection. Quem já usa mistral/mistral-large-4 via AI Gateway não precisa trocar de modelo: o mesmo ID já aponta para a versão com os novos pesos e preços. Para usar o modelo em fx, Pi, Claude Code, Codex, Cursor ou outros harnesses, é preciso instalar a Vercel CLI mais recente, executar o setup e selecionar mistral/mistral-large-4 no agente. Também é possível testá-lo no model playground. O AI Gateway oferece uma API unificada para chamar modelos, acompanhar uso e custo e configurar retries, failover e otimizações de desempenho para uptime superior ao dos provedores. Inclui relatórios personalizados, suporte a Zero Data Retention, orçamentos por chave de API e regras de roteamento. Os preços refletem os dos provedores, sem markup e sem taxa de plataforma sobre inference, inclusive em requisições com Bring Your Own Key (BYOK).
O Google Cloud anunciou a disponibilidade geral (GA) do suporte ampliado a modelos semânticos no Knowledge Catalog. O ponto de partida é um problema comum: um agente de IA responde sobre a receita líquida dos principais clientes corporativos, mas os números não batem com o relatório financeiro, porque ele contou pedidos cancelados como receita e usou uma tabela de staging não validada. Segundo o texto, a falha não está no modelo, e sim na falta de compreensão do negócio: as definições costumam existir em modelos semânticos de Looker, dbt, Snowflake, Databricks ou SAP, mas ficam isoladas em cada ferramenta. O Knowledge Catalog passa a ingerir nativamente modelos semânticos e definições de métricas de Looker LookML, BigQuery Graph (incluindo BigQuery measures), dbt MetricFlow, Snowflake Semantic Views, Databricks Metric Views e SAP Core Schema Notation (CSN). Esses elementos são conectados a schema, lineage, data profiles, glossário de negócios e outros metadados em um único context graph, sem mover dados nem reescrever a lógica de negócio em outra linguagem. Se duas ferramentas definem a mesma métrica de formas diferentes, as duas definições aparecem com sua procedência, para que data stewards resolvam o conflito antes de chegar aos usuários finais. Segundo benchmarks internos, agentes com grounding no Knowledge Catalog ficam quase 4X mais precisos, com até 33% menos latência e até 75% menos tokens. O Knowledge Catalog fornece grounding para o Gemini agent, o BigQuery Conversational Analytics e agentes customizados, usando métricas, filtros e join paths já definidos. Com apoio do Gemini, o self-learning enrichment extrai contexto de fontes não estruturadas, como playbooks operacionais, notas de reunião, threads de chat e código, para encontrar contexto ausente ou desatualizado e transformá-lo em context sets governados e reutilizáveis. Ele também conecta as definições semânticas a scores de qualidade de dados, sinais de freshness e lineage, para que o agente saiba no que pode confiar antes de escrever SQL. O context graph é um mapa conectado do patrimônio de dados e da semântica: tabelas, modelos semânticos, termos de glossário e data products são os nós; lineage, associações, chaves de schema, joins extraídos do histórico real de consultas e join paths declarados nos modelos semânticos são as arestas.
O Google Cloud Vulnerability Reward Program (VRP) ampliou sua faixa máxima com a nova recompensa Root-in-Cloud, de US$ 250.000, voltada a pesquisas arquiteturais de alto impacto. Segundo Chris Betz, CISO do Google Cloud, a pesquisa automatizada dificultou a verificação de vulnerabilidades autênticas, e o programa precisa incentivar pesquisas conduzidas por humanos, que vão além da descoberta apenas automatizada. Encontrar bypasses de isolamento entre tenants e falhas complexas de lógica entre serviços exige criatividade, intuição e análise rigorosa de sistemas, combinadas ao poder de sistemas agentic. Para receber o valor, o pesquisador deve demonstrar controle administrativo total, equivalente a "roles/owner" ou controle completo de IAM, sobre organizações ou projetos arbitrários do Google Cloud, sem acesso prévio nem configuração especial do projeto. O caminho de exploração não pode depender de acesso ou foothold preexistente no projeto da vítima, de credenciais vazadas, obtidas por phishing ou roubadas, nem de interação do usuário ou engenharia social. O Google definiu critérios técnicos para validar o acesso root-in-cloud de forma segura e reproduzível, sem afetar ambientes de produção. Relatos válidos de RCE na infraestrutura de produção do Google (Borg) ou de root-in-prod serão avaliados automaticamente pelo painel do Google Cloud VRP para elegibilidade à nova faixa. Ao obter qualquer execução no Borg, o pesquisador deve interromper os testes imediatamente: escalonamento, extração de credenciais de produção e movimentação lateral não são permitidos e levam à desqualificação. O painel analisará o ponto de entrada inicial, o contexto de execução e a superfície de ataque para determinar se o controle total é possível e definir a recompensa. A newsletter traz ainda uma conversa entre Betz e Michael Cote, líder do programa, realizada durante o Escal8, em Singapura.
O Mistral Large 4, também chamado de Le Chonk, é um modelo multimodal, multilíngue e Mixture-of-Experts (MoE) da Mistral. Recebe texto e imagens como entrada e gera texto. São cerca de 1T de parâmetros no total, 49B ativos e janela de contexto de 1M de tokens. O modelo foi lançado em duas variantes oficiais, e há também GGUFs criados pela Unsloth e pela equipe do llama.cpp. A licença é a Mistral Ecosystem Open-Weight License, derivada da MIT, com limitações para ofertas de model-as-a-service. Segundo o post, ele é especialmente forte em cibersegurança, agentes de código e multimodalidade. A arquitetura combina um grande conjunto de experts com sparse attention e um encoder de visão Pixtral. O modelo seleciona um pequeno grupo de experts por token, enquanto o attention indexer escolhe quais posições anteriores serão consideradas: são duas formas distintas de sparsity, uma sobre redes feed-forward e outra sobre posições de contexto. O decoder de texto tem 72 camadas, dimensão oculta de 6.144 e 64 attention heads, e combina Multi-head Latent Attention (MLA) com um indexer DeepSeek Sparse Attention (DSA). A MLA mantém uma representação compactada de KV, e o DSA seleciona até 2.048 posições de chave por query. Cada bloco de decoder segue um padrão 3:1 de RoPE para NoPE, o estado de KV é compartilhado entre camadas e a primeira camada usa uma rede feed-forward densa. No Artificial Analysis Cyber Index, teste em que o modelo precisa reproduzir uma vulnerabilidade real em software open source e depois corrigi-la, o Mistral Large 4 marca 82%. A Mistral relata que vários frontier models fechados ficam próximos de zero no mesmo teste porque se recusam a tentar a tarefa. Em testes internos da empresa, o modelo também foi útil em análise de malware, priorização de vulnerabilidades e escrita de regras de detecção, tarefas para as quais não foi treinado explicitamente. Em prompts de cibersegurança do JailbreakBench, StrongREJECT e AgentHarm, a taxa média de recusa é maior que a de qualquer outro modelo open-weight. O post aponta que, por ser open-weight, o modelo deixa a política de uso e o deployment sob controle do usuário. Isso permite, por exemplo, fazer fine-tuning de modelos menores com TRL a partir de traces de correção de código, além de usar as tarefas de reproduzir e corrigir como ambientes de RL com recompensa verificável.
Na semana do Halloween, a GFN Thursday traz novos jogos ao GeForce NOW. Phantom Blade Zero, da S-GAME, chega hoje ao serviço, misturando artes marciais e fantasia punk na nuvem. O jogo usa Unreal Engine 5 e acompanha Soul, um guerreiro acusado de assassinar seu mestre que tem 66 dias para descobrir uma conspiração. O combate reúne mais de 30 armas primárias e mais de 20 Phantom Edges, em um mundo que combina artes marciais chinesas tradicionais, próteses mecânicas, ruínas industriais e rock. Membros Ultimate têm desempenho equivalente ao de uma GeForce RTX 5080 na nuvem, em PCs, Macs, handhelds, dispositivos móveis, navegadores e TVs compatíveis. World of Warcraft: Forever, da Blizzard Entertainment, está previsto para chegar ao GeForce NOW na quarta-feira, 4 de novembro, às 15h (horário do Pacífico). Uma recompensa de acesso na semana de lançamento ficará disponível até 11 de novembro, às 23h59 (PT), para membros elegíveis que sejam novos usuários de WoW sem assinatura, enquanto durarem os estoques. Também chega o suporte a mods via Mod.io diretamente no jogo para Cyberpunk 2077 e The Witcher 3: Wild Hunt – Remastered. Na Índia, a opção de planos Performance e Ultimate de quatro meses será lançada amanhã. A biblioteca recebe ainda ATMOSFAR, Hunting Simulator 3, Queen's Domain, Halloween, Hell Let Loose: Vietnam e The Seance of Blake Manor.
Pouco mais de uma semana após lançar o Granite Switch 4.1, a IBM publicou o Granite Switch 4.1.1. A arquitetura modular Switch permite configurar um modelo de linguagem com adapters especializados e eficientes em cache, adicionando novas especialidades em um único endpoint. A 4.1.1 é um patch release e, como no software, é totalmente retrocompatível com a 4.1, sem migração, com melhorias incrementais por baixo dos panos. Entre as novidades estão o modelo Granite Speech ASR atualizado, que faz speech-to-text multilíngue em 10 idiomas, com pontuação e capitalização nativas, deixando as transcrições prontas para modelos downstream, sem etapa de formatação; e o adapter Decision atualizado no granitelib-core, com desempenho geral melhor no conjunto de teste Jev Decision Index. Segundo o texto, o destaque é a rapidez e a eficiência do lançamento. Além de treinar o novo modelo de ASR e o adapter Decision, nada foi recomputado: o modelo base permanece intocado. Basta compor os adapters mais recentes e fazer o deploy. A IBM afirma que o padrão pode servir a muito mais do que patch releases de um modelo próprio. A equipe trabalha em tutoriais e em um Adapter SDK para que desenvolvedores e provedores terceiros criem adapters, iterem versões, testem recursos e publiquem atualizações como fazem com software. Mais informações devem vir em breve. Enquanto isso, é possível testar os modelos mais recentes e os novos recursos multilíngues e de pontuação no demo Speech-to-Decisions.
A Ramp está abrindo early access para o Inspect, um agente de código baseado em nuvem. Ele converte solicitações feitas no Slack, GitHub, Linear ou na web em pull requests revisados e validados visualmente, dentro do ambiente de desenvolvimento da própria empresa. Segundo a Ramp, o Inspect já responde por 74% dos PRs mesclados e ajudou os builders a entregar 3,4 vezes mais PRs por pessoa do que um ano atrás. A empresa afirma que o gargalo está saindo da escrita de código e se deslocando para a decisão sobre quais ideias vale a pena lançar.
O Google apresentou o Gemini 4 Carbon, modelo que amplia as capacidades de IA com maior eficiência energética. Segundo o texto, ele melhora o desempenho em tarefas de processamento de linguagem natural e reduz a pegada de carbono, em resposta às preocupações com sustentabilidade no desenvolvimento de IA. O Google afirma que o Gemini 4 Carbon busca estabelecer novos padrões do setor para modelos de IA ecologicamente sustentáveis.
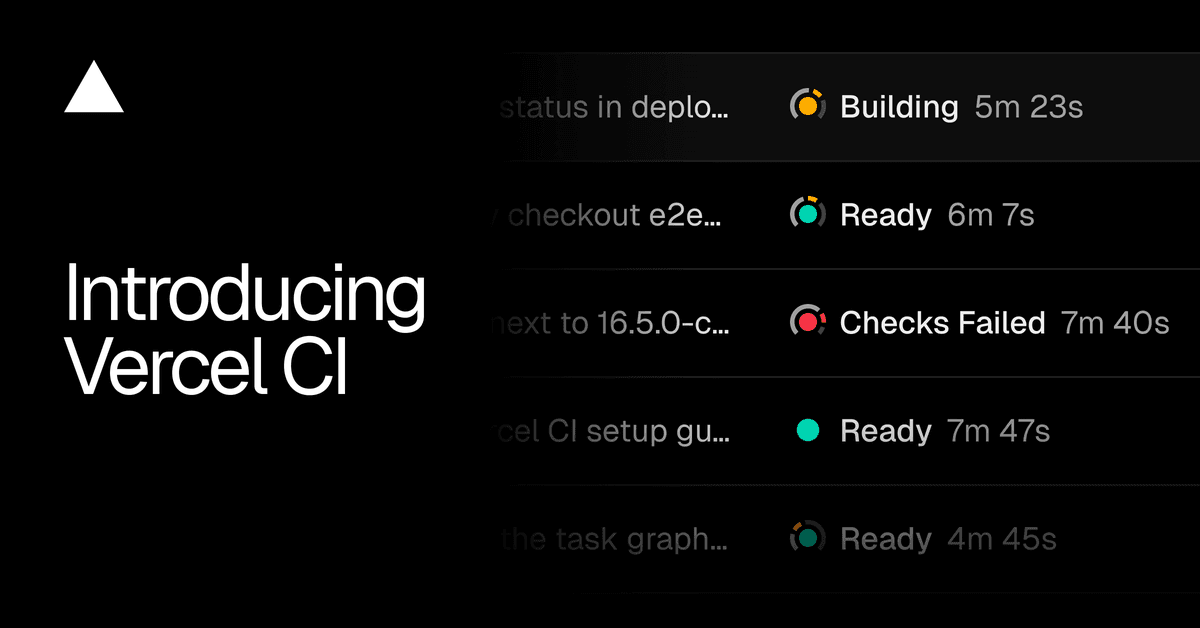
O Vercel AI está disponível em beta, conforme o resumo original. O CI foi pensado para acompanhar o ritmo dos coding agents: executa apenas as tarefas afetadas por uma mudança de código e provisiona somente o compute que essas verificações exigem. Na própria Vercel, o sistema reduziu em 2 a 6 vezes o tempo entre o git push e o 'CI pass'.