A PlanetScale demonstrou um marco impressionante ao escalar seu novo sistema Postgres sharded, Neki, de 1 milhão para 118 milhões de queries por segundo. Inicialmente, o objetivo de 1 milhão de queries foi atingido em apenas 5 shards. Posteriormente, a arquitetura foi expandida para 512 shards, processando a impressionante marca de 118 milhões de queries por segundo em um volume de 1.22 PiB de dados. A carga de trabalho, configurada para seleções de ponto em um único shard sem escritas ou joins complexos, validou uma curva de escalabilidade linear e robusta para cenários de alta leitura.
Mesmo após aprovação em CI e avaliações, agentes de IA podem falhar ao fornecer respostas corretas, por recuperarem contextos inválidos ou seguirem rotas de execução defeituosas. Para garantir a confiabilidade, a depuração com rastreamentos de ponta a ponta é fundamental. Isso inclui monitorar chamadas de modelo e de ferramentas, além das entradas e saídas de retrieval, complementado por testes rigorosos para assegurar um comportamento determinístico e a qualidade final das respostas geradas pela IA.
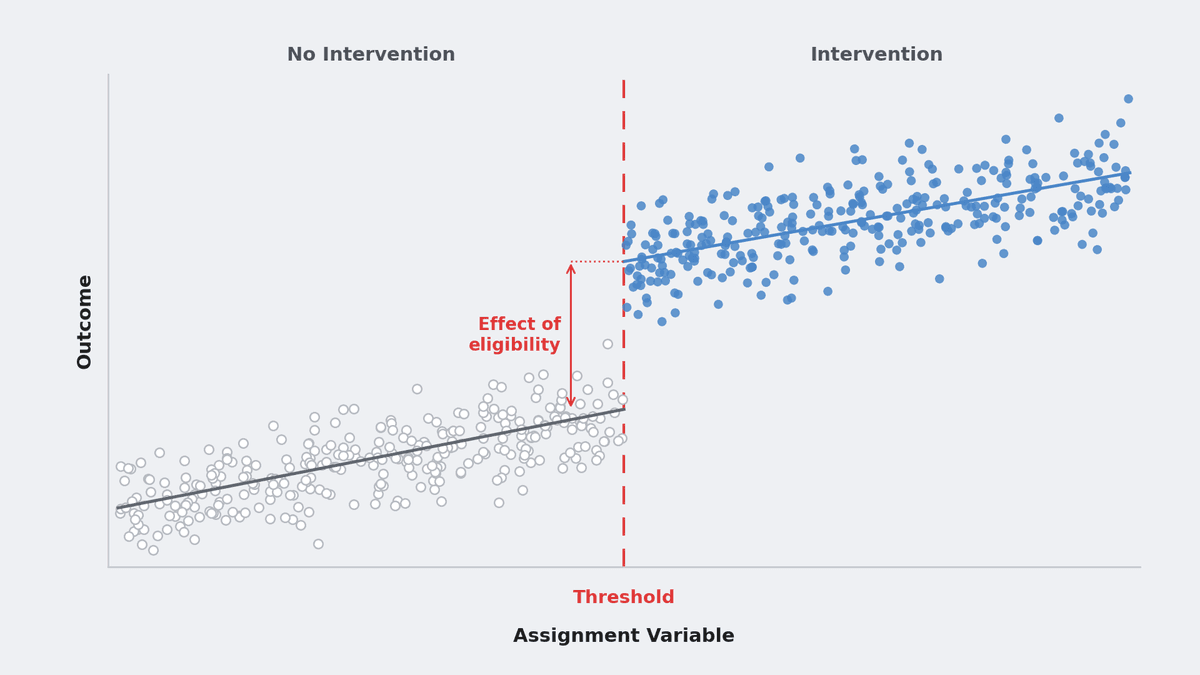
Muitas análises sobre o impacto da adoção de IA podem superestimar seus benefícios ao comparar empresas que a utilizam com aquelas que não a utilizam. Isso ocorre porque clientes e empresas mais engajados tendem a ser os primeiros a adotar novas tecnologias. Para uma estimativa mais precisa da causalidade, é fundamental focar em variações na adoção que não sejam resultado de escolhas dos clientes, como critérios de elegibilidade predefinidos. As conclusões devem ser restritas à população e à decisão específica que estão sendo mensuradas, garantindo uma avaliação mais robusta e menos enviesada do verdadeiro valor da IA.
O ChatGPT Work acaba de apresentar um agente de dados inovador, projetado para capacitar colaboradores a interagir e explorar dados corporativos aprovados, bem como definições de negócio, utilizando apenas linguagem natural. A ferramenta permite a criação de painéis compartilháveis, integrando-se nativamente a plataformas de dados e ferramentas de BI já existentes. Além disso, garante a aderência às permissões de acesso e pode recomendar ou executar ações de acompanhamento previamente autorizadas, prometendo otimizar a inteligência analítica nas empresas.
O DuckDB 2.0 chega com melhorias notáveis para o ecossistema de dados, impulsionando o desempenho de consultas S3 em 2 a 3 vezes, graças à implementação de I/O assíncrono. A nova versão otimiza significativamente consultas recursivas profundas e aprimora o manuseio de dados semi-estruturados, tornando o tipo VARIANT mais compacto e veloz que JSON. Além disso, a atualização incorpora recursos SQL práticos, como triggers, schemas aninhados e Common Table Expressions (CTEs) com capacidade de modificação de dados, fortalecendo a ferramenta para análises e engenharia de dados.
Ferramentas de IA para codificação têm facilitado a criação de schemas para PostgreSQL, mas com uma inclinação a adicionar índices em tabelas de alto tráfego. Uma análise detalhada de workloads de tickets de suporte revelou que índices adicionais podem quase dobrar o tempo de atualização e o volume de WAL (Write-Ahead Log), além de sobrecarregar o processo de VACUUM. A otimização de índices deve ir além da análise de planos de leitura, considerando as evidências do "write-path", a relevância de HOT-updates e os contadores de uso para garantir a performance ideal.
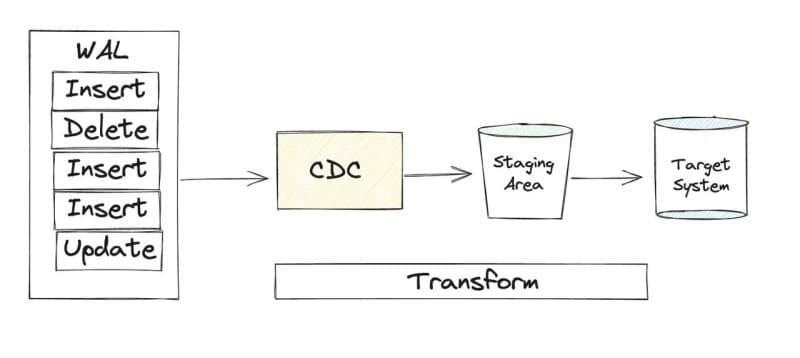
Realizar backfills volumosos de Change Data Capture (CDC) no PostgreSQL em ambientes de produção é um desafio complexo, que vai além da simples leitura de dados históricos. As falhas geralmente decorrem de gargalos como retenção de WAL, confirmações de slot tardias, transações de longa duração e snapshots obsoletos, que disputam recursos com as operações em tempo real. Para mitigar esses riscos, projetos robustos adotam estratégias como o consumo em blocos do WAL, checkpointing progressivo, reconciliação de dados via watermarks e fences, e o ajuste dinâmico do tamanho dos blocos de acordo com a taxa de escrita.
A plataforma de orquestração open-source Kestra acaba de lançar sua versão 2.0 LTS, trazendo inovações significativas para a execução de fluxos de trabalho. A grande novidade é a separação dos planos de controle e dados, que permite que os *workers* operem em ambientes heterogêneos, como diferentes regiões de nuvem ou redes privadas, utilizando apenas conexões de saída. Esta atualização também possibilita a exposição de fluxos como ferramentas MCP para agentes de IA, além de desvincular as escolhas de fila e armazenamento, oferecendo maior flexibilidade. Para usuários da versão 1.x, ferramentas de migração estão inclusas, facilitando a transição para esta nova arquitetura robusta.
A recente atualização para a versão 0.16 do JupyterGIS traz inovações significativas para a análise geoespacial, introduzindo mapas colaborativos em tempo real que otimizam a interação entre equipes. Destaca-se a renderização preguiçosa (lazy tile rendering) para fluxos de trabalho remotos via openEO, permitindo o processamento eficiente de grandes volumes de dados geoespaciais sem a necessidade de download local. Além disso, a nova versão oferece suporte nativo a formatos como GeoZarr e GeoPackage, e a simbologia declarativa, aliada ao tiling Xarray, assegura a reprodutibilidade e escalabilidade das visualizações.
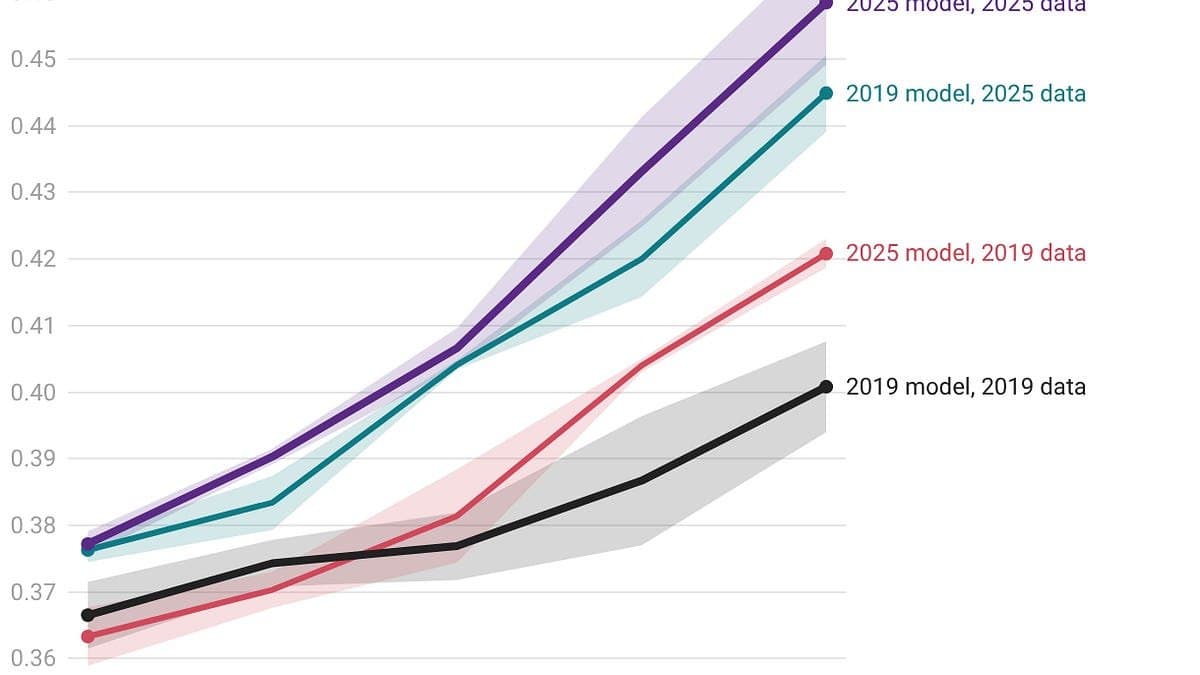
Um estudo comparativo entre 2019 e 2025, analisando modelos abertos e suas bases de dados, revela que a maior parte da eficiência computacional em pré-treinamento de IA (ganhos de 12x) decorre de melhorias na qualidade dos dados. Avanços nas arquiteturas dos modelos contribuíram com apenas 3,7x, considerando um orçamento de 1e19 FLOPs. Isso sublinha a importância crítica da extração, curadoria e filtragem de datasets como um fator sistêmico, embora os impactos de dados em larga escala e dados sintéticos ainda demandem mais investigação.
Tom Lane, figura central no desenvolvimento do PostgreSQL há 25 anos, compartilha os pilares arquitetônicos que garantiram a longevidade do banco de dados. Ele destaca a escolha inicial do modelo de processo por conexão, que simplificou o código, a introdução do write-ahead logging na versão 8.0, crucial para a robustez do sistema, e a implementação do MVCC, que otimizou a manutenção via vacuum em segundo plano. Lane atribui a resiliência do projeto à licença Berkeley e, criticamente, aponta a versão 13 como a mais problemática, expressando o desejo de remover o recurso de particionamento, caso fosse possível.
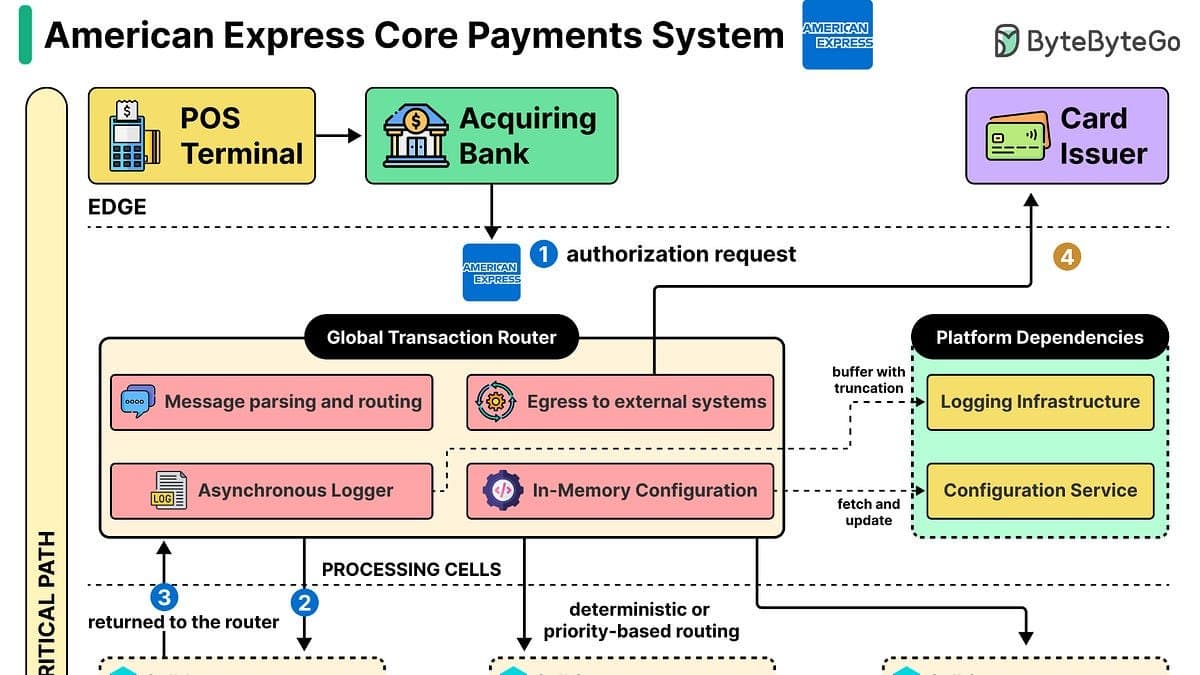
A American Express adota uma arquitetura de processamento de pagamentos baseada em células, onde cada célula funciona como um domínio de falha isolado. Este modelo distribui microsserviços, bancos de dados, DNS e dados de referência em células independentes. Transações dinâmicas são direcionadas à célula que detém o estado relevante, priorizando a contenção de falhas em vez da coordenação global. A estratégia é recusar transações quando a consistência não pode ser assegurada, garantindo assim a resiliência do sistema em grande escala.
A Query 15 do benchmark TPC-H é o foco de uma análise detalhada sobre a otimização de consultas em sistemas de banco de dados. O artigo explora como a repetição de referências a uma Common Table Expression (CTE) dentro da mesma consulta se torna um teste crucial para os otimizadores. A forma como esses sistemas lidam com a materialização do resultado da CTE, seja executando-a múltiplas vezes ou armazenando-a temporariamente, tem um impacto direto e significativo na performance da execução da consulta.
Em sistemas distribuídos, a sincronização não intencional de eventos, como deploys, esvaziamento de cache ou perda de conectividade, pode transformar cargas de trabalho independentes em picos de demanda. A implementação de jitter em novas tentativas, atualizações de TTL, heartbeats, renovações de token e tarefas agendadas é fundamental. Essa técnica simples estabiliza a carga média do sistema, evitando que "tempestades de retries" atinjam uma dependência em recuperação de forma sincronizada, o que pode sobrecarregá-la novamente e prolongar a instabilidade.
O Spotify, uma das maiores plataformas de streaming do mundo, revelou seus motivos para não integrar amplamente os testes A/B Bayesianos em sua metodologia de experimentação. A empresa destaca que a experimentação Bayesiana não é uma abordagem monolítica, mas um processo que envolve escolhas cruciais como a definição de priors, a função de likelihood e a regra de parada. Segundo o Spotify, a utilização de limites posteriores comuns com priors não informativos pode levar a problemas como o "peeking" frequencista, enquanto fatores de Bayes podem efetivamente mitigar falsos positivos em cenários de interrupção opcional. A principal conclusão é a necessidade de priorizar a definição das garantias do programa de experimentos antes de escolher a configuração de inferência.
A ascensão da IA tem levado à proliferação incontrolável de código analítico gerado por colaboradores não técnicos. O problema central reside na dispersão desses artefatos de dados: contextos inconsistentes, permissões desalinhadas e resultados pulverizados em plataformas como Slack e dispositivos pessoais. A ausência de metadados cruciais, como as tabelas acessadas ou os filtros aplicados por um agente de IA, impede a validação e governança, resultando em dados conflitantes e gerando mais confusão do que clareza nas decisões.
Um experimento com o Cloudfloe, interface web para consulta de dados Iceberg no S3 usando DuckDB, explorou a viabilidade de células serverless stateful substituírem contêineres por consulta. Embora o DuckDB WebAssembly tenha lido uma tabela Iceberg de 37.537 linhas em ágeis 148 ms, a latência de células frias ou despertadas variou entre 250 e 320 ms, com alta retenção de memória. No entanto, a manutenção de uma conexão aquecida reduziu drasticamente as consultas repetidas para aproximadamente 3 ms, apontando a política de ciclo de vida como o principal fator de design a ser otimizado, em vez do tempo de startup inicial.
Ao avaliar ferramentas de Change Data Capture (CDC), a robustez em falhas é mais crítica do que a mera quantidade de conectores disponíveis. Engenheiros e arquitetos de dados devem focar em aspectos como métodos de captura, snapshots iniciais, estratégias de backfill, evolução de schema, semântica de entrega, observabilidade, modelo de deployment e a responsabilidade pela recuperação de desastres. Testes de prova de produção são indispensáveis, utilizando dados representativos e simulando destinos corrompidos para verificar a fidelidade dos tipos de dados e a correta manipulação de duplicatas, garantindo a integridade dos pipelines.
A plataforma Sail alcança a versão 0.7, trazendo avanços significativos no gerenciamento de estados intermediários, similar ao Apache Spark, agora diretamente para object storage. As novidades incluem o blocking shuffle e o suporte a checkpoint, que permitem a persistência das saídas do shuffle como streams Arrow compactados. Esta funcionalidade é crucial para a resiliência, pois permite a reexecução de tarefas downstream sem propagar falhas para processos upstream. Além disso, o mecanismo de checkpoint evita a reconstrução de longos planos de consulta em jobs iterativos, otimizando a performance. O design da v0.7 visa especificamente a operação com workers stateless, promovendo a utilização de clusters menores e uma resiliência robusta frente a interrupções (preemption), resultando em maior eficiência operacional para computação distribuída.
O PostgreSQL 19 Beta 3 acaba de ser lançado, trazendo novidades robustas que prometem elevar a capacidade e a eficiência do popular banco de dados. Entre os destaques estão o suporte a SQL Temporal, que melhora a gestão de dados históricos, e a função de upsert-and-fetch idempotente. A atualização também inclui o comportamento IGNORE NULLS para funções de janela, repacking concorrente e ferramentas aprimoradas para extração de DDL. A adição do suporte a consultas de grafo SQL/PGQ e um tratamento mais rigoroso para NULLs visam otimizar a manipulação de dados e o desempenho geral, consolidando o PostgreSQL como uma ferramenta ainda mais poderosa para engenheiros e analistas de dados.