
A Anthropic lançou o Claude Fable 5.2 e o Mythos 5.2, já disponíveis. Os modelos trazem melhorias em coding, raciocínio e visão, geração de saída até 30% mais rápida e preços mais baixos. Os dois compartilham a mesma arquitetura subjacente.
A Anthropic lançou o Claude Fable 5.2 e o Mythos 5.2, já disponíveis. Os modelos trazem melhorias em coding, raciocínio e visão, geração de saída até 30% mais rápida e preços mais baixos. Os dois compartilham a mesma arquitetura subjacente.
A Meta apresentou o Muse Ember, um reasoning model pequeno e otimizado para tarefas de agentes, como tool calling, coding e document parsing. Segundo a empresa, o modelo iguala a maior pontuação de reasoning do Claude Haiku 5.5 a cerca de um terço do custo e supera o GPT-6 Luna em diferentes configurações de reasoning. O lançamento oficial está disponível.
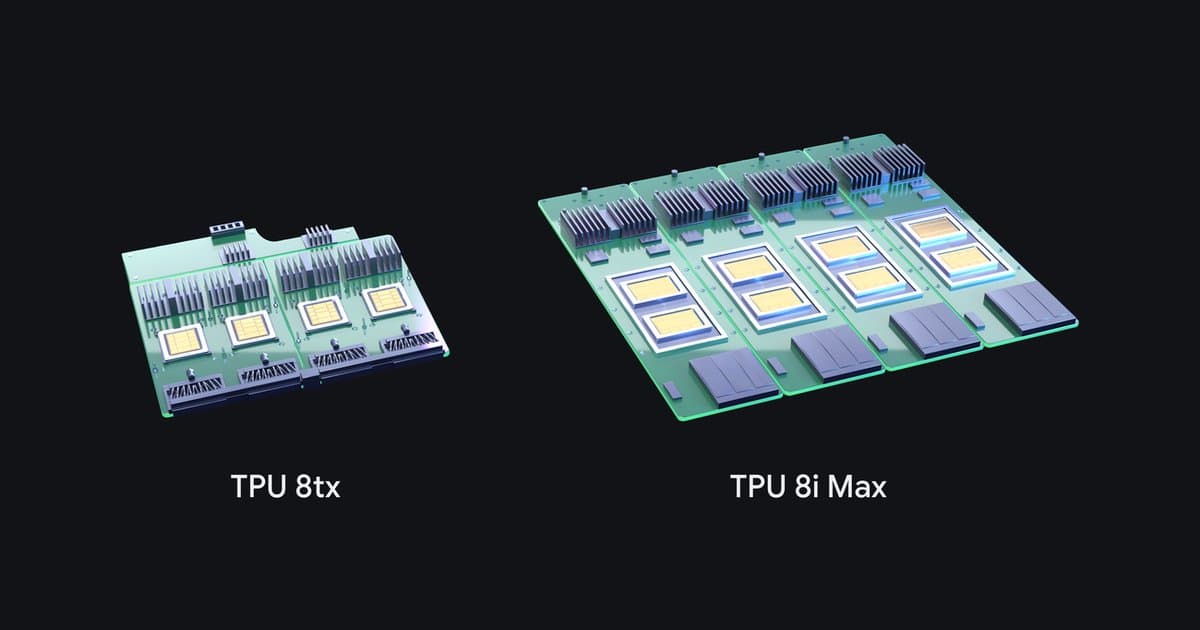
O Google apresentou dois novos modelos de sua linha de TPUs. O TPU 8i Max é voltado a janelas de contexto massivas e a maior densidade de compute. Já o TPU 8tx é destinado a inference seguro e confidencial.
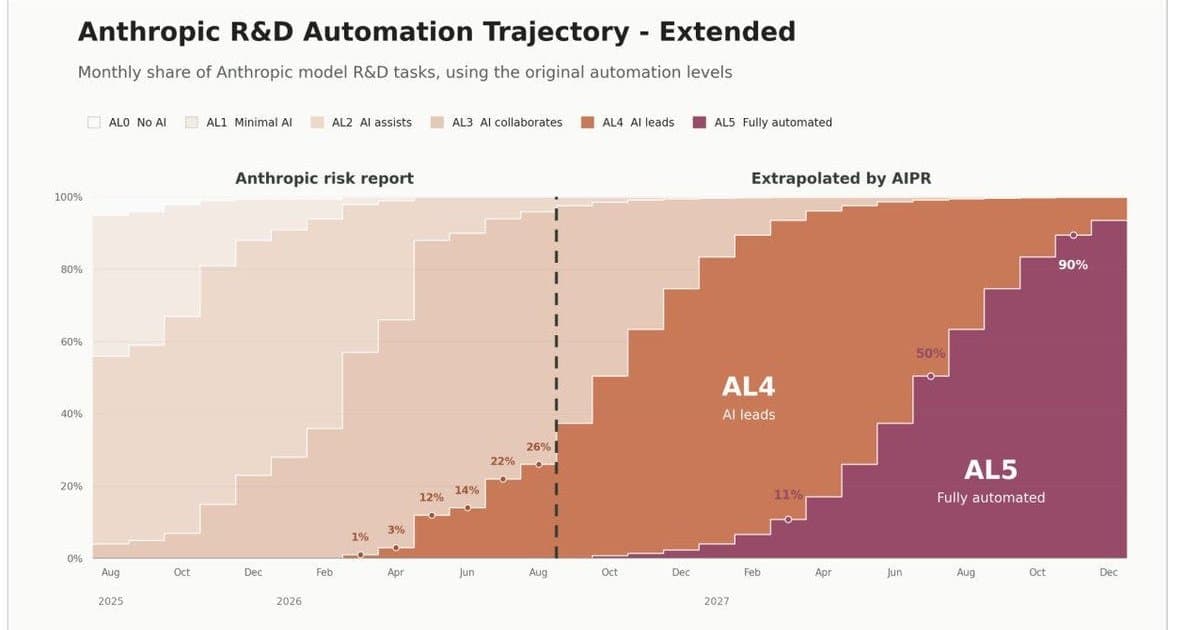
A IA está acelerando a P&D de IA dentro da Anthropic, que é estimada como estando vários meses à frente do cronograma do AI 2027. Segundo a análise, podemos estar a menos de um ano de um RSI completo, e não há gargalos claros no caminho. A recomendação é começar a se preparar para cenários em que eventos críticos ocorram em 2027 ou 2028.
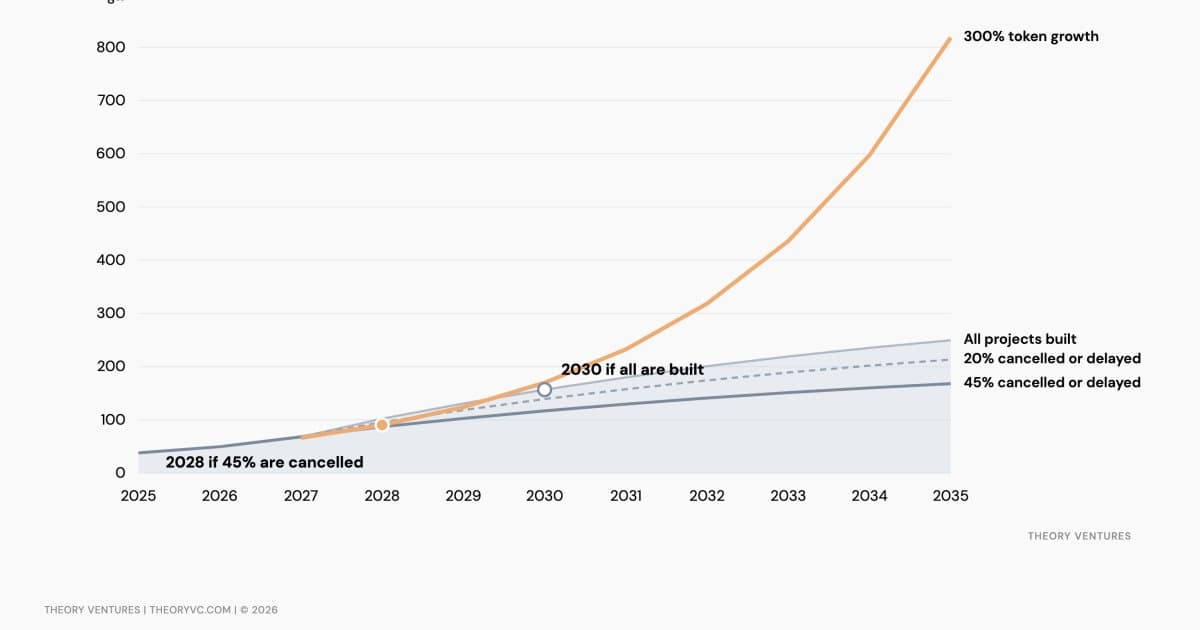
Os EUA podem passar a importar mais tokens de IA do que exportam entre 2028 e 2030. A capacidade doméstica comporta um crescimento anual de tokens de cerca de 2,5x. Se a demanda crescer mais rápido, ou se projetos de data centers forem cancelados, a computação tende a migrar para o exterior.
Mantidas as proporções atuais de gastos, a Anthropic precisaria de uma receita anual estimada em cerca de US$ 200 bilhões para sustentar, até 2030, a média de seus compromissos de compute. O total de US$ 895 bilhões em compromissos expõe a empresa a quedas de demanda, compressão de margens e atrasos na entrega. Também a deixa sujeita a capacidade de curto prazo cara quando a demanda supera as previsões.
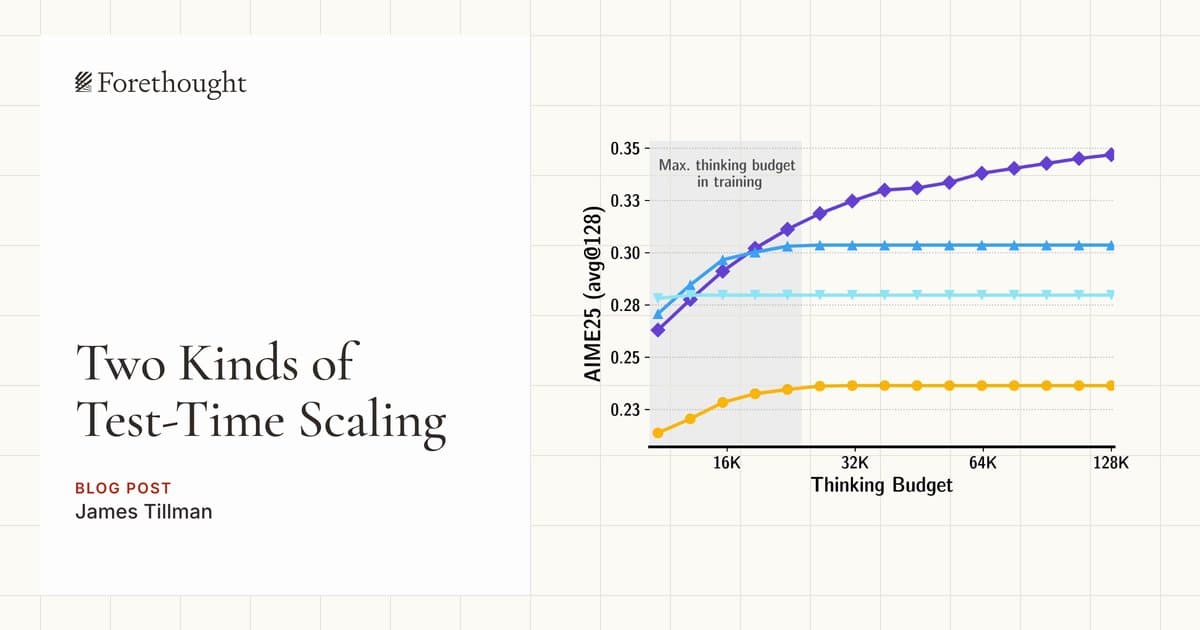
O test-time scaling troca compute por desempenho no momento do teste. Segundo o ensaio, existem dois tipos. No primeiro, pesquisadores usam mais compute para obter mais desempenho por tarefa, mas só até a quantidade máxima de compute por tarefa empregada durante o treinamento. No segundo, também é possível trocar mais compute por mais desempenho por tarefa, mas até quantidades de compute e níveis de desempenho que nunca ocorreram no treinamento. Os métodos de scaling que permitem esse segundo tipo de mudança terão impacto maior do que o test-time scaling entendido de forma simples. O texto descreve como isso pode afetar o mundo.
Reasoning funciona como pathfinding no espaço de tokens: há muitos caminhos entre o problema e uma resposta correta, e o modelo percorre um deles a cada amostra. Nenhum caminho individual tem garantia de chegar à resposta certa. Só no agregado, sobre a distribuição de caminhos, é que se obtém alta probabilidade de sucesso. O treinamento com RL aumenta diretamente essa probabilidade. Já os ganhos atribuídos a "pensar por mais tempo" vêm da busca paga durante o treinamento, e não da inference.
A NVIDIA apresentou o AutoCompress, framework que otimiza o pruning de LLMs para restrições específicas de hardware, como latência, throughput e memória, e não apenas para a contagem de parâmetros. Com ele, o Nemotron 3.5 Super foi comprimido de 120B para 74B de parâmetros, mantendo seu desempenho.
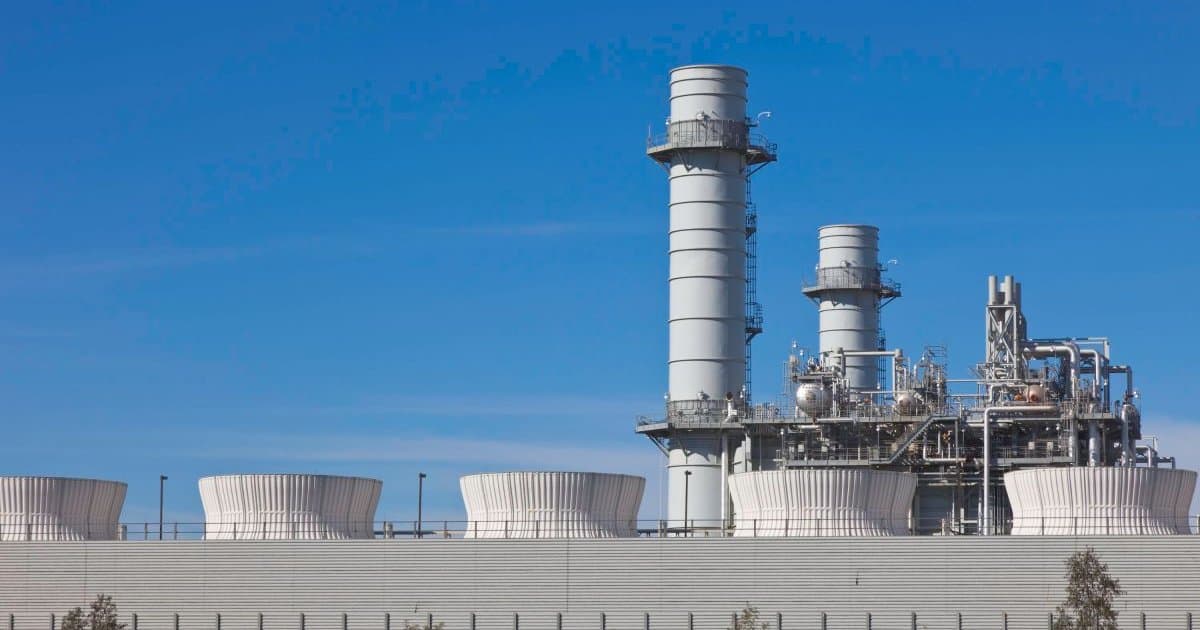
Segundo a publicação, a Anthropic garantiu 1,7 gigawatt em geradores a gás da Caterpillar por US$ 3,4 bilhões, ao assumir pedidos de equipamentos feitos ao fornecedor OnePWR. A compra aprofunda a presença do laboratório de IA em infraestrutura física, num momento em que a falta de energia e as longas filas de conexão à rede limitam a expansão de data centers.
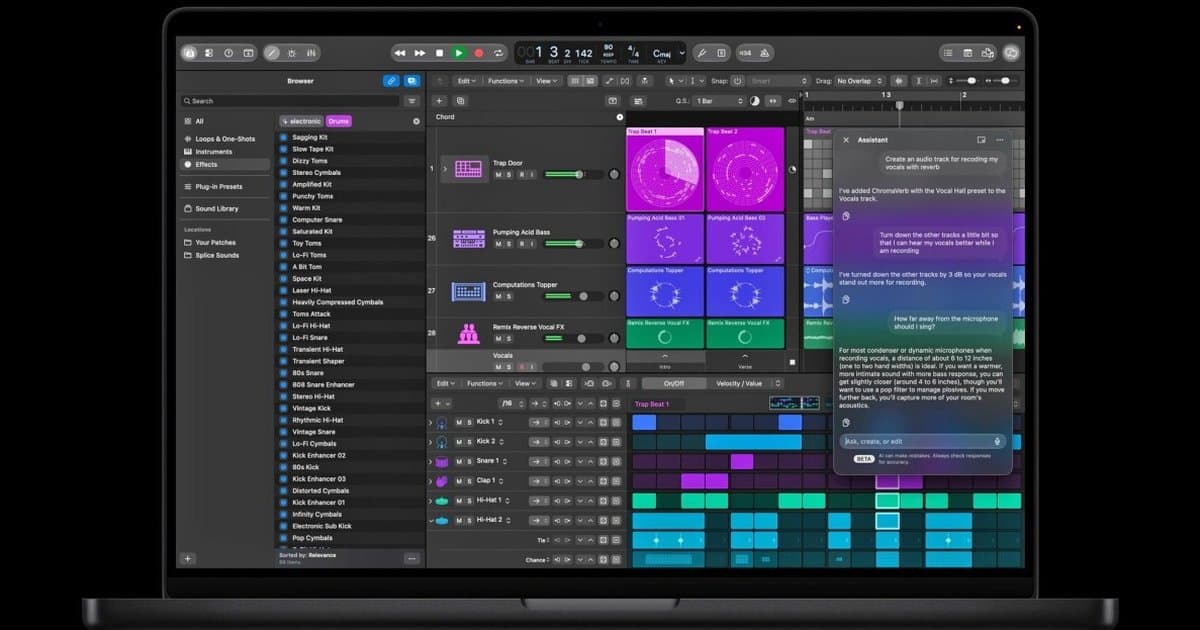
A Apple agora vende os Intelligence Usage Packs, a US$ 49,99, no Logic Pro. Os pacotes ampliam o acesso aos recursos de IA baseados em nuvem depois que o usuário atinge seus limites. A capacidade não utilizada é acumulada a cada mês, mas expira após 12 meses, e as compras não podem ser compartilhadas pelo Family Sharing.
Testes indicam que a forma como o Opus 5.5 faz o raciocínio pode ter mudado. O material, publicado em uma thread, levanta a dúvida se o modelo foi "nerfado", mas o resumo não traz detalhes sobre o que exatamente mudou nem confirmação oficial.
O Control Room, da OpenAI, centraliza a autorização das requisições de inference de pesquisa. Com ele, é possível interromper a saída de modelo de uma carga de trabalho em até 35 segundos após a intervenção.
A Fireworks atualizou o caso do incidente de segurança envolvendo o uso não autorizado de credenciais internas, ocorrido em 6 de outubro. O episódio foi rastreado até um grupo cibercriminoso com motivação financeira, que vende acesso não autorizado a modelos de linguagem de grande porte para gateways de roteamento ilícitos.
O GR00T 2 é a nova geração de foundation world-action models, capazes de prever, de forma conjunta, o vídeo futuro e as ações de robôs. A informação vem da página do projeto em research.nvidia.com.
A OpenAI tornou o ChatGPT Enterprise disponível no AWS Marketplace. Com isso, as organizações podem contratar e gerenciar assinaturas usando as relações de faturamento que já têm com a AWS e abater os gastos elegíveis dos compromissos assumidos com a AWS.
Conteúdo curado diariamente, direto no seu e-mail.