
Test-time scaling tem duas variantes, e só uma vai além do que o treinamento viu
Aprofundamento CEVIU
Aprofundamento
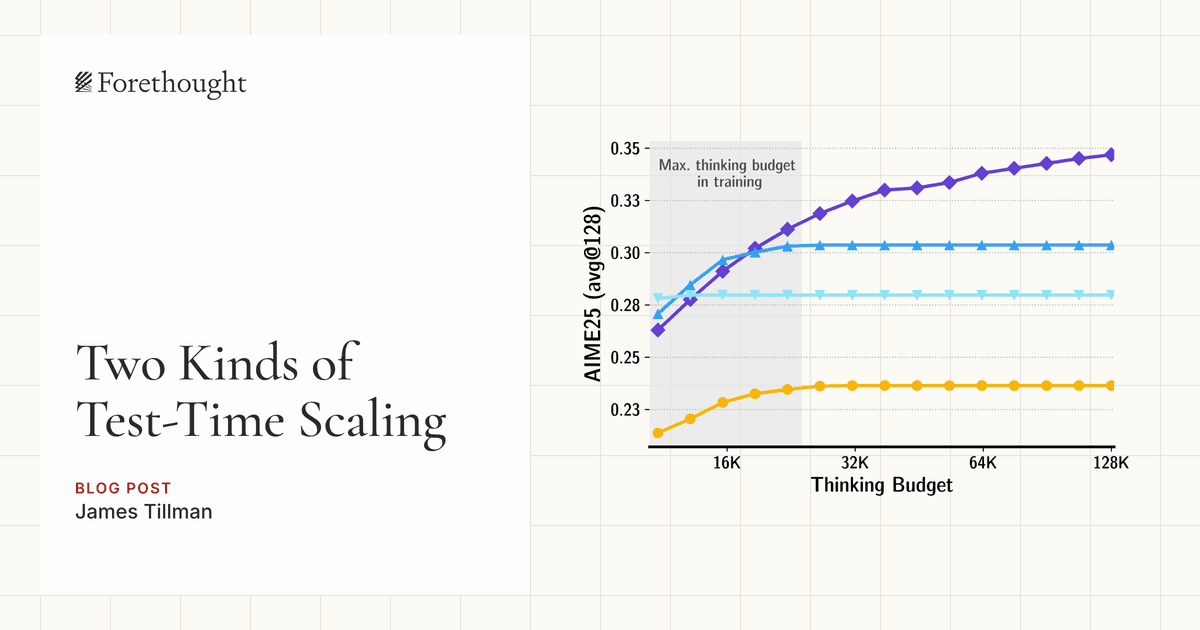
O ensaio da Forethought separa o test-time scaling em dois tipos. No primeiro, mais compute por tarefa gera mais desempenho, mas só até o máximo de compute por tarefa usado no treinamento. No segundo, que o texto chama de extrapolação de compute, o ganho continua em níveis de compute e desempenho que o treinamento nunca viu. O autor propõe duas métricas: o teto (a quantos múltiplos do compute máximo de treino o desempenho para de subir) e a inclinação (quão pior a curva fica além desse ponto). Ele diz acreditar que, em muitos casos, talvez não exista teto absoluto, ou que ele seja altíssimo.
As evidências citadas são mistas. O Reasoning Cache alterna resumos do raciocínio com continuações e extrapola de treino com até 16 mil tokens para meio milhão de tokens gerados, com desempenho ainda subindo. O E3 mostra extrapolação sem pensamento em blocos, mas só de 2,5x e com mudanças no treino, e testes indicam que vários modelos open-weight não ganham com mais tokens do que viram no treino. No MirrorCode, o Opus 4.6 seguiu melhorando a reimplementação de pkl ao fim de um orçamento de um bilhão de tokens, com dezenas de compactações. Na análise de Toby Ord com dados do UK AISI, o Opus 4.5 precisa de 370x mais tokens de chain-of-thought para ganhar o que um humano ganha pensando 10x mais, e o Opus 4.6 precisa de 46x (com barras de erro grandes e poucos dados). O autor vê multi-agente como caminho mais promissor que CoT linear de um único agente, porque paraleliza a cognição e escapa do limite de tempo.
O que mudou
Em 10 de junho de 2026, o CEVIU noticiou "Implicações do Test-Time Compute em larga escala", com o argumento de que benchmarks escondem capacidades porque o desempenho virou função do test-time compute. O ensaio atual refina isso: não basta saber que há mais compute no teste, importa se ele passa do que o treino cobriu. Em 3 de setembro de 2026, o CEVIU tratou do treinamento em tempo de teste como novo eixo de escalonamento. A extrapolação de compute é outro eixo, que não altera pesos, e sim estica o uso de compute além do visto no treino.
Por que isso importa
Para quem avalia modelos, a leitura é que medir desempenho com um orçamento fixo de compute pode subestimar o que o sistema faz quando recebe muito mais. O próprio autor aponta que isso dificulta avaliações de capacidades perigosas. Para quem opera custos de inferência, a pergunta prática é onde o teto e a inclinação de cada domínio ficam, já que pagar 20x mais por tarefa só compensa se a curva ainda sobe.
Linha do tempo
CEVIU noticia que benchmarks escondem capacidades por causa do test-time compute.
CEVIU cobre o treinamento em tempo de teste como novo eixo de escalonamento.
Ensaio separa duas variantes de test-time scaling, só uma indo além do compute visto no treino.
Perguntas frequentes
O que é extrapolação de compute no test-time scaling?
É a capacidade de trocar mais compute por mais desempenho além das quantidades de compute vistas no treinamento. No test-time scaling simples, o ganho só vale até o máximo por tarefa usado no treino. Aqui, o desempenho continua subindo em níveis que o modelo nunca viu.
Como medir essa extrapolação?
O ensaio propõe duas métricas. O teto indica a que múltiplo do compute máximo de treino o desempenho para de subir. A inclinação mede quão pior a curva escala depois desse ponto, em relação à curva observada abaixo do limite.
Que evidências existem de que ela funciona?
O Reasoning Cache foi de 16 mil tokens no treino a meio milhão no teste, com ganhos contínuos. O Opus 4.6 seguiu melhorando em uma tarefa de um bilhão de tokens no MirrorCode. Há também contraevidência: o E3 só chegou a 2,5x, e vários modelos open-weight não se beneficiam de mais tokens.
Por que multi-agente pode extrapolar melhor que um único agente?
Segundo o autor, redes e hierarquias de agentes tendem a ser autossimilares em várias escalas, o que um CoT linear único dificilmente é. Além disso, um agente sozinho esbarra no tempo, enquanto vários agentes paralelizam o trabalho em hardware com mais facilidade.
Fontes
- forethought.orgfonte original
- Categoria
- CEVIU IA
- Publicado
- 10 de novembro de 2026
- Editoria
- CEVIU IA