
Decodificação Especulativa: Velocidade na IA em foco, mas com dilemas de eficiência
Aprofundamento CEVIU
Aprofundamento
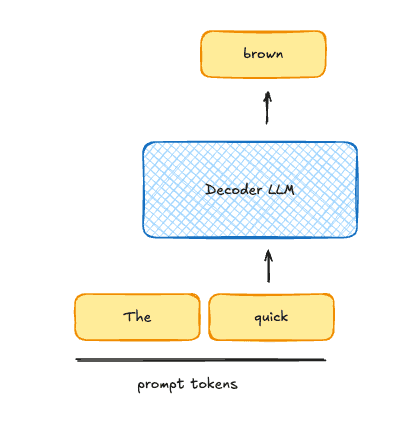
A Decodificação Especulativa é uma técnica astuta para acelerar Large Language Models (LLMs), mas o motivo da sua velocidade é contraintuitivo. Ela não faz menos trabalho, mas sim muda o tipo de trabalho que a GPU executa. Um modelo rascunho menor propõe uma sequência de tokens, que é então validada em paralelo por um modelo maior em uma única etapa de inferência. Isso evita o processamento de um token por vez, que costuma ser uma operação limitada pela memória (memory-bound), onde a GPU espera por dados. Ao validar vários tokens de uma vez, a GPU se torna limitada pelo processamento (compute-bound), aproveitando melhor sua capacidade.
Em vez de focar em reduzir os Floating Point Operations (FLOPs) totais, a Decodificação Especulativa otimiza o fluxo de trabalho da GPU, especialmente em cargas com poucos lotes. Isso significa que, para uma sequência, a GPU pode processar múltiplos tokens em
O que mudou
Em 27 de agosto de 2026, o CEVIU News destacou a Decodificação Especulativa como uma forma de acelerar LLMs em até três vezes, otimizando o uso da GPU. A matéria de 20 de agosto de 2026 sobre o DFlash 2 também reforçou o avanço da técnica para inferência rápida. Naquele momento, o foco era na promessa de velocidade e no potencial de ganhos. A novidade agora é um aprofundamento nos dilemas de eficiência que a técnica apresenta. Entendemos que o ganho não vem de menos trabalho computacional, mas sim de uma reconfiguração do tipo de trabalho da GPU.
O que era visto como uma solução de aceleração geral, agora tem nuances importantes: a técnica é excelente para lotes menores, mas pode ser ineficiente em cenários de alto throughput. Ferramentas como o vLLM já oferecem a opção de desativar a Decodificação Especulativa dependendo do tamanho do lote, e pesquisadores já propõem abordagens dinâmicas, como o dSpark. Isso mostra uma evolução da compreensão da técnica, de uma aceleração bruta para uma otimização mais inteligente e contextualizada.
Por que isso importa
A velocidade de inferência é um fator crucial para a adoção e usabilidade de modelos de IA, superando até mesmo pequenos ganhos marginais em inteligência para aplicações do dia a dia, como apontamos em 3 de agosto de 2026. A Decodificação Especulativa impacta diretamente essa velocidade, traduzindo-se em aplicações de IA mais responsivas e custos operacionais potencialmente menores, se aplicada corretamente. Entender seus limites, como o consumo ineficiente de recursos em alto throughput, é vital para arquitetos de sistemas e engenheiros de Machine Learning.
Para desenvolvedores, saber quando e como ativar ou desativar a Decodificação Especulativa em sistemas como o vLLM pode significar a diferença entre uma infraestrutura eficiente e uma que desperdiça capacidade. Essa otimização é essencial para escalar soluções de IA e garantir que a tecnologia seja não só rápida, mas também economicamente viável.
Linha do tempo
CEVIU News publica 'Dois Truques Distintos para Inferência Rápida de LLMs'.
Acelerando Gemma 4: inferência mais rápida com drafters de predição multi-token.
CEVIU News destaca que a velocidade na inferência de IA supera ganhos marginais em inteligência.
CEVIU News apresenta 'IA Híbrida: Otimização de Processamento com Foco em Eficiência e Redução de Recursos'.
DFlash 2 revoluciona inferência de LLMs com decodificação especulativa aprimorada.
CEVIU News publica 'Decodificação Especulativa: O Segredo para Acelerar LLMs em até 3 Vezes'.
CEVIU News aborda Decodificação Especulativa e os dilemas de eficiência.
Perguntas frequentes
O que é Decodificação Especulativa?
É uma técnica que acelera LLMs. Ela usa um modelo menor para rascunhar uma sequência de tokens, que é então validada de uma vez por um modelo maior, em vez de gerar um token por vez.
Por que a Decodificação Especulativa é rápida, se faz mais trabalho?
A velocidade não vem de menos trabalho computacional (FLOPs), mas sim de uma mudança no tipo de trabalho da GPU. Ela transforma operações limitadas pela memória em operações limitadas pelo processamento, aproveitando melhor a capacidade da GPU, especialmente com lotes menores.
Quais são as desvantagens da Decodificação Especulativa?
Em ambientes de alto throughput, a técnica pode gerar um consumo ineficiente de recursos. Se a taxa de aceitação dos tokens propostos for baixa, mais trabalho é desperdiçado, direcionando a capacidade da GPU de forma ineficiente.
Como a Decodificação Especulativa se relaciona com a otimização de LLMs?
Ela é uma estratégia para otimizar a latência e responsividade de LLMs, um tema que o CEVIU News abordou em outras oportunidades. O objetivo é equilibrar a aceleração da inferência com a eficiência no uso de recursos, adaptando a técnica às condições de carga específicas.
Fontes
- jbarrow.aifonte original
- Categoria
- CEVIU IA
- Publicado
- 09 de outubro de 2026
- Editoria
- CEVIU IA