
Análise forense aponta que modelos chineses de ponta foram treinados com GPUs Blackwell da NVIDIA
Aprofundamento CEVIU
Aprofundamento
A análise forense lê apenas os pesos publicados dos modelos. Antes do treino, os pesos recebem valores iniciais gerados pelo algoritmo Philox, via PyTorch e cuRAND. O número de threads usadas depende da quantidade de SMs da GPU, e isso muda a posição dos números na matriz. Hopper (H100 SXM, H200, H800) tem 132 SMs, B200/B300 tem 148 e GB200/GB300 tem 152. Recuperando seed e contagem de threads, dá para saber o grupo de hardware que inicializou os pesos.
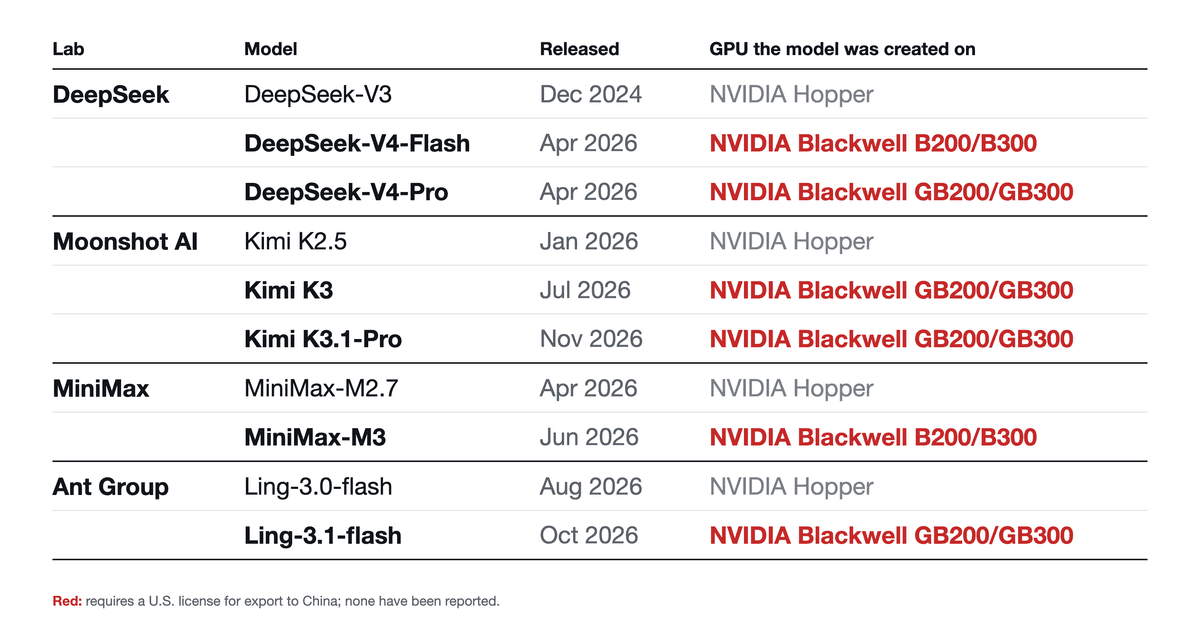
Seis modelos leem como Blackwell: DeepSeek-V4-Flash e MiniMax-M3 (B200 ou B300), DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro e Ling-3.1-flash (GB200 ou GB300). Para DeepSeek-V4-Flash e Kimi K3, o resultado foi confirmado em chips Blackwell físicos. A fonte estima que Kimi K3 e DeepSeek-V4-Pro precisaram de cerca de 4.500 e 3.000 GPUs Blackwell por dois a três meses, com ressalvas fortes: eficiência (MFU), tokens e duração dos treinos não são publicados. Se o ritmo fosse o da Microsoft com o MAI-Base-2, os dois maiores treinos chegariam a 8.000 ou 9.000 GPUs. A análise prova acesso ao hardware, não onde estava, como foi obtido nem se houve violação de controles de exportação. Alibaba (Qwen), Zhipu, Tencent, Xiaomi e StepFun ainda leem como Hopper.
O que mudou
Em 26 de fevereiro de 2026, o CEVIU noticiou "DeepSeek Restringe Acesso ao Seu Novo Modelo de IA a Fabricantes de Chips dos EUA, Incluindo Nvidia", sobre o V4. Agora a análise mostra que o V4 (lançado em abril de 2026) já leria como Blackwell. Em 24 de julho de 2026, o CEVIU noticiou "DeepSeek V4 na Huawei: Chips Ascend impulsionam o treinamento de IAs chinesas", sobre o pós-treinamento do V4 em Ascend. As duas coisas não se excluem: a análise cobre a inicialização dos pesos, não necessariamente todas as etapas. Em 4 de novembro de 2026, o CEVIU noticiou o relato não confirmado de que o V5 seria treinado em Ascend, o que contrasta com o uso de Blackwell indicado agora para o V4.
Por que isso importa
Para quem acompanha a corrida de modelos, isso sugere que as restrições de exportação não impediram os laboratórios chineses de treinar na geração mais recente da Nvidia. Leitura editorial: a mudança de Hopper para Blackwell nos modelos de 2026 pode ajudar a explicar o salto de capacidade, mas a própria fonte ressalva que as estimativas de escala são frágeis.
Linha do tempo
CEVIU noticia que a DeepSeek restringiu o acesso antecipado ao V4 a fabricantes de chips dos EUA.
Relatório liderado pela Huawei detalha o pós-treinamento do DeepSeek V4 em chips Ascend.
Relato não confirmado diz que a DeepSeek planeja treinar o V5 em chips Ascend.
Análise forense indica que seis modelos de DeepSeek, Moonshot, MiniMax e Ant Group usaram Blackwell.
Perguntas frequentes
Como dá para saber em qual GPU um modelo foi treinado?
A análise recupera, nos pesos publicados, traços dos valores iniciais gerados pelo Philox. A quantidade de threads, que depende dos SMs da GPU, muda onde esses valores ficam. Isso identifica o grupo de hardware que inicializou os pesos, mas não prova sozinho que o treino inteiro rodou nele.
Quais modelos chineses leem como Blackwell?
DeepSeek-V4-Flash, DeepSeek-V4-Pro, Kimi K3, Kimi K3.1-Pro, MiniMax-M3 e Ling-3.1-flash, da Ant Group. Modelos recentes de Alibaba, Zhipu, Tencent, Xiaomi e StepFun ainda leem como Hopper.
A análise prova violação dos controles de exportação?
Não. Ela dá evidência técnica de acesso a hardware avançado, mas não diz onde os chips estavam, como foram obtidos nem se houve violação das regras.
Quantas GPUs Blackwell esses treinos teriam usado?
A estimativa é de cerca de 4.500 GPUs para o Kimi K3 e 3.000 para o DeepSeek-V4-Pro, e cerca de 12.000 nos cinco treinos. A própria fonte diz não ter confiança nesses números, pois dependem de suposições sobre eficiência, tokens e duração.
Fontes
- unemploymentlabs.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 13 de novembro de 2026
- Editoria
- CEVIU IA