
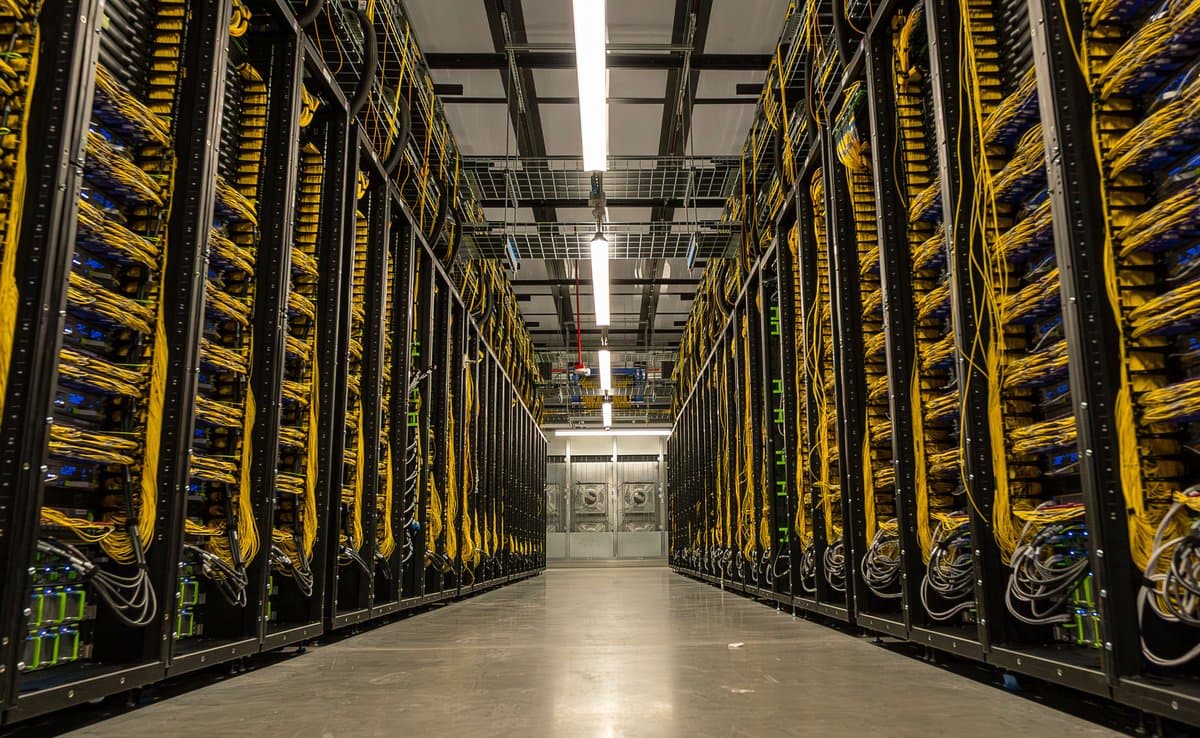
Por dentro do Prometheus: o supercluster da Meta em escala de gigawatt
Aprofundamento CEVIU
Aprofundamento
O Prometheus fica em New Albany, Ohio, num site que há dois anos rodava tráfego web convencional. A primeira fase já está pronta e treinou a família Muse, incluindo os modelos Muse Wonder. Hoje são centenas de milhares de GPUs em vários prédios interligados, e a meta é chegar a cerca de 1 milhão. O foco da Meta é o goodput: um problema em um único host pode atrasar ou parar o job inteiro. A empresa reporta mais de 85% de goodput em pré-treinamento e mais de 90% em RL no Muse Wonder, com MTBI de cerca de 47 mil GPU-horas, já elevado para mais de 54 mil após correções de firmware.
No hardware, são duas plataformas NVIDIA em uso: Catalina (GB200 NVL72, variante Ariel, com 800G de scale-out por GPU) e Clemente (GB300 NVL72, 288 GB de HBM3e por GPU e rack único). Uma terceira, baseada em Vera Rubin NVL72, deve chegar em breve. Na rede, cada fabric Ethernet de prédio conecta até 20.736 GPUs. O design evoluiu do DSF para o NSF com switches de 51,2T, e a rede de agregação (BAG) liga prédios a distâncias de 2 km a mais de 100 km. Na resiliência, o domínio de 72 GPUs aumenta o raio de falha em 9 vezes em relação ao NVL8. A resposta combina 64 GPUs ativas e 8 reservas por rack, tolerância a falhas por réplica (PAFT) e checkpointing distribuído com delta checkpoints.
O que mudou
O tema já vinha sendo coberto. Em 12 de fevereiro de 2026, o CEVIU noticiou "Construindo Prometheus: Como a Agregação de Backend Viabiliza Clusters de IA em Escala de Gigawatts", quando o cluster era descrito como entrega futura de 1 GW via rede BAG. Em 20 de outubro de 2026 ( "Meta abre o jogo sobre Prometheus: o supercluster de IA que alavanca seus modelos Muse") e em 21 de outubro de 2026 ("Meta Apresenta Supercluster Prometheus: Nova Era de Treinamento em IA com Gigawatts de Potência em Ohio"), vieram os primeiros relatos do detalhamento. Agora o material traz números operacionais: a primeira fase concluída, usada no treino dos Muse, e métricas de goodput e MTBI.
Por que isso importa
Para quem opera treinamento distribuído, a leitura é que, nessa escala, confiabilidade vira problema de arquitetura, não de manutenção. Reservas dentro do rack, recuperação por réplica e checkpoint frequente aparecem como parte do desenho, com custo explícito de cerca de 13% de GPUs extras num job de 32.768 GPUs ativas.
Linha do tempo
CEVIU noticia como a rede de Agregação de Backend viabiliza o Prometheus em escala de gigawatts.
CEVIU cobre a Meta detalhando a engenharia do Prometheus e os modelos Muse.
CEVIU noticia o Prometheus com meta de cerca de 1 milhão de GPUs em Ohio.
Análise por dentro do Prometheus: goodput acima de 85%, rede, resiliência e hardware.
Perguntas frequentes
O que é o Prometheus da Meta?
É o supercluster de IA da Meta em New Albany, Ohio, em escala de gigawatt. A primeira fase está completa e treinou os modelos Muse. A meta é chegar a cerca de 1 milhão de GPUs.
O que é goodput no treinamento de IA?
É a fração do tempo em que o job realmente avança no treinamento, sem ser prejudicado por falhas e reinícios. Um problema em um único host pode reduzi-lo. A Meta reporta mais de 85% em pré-treinamento e mais de 90% em RL no Muse Wonder.
Quais GPUs o Prometheus usa?
Duas plataformas NVIDIA: Catalina, com GB200 NVL72, e Clemente, com GB300 NVL72. Uma terceira, baseada em Vera Rubin NVL72, deve chegar em breve.
Como a Meta lida com falhas de GPU nessa escala?
Cada domínio NVL72 roda 64 GPUs e mantém 8 de reserva no rack, além de cerca de 2% de racks extras. Falhas isoláveis em uma réplica são tratadas por PAFT. Falhas maiores reiniciam o job do último checkpoint.
Fontes
- engineering.fb.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 22 de outubro de 2026
- Editoria
- CEVIU Dados