
Netflix Otimiza Infraestrutura de GPU para Treinamento e Inferência em Larga Escala
Aprofundamento CEVIU
Aprofundamento
A Netflix detalhou sua abordagem multicamadas para garantir a confiabilidade de suas GPUs, essenciais para treinamento e inferência de modelos de IA em larga escala. O sistema vai além das verificações básicas de saúde da infraestrutura, que muitas vezes não detectam falhas sutis em GPUs ou na rede de alta velocidade. Essas falhas podem degradar ou parar trabalhos distribuídos inteiros, já que uma GPU pode responder a uma consulta de status e ainda falhar sob carga. Além disso, adaptadores de rede podem operar com banda reduzida sem serem detectados por checks superficiais.
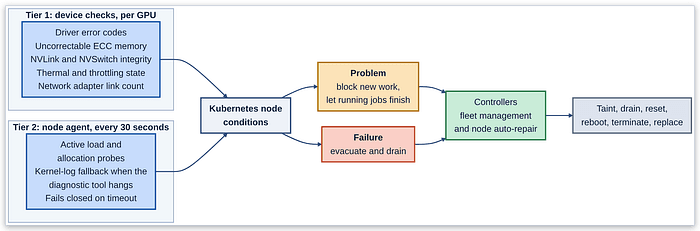
Para combater esses problemas, a estratégia da Netflix se estrutura em quatro camadas. A camada de saúde do nó e hardware identifica problemas e remove máquinas defeituosas. Em seguida, o agendador e a plataforma validam as máquinas antes de aceitarem trabalho. A terceira camada, no loop de treinamento, usa checkpointing e workers elásticos para que jobs sobrevivam à perda de uma máquina. Por fim, a observabilidade monitora métricas e atribui falhas, garantindo o bom funcionamento de todo o sistema. As verificações de saúde operam em dois níveis: device-level (GPU) e node-level (agente baseado no node-problem-detector do Kubernetes), usando ferramentas como NVIDIA DCGM e inspeção de Elastic Fabric Adapter, com mecanismos robustos para evitar falsos positivos ou silêncio em caso de falha.
O que mudou
Em publicações anteriores, a Netflix nos mostrou como dimensionava o pós-treinamento de LLMs (em 16 de fevereiro de 2026) e como implementava uma plataforma interna para implantação e servimento desses modelos em produção (em 20 de julho de 2026). A cobertura atual complementa essas iniciativas, detalhando a infraestrutura fundamental de GPUs que sustenta tais operações. Antes, o foco era na aplicação e no ciclo de vida dos modelos. Agora, a Netflix explica as camadas de resiliência e auto-recuperação da sua infraestrutura de computação. Isso garante que os LLMs e outros modelos de IA tenham recursos de hardware estáveis e eficientes para funcionar. É a peça do quebra-cabeça que garante a base tecnológica para as inovações que já vinham sendo discutidas.
Por que isso importa
A confiabilidade da infraestrutura de GPUs é crítica para a Netflix em diversas frentes. Primeiramente, ela assegura a disponibilidade contínua de serviços de IA, desde as recomendações personalizadas que os usuários veem diariamente até as ferramentas criativas para parceiros de produção. Interrupções ou degradações impactam diretamente a experiência do membro e a produtividade interna. Além disso, a eficiência de custos é um fator chave: GPUs são componentes caros e de rápido crescimento na infraestrutura da empresa. Maximizar a utilização, garantindo que cada unidade realize o máximo de trabalho útil, equivale a reduzir despesas e otimizar o investimento em hardware. Com o avanço da IA generativa, a demanda por GPUs só tende a crescer, tornando essa otimização ainda mais estratégica para o negócio.
Linha do tempo
Netflix dimensiona o pós-treinamento de LLMs.
Databricks apresenta 'model units' para inferência de LLM.
Databricks detalha confiabilidade de GPUs em larga escala para IA.
PyTorch Monarch chega às GPUs AMD.
Netflix cria plataforma interna para implantação de LLMs em produção.
AWS lança EKS Node Monitoring Agent para reparar GPUs no Kubernetes.
Netflix otimiza infraestrutura de GPUs para treinamento e inferência.
Perguntas frequentes
Quais são os desafios ocultos na confiabilidade de GPUs que a Netflix aborda?
Desafios incluem GPUs que parecem saudáveis mas falham sob carga, problemas em adaptadores de rede de alta velocidade que degradam o desempenho sem falhar totalmente, e ferramentas de diagnóstico que podem travar ou falhar silenciosamente, mascarando problemas reais. Verificações básicas não capturam esses cenários.
Como a Netflix garante a saúde preventiva das GPUs?
O sistema da Netflix usa uma abordagem multicamadas. Ele valida os nós de computação preventivamente antes de alocar trabalho, monitora o hardware em tempo real com checks detalhados e específicos para GPUs e rede, e ainda tem mecanismos de fallback e mapeamentos de erros customizados para detectar falhas que ferramentas genéricas perdem.
O que acontece quando uma GPU apresenta falha na Netflix?
O sistema atua de forma autônoma. Falhas menores podem levar a um bloqueio temporário para novos trabalhos, enquanto problemas persistentes escalam para uma condição de falha que drena tarefas, termina a máquina e a substitui. As ações são graduadas, desde resetar uma GPU até substituir o hardware completo, com o auxílio do Karpenter node auto-repair.
Qual a importância dessa otimização para os negócios da Netflix?
É fundamental para a disponibilidade e eficiência de custos. Garante que os modelos de IA funcionem sem interrupção, impactando desde recomendações até ferramentas de produção. Otimiza o investimento em GPUs, maximizando a utilização e minimizando perdas, essencial para escalar as crescentes demandas da IA generativa.
Fontes
- netflixtechblog.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 19 de outubro de 2026
- Editoria
- CEVIU Dados