
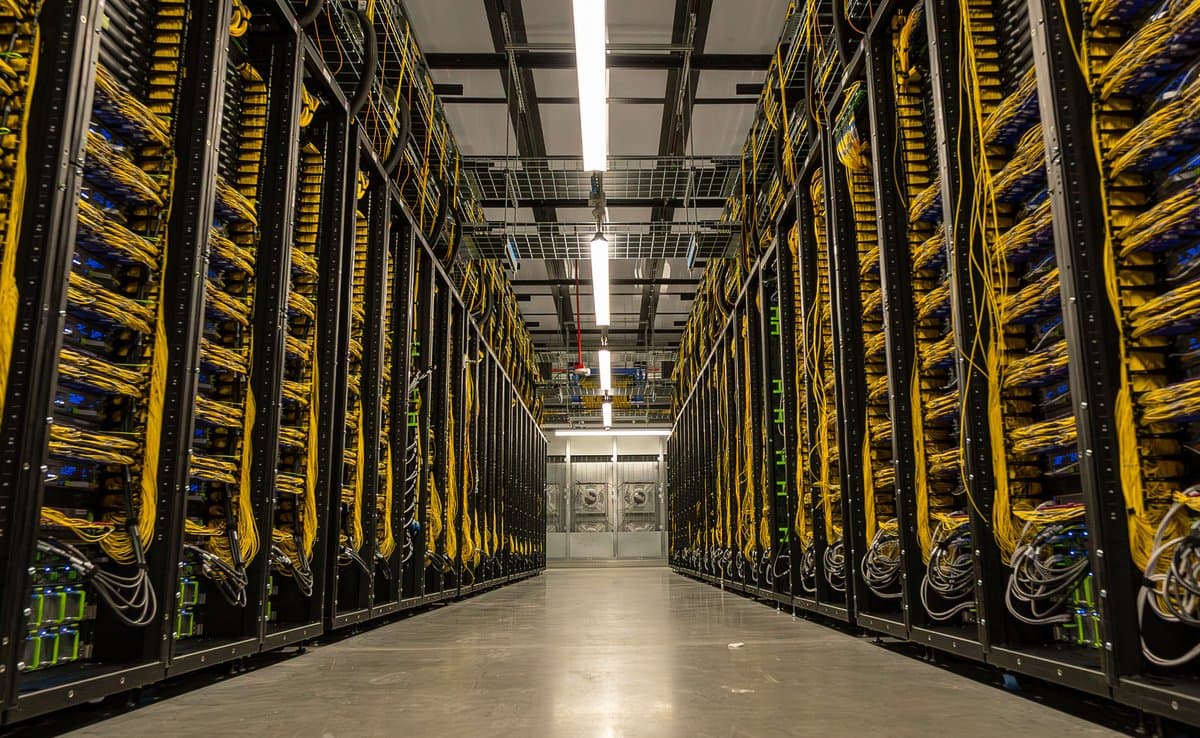
Meta Apresenta Supercluster Prometheus: Nova Era de Treinamento em IA com Gigawatts de Potência em Ohio
Aprofundamento CEVIU
Aprofundamento
O Prometheus é um marco na infraestrutura de IA, não só pelo volume (um milhão de GPUs, gigawatts de potência), mas pela sofisticação de sua arquitetura de rede e resiliência. O CEVIU já detalhou em fevereiro de 2026, na matéria "Construindo Prometheus: Como a Agregação de Backend Viabiliza Clusters de IA em Escala de Gigawatts", como a Meta aborda a interconexão de dezenas de milhares de GPUs. A rede de Agregação de Backend (BAG) é crucial, permitindo que os clusters em edifícios diferentes funcionem como uma única máquina. Isso é essencial para manter a alta taxa de "goodput" (85% em pré-treinos), garantindo que as GPUs fiquem sempre processando, sem gargalos na comunicação.
A arquitetura de rede do Prometheus evoluiu do Disaggregated Scheduled Fabric (DSF) para o Non-Scheduled Fabric (NSF), usando switches Ethernet de baixa latência e alta largura de banda. Isso é crítico para a comunicação GPU-a-GPU e para gerenciar fluxos de dados massivos em treinos de IA. O cluster utiliza as plataformas NVIDIA GB200 NVL72 (Catalina) e GB300 NVL72 (Clemente), que trazem avanços em capacidade de memória (HBM3e), poder de computação (PFLOPS) e largura de banda NVLink. A robustez também é vista nas estratégias de tolerância a falhas, como o Parallelism-Aware Fault Tolerance (PAFT) e checkpointing distribuído, que são vitais para evitar interrupções, algo que o CEVIU já destacou em julho de 2026, ao abordar a resiliência no treinamento de IA com PyTorch Monarch.
O que mudou
A Meta já havia indicado sua visão de longo prazo para o Prometheus. Agora, vemos a materialização de algumas dessas ambições em hardware de ponta. Enquanto o supercluster já opera com as plataformas NVIDIA GB200 e GB300, a notícia de que a Meta planeja integrar a futura Vera Rubin NVL72 se alinha perfeitamente com a recente disponibilidade dessa tecnologia. O CEVIU noticiou em 21 de outubro de 2026 que o Google Cloud e a NVIDIA estavam lançando instâncias A5X baseadas justamente na Vera Rubin NVL72. Isso mostra que a Meta está atenta e pronta para adotar as mais recentes inovações da NVIDIA assim que chegam ao mercado, garantindo que o Prometheus permaneça na vanguarda da capacidade de processamento de IA.
Por que isso importa
A construção do Prometheus reafirma a estratégia da Meta de dominar a infraestrutura para modelos de IA de próxima geração. Para o ecossistema de DevOps e engenharia de plataformas, este projeto é um estudo de caso sobre como escalar sistemas distribuídos para níveis sem precedentes, priorizando "goodput" e resiliência. A Meta demonstra como a co-engenharia com parceiros como a NVIDIA e a inovação em redes de baixa latência são fundamentais para sustentar o treinamento de modelos que, como a família Muse, demandam consistência e performance quase perfeitas. É um modelo para quem busca operar infraestruturas de IA em escala de exaflops, onde cada ponto percentual de eficiência se traduz em milhões de dólares e meses de desenvolvimento.
Linha do tempo
Meta detalha a rede de Agregação de Backend (BAG) para seus clusters de IA em escala de gigawatts, como o Prometheus.
Meta revela detalhes da engenharia por trás do supercluster Prometheus, projetado para impulsionar seus modelos Muse.
Google Cloud e NVIDIA anunciam a disponibilidade geral das instâncias A5X, baseadas na NVIDIA Vera Rubin NVL72.
Meta apresenta seu supercluster Prometheus em Ohio, confirmando o uso de plataformas NVIDIA e planos para integrar a Vera Rubin NVL72.
Perguntas frequentes
O que é o supercluster Prometheus da Meta?
É uma gigantesca infraestrutura de IA, desenvolvida pela Meta em Ohio, projetada para hospedar aproximadamente um milhão de GPUs. Com capacidade na faixa de gigawatts, ele serve para treinar os modelos fundamentais de IA da empresa, como a família Muse.
Qual o papel da NVIDIA no Prometheus?
A NVIDIA é uma parceira fundamental. O Prometheus utiliza plataformas NVIDIA, como as GB200 e GB300, e planeja integrar a futura Vera Rubin NVL72. Essa colaboração garante acesso a hardware de ponta para o treinamento de modelos de IA em larga escala.
O que significa "goodput" no contexto de treinamento de IA?
"Goodput" é uma métrica de eficiência que indica a porcentagem do tempo em que as GPUs estão efetivamente realizando trabalho útil durante o treinamento. No Prometheus, a Meta alcançou 85% de "goodput" em pré-treinos, um índice elevado para a escala da operação, minimizando o tempo ocioso das máquinas.
Como a Meta garante a confiabilidade do Prometheus?
A confiabilidade é assegurada por estratégias como o Parallelism-Aware Fault Tolerance (PAFT), que isola falhas e permite que o treinamento continue. Há também um sistema robusto de checkpointing distribuído e a utilização de GPUs e racks sobressalentes para rápida recuperação de falhas, minimizando interrupções.
Fontes
- engineering.fb.comfonte original
- Categoria
- CEVIU DevOps
- Publicado
- 21 de outubro de 2026
- Editoria
- CEVIU DevOps