
O paper Socrates que dividiu o banco de dados em quatro por trás do Azure SQL Database Hyperscale
Aprofundamento CEVIU
Aprofundamento
O ponto de partida do paper Socrates é o limite da arquitetura de réplicas completas, usada ainda hoje no tier Business Critical. Cada banco roda em um cluster de 3 a 4 réplicas, com uma primária e três secundárias que reproduzem o log de transações. Cada réplica guarda uma cópia inteira dos dados em SSD local. Por isso o banco nunca passa do disco de uma máquina, o backup disputa I/O com o tráfego vivo e criar uma réplica exige copiar tudo pela rede. O teto prático era de cerca de 4 TB.
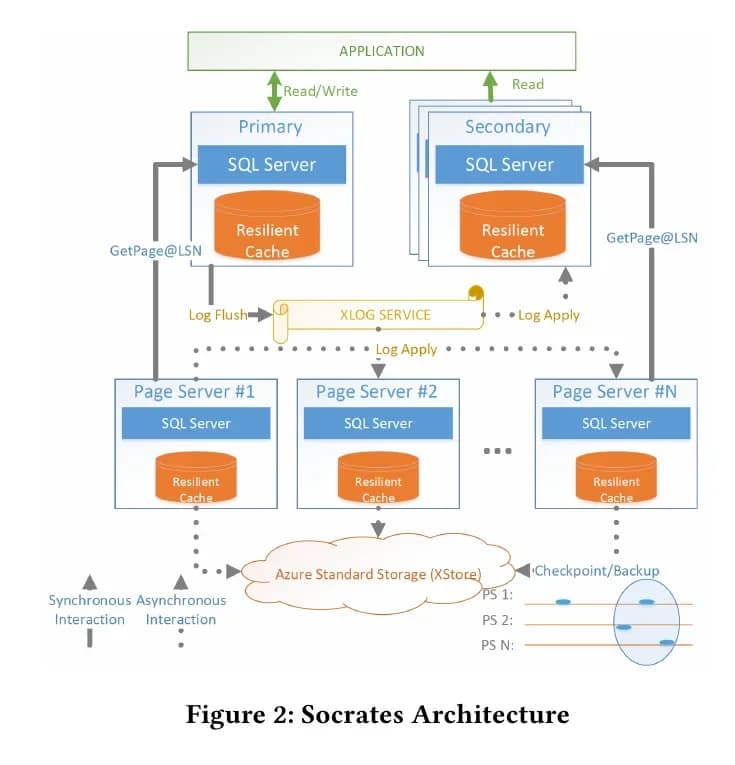
O Socrates divide o banco em quatro camadas: nós de compute (com buffer pool e cache SSD RBPEX), o serviço XLOG (dono do log), page servers (dono dos dados) e o XStore, sobre Azure Storage, que guarda a cópia durável e faz backup por snapshot. A chamada GetPage@LSN conecta tudo: o compute pede uma página a um page server num ponto específico do log, e o servidor só responde depois de aplicar o log até ali. Ao separar log e armazenamento, durabilidade e disponibilidade passam a escalar de forma independente. Segundo o paper, as operações de escala foram de O(dados) para O(1) e as cópias de armazenamento caíram de quatro para duas. Em um banco de 1 TB, um cache de 22% dos dados atendeu 52% das leituras. Em um TPC-E de 30 TB, 1% de cache atendeu 32%. Sob carga pesada de updates, o log chegou a 89,8 MB/s contra 56,9 MB/s da arquitetura anterior.
Por que isso importa
Para quem opera dados em escala, a leitura é que o ganho não vem de hardware maior, e sim de tirar do compute o que pode viver no armazenamento. Backup por snapshot e réplicas de leitura rápidas tornam viável isolar relatórios e cargas analíticas do transacional sem copiar terabytes. E o T-SQL continua igual, então a migração de arquitetura não exige reescrever aplicação.
Perguntas frequentes
Por que o Azure SQL antigo ficava limitado a cerca de 4 TB?
Cada réplica precisava de uma cópia completa dos dados em SSD local, então o banco não podia exceder o disco de uma máquina. Backup, failover e criação de réplicas cresciam junto com o tamanho dos dados. O teto prático ficou em torno de 4 TB.
O que é o Socrates?
É o codinome interno do Azure SQL Database Hyperscale, descrito no paper Socrates: The New SQL Server in the Cloud, publicado no SIGMOD 2019. Ele separa o banco em compute, XLOG, page servers e XStore.
Como o Hyperscale restaura um banco de 50 TB em minutos?
O backup é feito por snapshots na camada de armazenamento, e o restore deixa de ser uma cópia proporcional ao tamanho dos dados. Um novo compute também sobe sem semear dados, apenas apontando para os page servers.
O que é o GetPage@LSN?
É a chamada em que um nó de compute pede a um page server uma página específica em um ponto definido do log. O page server só devolve a página depois de aplicar o log até aquele LSN. Isso garante que a réplica nunca veja uma página desatualizada.
Fontes
- devblogs.microsoft.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 29 de outubro de 2026
- Editoria
- CEVIU Dados