
Netflix usa LLMs para diagnosticar falhas de forma mais confiável com o Pensive AI
Aprofundamento CEVIU
Aprofundamento
O Pensive AI é a evolução do Pensive, sistema de diagnóstico e remediação automática da plataforma de dados da Netflix. Na versão original, regex e regras em Java escritas à mão extraíam e classificavam erros e repassavam orientação de retry a produtos como o Maestro. Isso tornou cerca de 50% das falhas autoatendidas. O limite era a cobertura: em três meses, o sistema processou cerca de sete milhões de classificações de falhas, e quase metade caiu em "desconhecido". Em dias de pico, cerca de 100 mil workloads falham.
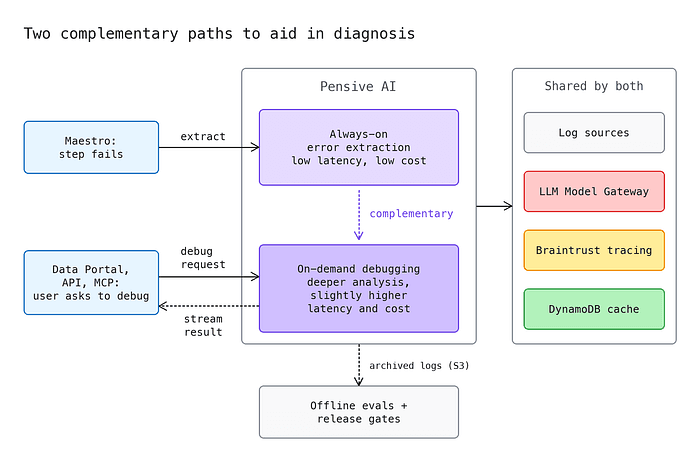
A decisão central de arquitetura é não pedir ao modelo que repita o stack trace. O Pensive numera as linhas do log e envia registros {lineNumber, text}. O modelo devolve só dois inteiros, a primeira e a última linha do trecho do erro, e o sistema reconstrói o texto a partir da cópia do próprio log. Isso reduz custo e latência (gerar tokens é bem mais lento que lê-los) e limita hallucination, embora o modelo ainda possa escolher o intervalo errado. A extração roda em paralelo por log, com prazo compartilhado dentro do timeout rígido de 90 segundos do Maestro. Chamadas que estouram o prazo ficam fora do resultado.
O diagnóstico completo (causa raiz e remediação) roda sob demanda, via API, MCP e Data Portal, e leva de dezenas de segundos a um minuto. A unidade de trabalho é a tentativa de step que falhou, e o cache por tentativa vira leitura chave-valor, com escrita condicional para evitar geração duplicada e expiração em 90 dias. As respostas saem por server-sent events, com cada evento trazendo a resposta completa até ali. Para avaliação, as regras antigas servem de rótulo de referência, e os logs são arquivados no S3 para repetir experimentos. Os sinais medidos são inclusão, precisão, ruído repetido e latência. Segundo a Netflix, a extração por IA cobre 100% das falhas. Tentativas sem uso do Pensive AI tiveram em média 321% mais ações manuais de exploração de logs, numa comparação observacional, não causal. A migração de clientes ainda está em andamento, e o Data Portal já lê o novo campo, enquanto editor de queries, notebooks do Workbench e alguns clientes de Slack usam o caminho legado.
Por que isso importa
Para quem opera pipelines de dados, o desenho serve de referência prática: deixar o LLM apontar posições e manter o texto vindo da fonte é um jeito barato de reduzir alucinação. Manter regras determinísticas como piso de regressão e rótulo de avaliação também dá um caminho realista para adotar IA sem perder o que já funcionava. O número de 321% é correlação, então vale ler com cautela.
Linha do tempo
Netflix detalha o Pensive AI, com extração de erros por LLM em 100% das falhas e diagnóstico sob demanda.
Perguntas frequentes
O que é o Pensive AI da Netflix?
É a camada de IA do Pensive, sistema de diagnóstico de falhas da plataforma de dados da Netflix. Ela adiciona extração de erros por LLM e diagnóstico de causa raiz sob demanda. Tudo envolve processos determinísticos que já existiam.
Como o Pensive AI evita que o LLM invente trechos de log?
O sistema numera as linhas do log e o modelo devolve apenas a linha inicial e a final do erro. O texto exibido é reconstruído a partir do log original. O modelo ainda pode escolher o intervalo errado, por isso a qualidade da extração é medida nas avaliações.
Por que o diagnóstico completo roda sob demanda?
Ele leva de dezenas de segundos a um minuto e custa mais que a extração. Como a maioria dos steps que falham nunca é aberta, rodar sempre seria desperdício. O resultado é cacheado por tentativa de step e expira em 90 dias.
Quais resultados a Netflix informa?
A extração por IA cobre 100% das falhas, inclusive as que o Pensive legado classificava como desconhecidas. Tentativas sem uso do Pensive AI tiveram em média 321% mais ações manuais de exploração de logs. A própria Netflix diz que é uma comparação observacional.
Fontes
- netflixtechblog.comfonte original
- Categoria
- CEVIU Dados
- Publicado
- 29 de outubro de 2026
- Editoria
- CEVIU Dados