
Como o conector Kafka do Flink faz o commit de offsets no Kafka
Aprofundamento CEVIU
Aprofundamento
O ponto de partida é como o Flink enxerga o Kafka. A unidade de trabalho do source é o split: uma partição mais o próximo offset a ler (e, em splits limitados, o offset de parada). Esse estado vai para o checkpoint junto com o resto do job, e é isso que sustenta o exactly-once. O commit de offsets no Kafka é opcional para o Flink. Serve para dashboards de lag e alertas, como em qualquer consumidor Kafka.
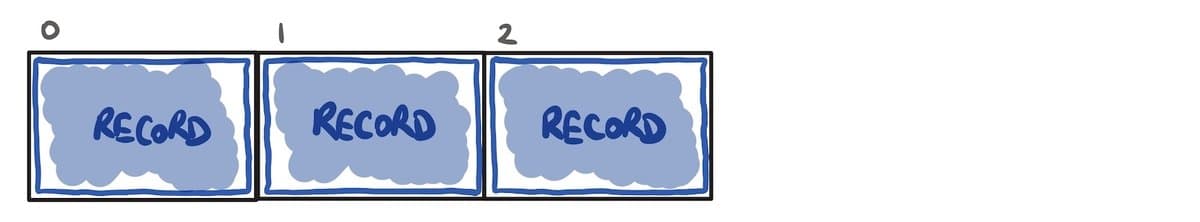
O problema (FLINK-33484) aparecia em tópicos transacionais com isolation.level=read_committed. O emitter definia o offset do split como o offset do último registro emitido mais 1. Só que marcadores de transação e registros de transações abortadas ocupam offsets no log e nunca chegam à aplicação. Com um registro no offset 0 e o marcador no 1, o consumidor ficava na posição 2, mas o Flink commitava 1, e o Kafka reportava lag de 1 num job totalmente em dia. Em tópico quieto, esse lag falso podia durar até chegar dado novo.
A correção usa a posição do consumidor (consumer.position), a única fonte que sabe quantas entradas invisíveis existem. Mas não dá para commitar essa posição às cegas, porque o consumidor busca registros à frente do que o Flink já processou. A reconciliação roda na thread do split fetcher: avança o offset só quando nada fetched está pendente fora do checkpoint. As revisões do PR trouxeram vários casos extras: callback que registrava os offsets pedidos e não os efetivamente commitados (a métrica committedOffset divergia do Kafka), partições sem nenhum registro entregue (lag de 7 numa partição só com transação abortada), o placeholder EARLIEST_OFFSET (-2), splits limitados e o risco de o offset commitado voltar atrás. Agora o split reader guarda o último offset commitado por partição e omite a partição em vez de commitar um valor menor.
O autor afirma que nada mudou nas garantias de processamento, porque o conteúdo do checkpoint é o mesmo. Ele também ressalva que não garante offsets certos em todos os casos: o PR trata de qual offset é commitado, não de quando o commit dispara. O FLINK-36532 segue aberto: no stop-with-savepoint o reader fecha antes de a tarefa de commit enfileirada rodar, e o consumer group fica com offsets antigos ou sem nenhum.
Por que isso importa
Para quem opera Flink com Kafka transacional, isso significa que alerta de lag baseado em consumer group passa a ser mais confiável, com menos falso positivo em tópicos quietos. Ainda assim, o offset commitado continua sendo canal lateral, de melhor esforço. Para recuperação, vale o estado do checkpoint, não o que o Kafka mostra.
Perguntas frequentes
Por que o Kafka mostrava lag 1 num job Flink que já tinha lido tudo?
O Flink commitava o offset do último registro emitido mais 1. Em tópicos transacionais, o marcador de commit ocupa um offset que a aplicação nunca vê. O consumidor passava do marcador, mas o Flink commitava um offset a menos, e o lag falso ficava até chegar novo dado.
Essa mudança afeta o exactly-once do Flink?
Não. Segundo o autor, o que entra no checkpoint não mudou. A alteração só trata dos offsets commitados no Kafka e da métrica committedOffset do Flink, que agora coincidem.
Por que não commitar sempre a posição do consumidor?
O consumidor busca lotes à frente do que o Flink processou. Registros na fila do fetcher ainda não estão no checkpoint, então commitar a posição pularia esses dados no monitoramento. Por isso há uma reconciliação com o offset do checkpoint.
Os offsets commitados agora estão certos em todos os casos?
O autor diz que não. A mudança define qual offset vai no commit, não o que dispara o commit. O caso de stop-with-savepoint (FLINK-36532) segue em discussão, porque a tarefa de commit pode não rodar antes de o fetcher encerrar.
Fontes
- dalelane.co.ukfonte original
- Categoria
- CEVIU Dados
- Publicado
- 29 de outubro de 2026
- Editoria
- CEVIU Dados