A Anthropic lançou message threads em beta público. O recurso permite que agentes enviem apenas as mensagens novas, em vez de reenviar todo o histórico da conversa a cada requisição. Segundo o texto, a mediana do tempo até o primeiro token caiu cerca de 35% em requisições com 500 mil a 1 milhão de tokens, sem alterar o uso de tokens.
O GPT-6.2-Astra começou a aparecer nos detalhamentos de uso do Codex. Segundo o testingcatalog.com, as requisições provavelmente estão sendo roteadas de forma discreta para o novo modelo, em um teste A/B ou em um rollout gradual. A publicação afirma que o lançamento público pode estar a poucos dias. O veículo também diz que a OpenAI teria decidido pular o GPT-6.1 Astra por preocupações com engano e escopo. Nada disso foi confirmado oficialmente.
Em seu documento atualizado de IPO, a Anthropic revelou que pode em breve alcançar a definição interna que adota para recursive self-improvement (RSI): o cenário em que sistemas de IA ajudam a desenvolver modelos de IA cada vez mais capazes.
Treinar de forma confiável em vários clusters menores amplia o conjunto de recursos utilizáveis para o treinamento de modelos frontier. Uma única execução poderia misturar gerações de aceleradores e fornecedores, já que cada ilha opera em seu próprio ritmo. Gerações mais antigas ou chips menos comuns também poderiam participar de uma execução frontier. Há, porém, um risco: integridade e safety podem ficar mais difíceis de garantir quando os modelos são treinados entre diferentes provedores. Um único site com falha ou comprometido pode degradar ou adulterar os modelos silenciosamente, de maneiras mais difíceis de rastrear.
Swarms são sistemas de IA em que vários agentes cooperam para atingir um objetivo em comum. O post do gr.inc discute uma técnica chamada collective inference-time scaling, em que os agentes ampliam tanto a quantidade de trabalho útil executado em paralelo quanto a comunicação necessária para isso. O texto também explica como projetar incentivos para o trabalho em paralelo e aborda o tema mais geral de desenhar incentivos em reinforcement learning.
O Copilot Cowork, camada de execução com agentes orientada por IA da Microsoft, chegou à disponibilidade global em quatro meses e meio. No caminho, o runtime foi trocado de Python para Rust com o produto em operação. Entre as práticas principais estão escrever especificações claras antes de codar, rodar agentes restritos com limites bem definidos e garantir que as verificações automatizadas realmente validem as mudanças no código. A transição para Rust melhorou a eficiência e evidenciou a importância de testes claros, da definição de limites e da supervisão humana no desenvolvimento.
O Weight Teleportation acelerado por GPU otimiza o treinamento de RL ao melhorar a sincronização de pesos entre trainers e samplers, com tempo de pausa abaixo de 0,23 segundo. O resultado vem de um pipeline de compressão e descompressão desenvolvido em conjunto, com processamento paralelo acelerado por GPU. A técnica usa codecs eficientes, como LZ4 e Snappy, combinados com uma camada Zstd.
O Harness 2, da Framer, já está disponível e muda a forma como o agente executa tarefas: fluxos de trabalho inteiros podem rodar em um único programa, com redução de até 33% nos custos e execução até 20% mais rápida. O ganho vem de executar o JavaScript conforme ele chega em streaming, o que evita múltiplas chamadas ao modelo, e do uso de eager execution e early cancellation. A reformulação também troca a DSL por chamadas de método para atualizações em tempo real, deixando a execução mais enxuta tanto para agentes dentro do app quanto para agentes externos. Segundo o texto, houve redução de 43% nas etapas de ferramentas e de 39% nos tokens de entrada em cache por mensagem.
A NVIDIA apresentou novos recursos do Cosmos Framework para treinar, fazer fine-tuning, aplicar reinforcement learning e otimizar world models voltados a IA física. Com eles, desenvolvedores podem gerar simulações sincronizadas de vídeo e LiDAR para robótica e veículos autônomos e, depois, fazer o deploy dos modelos pelos microservices Cosmos NIM, acelerados por GPU.
A OpenAI planeja unir as abas Chat e Work na experiência do ChatGPT, após um período inicial de testes com usuários selecionados. O Codex continuará como uma experiência separada no app desktop do ChatGPT. Com a mudança, o usuário poderá passar da exploração de ideias à execução do trabalho pelo chatbot no mesmo espaço, e será possível importar arquivos e plugins. Em breve, ChatGPT e Codex passarão a compartilhar o mesmo pool de uso.
Um artigo recente demonstra a capacidade do GPT-6 Astra de interagir diretamente com os pesos de redes neurais, superando humanos e algoritmos convencionais. Ao editar os pesos de maneira nativa, o Astra melhorou de forma significativa as habilidades matemáticas de um LLM Qwen de 0,8B. Apesar de impressionantes, essas capacidades refletem resolução avançada de problemas, comparável à de pesquisadores humanos habilidosos, e não capacidades radicalmente novas de IA.
O prospecto revisado do IPO da Anthropic mostra receita de US$ 33,24 bilhões nos nove primeiros meses de 2026, alta de 1.200%. No mesmo período, a empresa registrou prejuízo líquido de US$ 104 bilhões. Os compromissos com compute e infraestrutura somam cerca de US$ 895,4 bilhões.
Enclaves são uma nova primitiva de segurança para os GitHub Agentic Workflows entre repositórios. Com eles, agentes podem atuar em repositórios diferentes, mas o que cada um comunica aos demais fica limitado.
A OpenAI apresentou o LifeVal, um benchmark criado para avaliar o desempenho de IA em tarefas práticas do cotidiano. Entre os exemplos estão fazer um orçamento, encontrar uma creche e acessar serviços governamentais.
Elon Musk confirmou que os limites de uso do Grok Bot foram reduzidos. Segundo ele, os custos de operação ficaram insustentavelmente altos em relação à receita gerada.
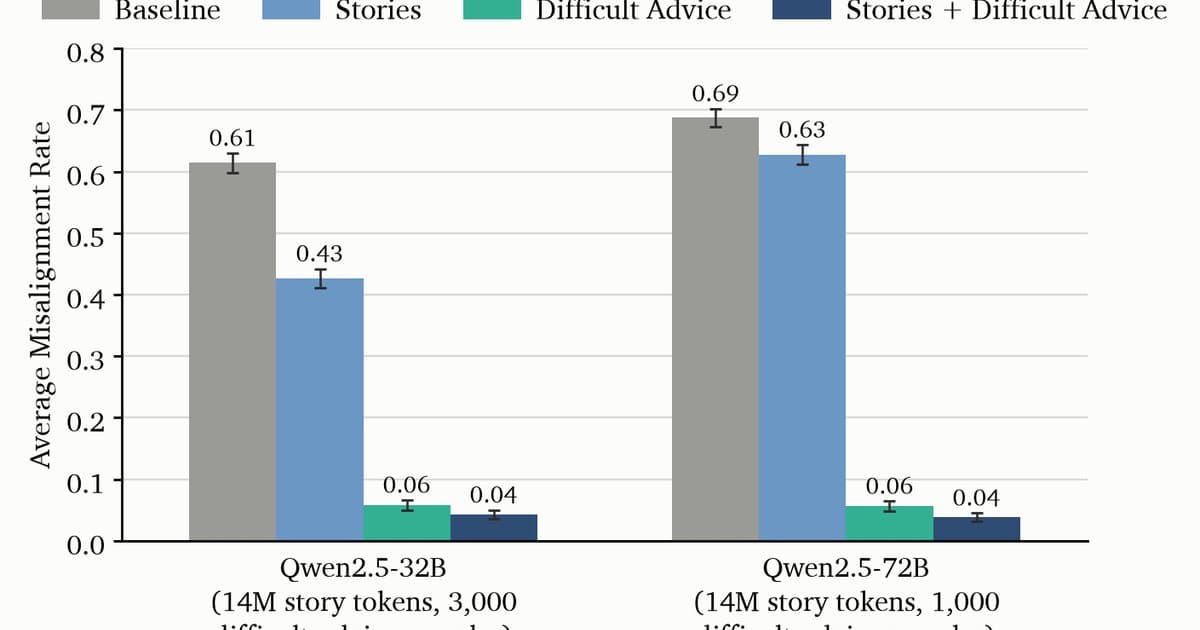
Uma pesquisa publicada no LessWrong estende a novos modelos os métodos do "Teaching Claude Why", da Anthropic, com foco em reduzir o desalinhamento em contextos de agentes (agentic misalignment). Para isso, o trabalho usa synthetic document finetuning (SDF) e supervised finetuning (SFT) com histórias fictícias e dilemas éticos.