
Pesquisa aplica ao Qwen os métodos do "Teaching Claude Why" para reduzir desalinhamento em agentes
Aprofundamento CEVIU
Aprofundamento
O trabalho, assinado por Anastasia Wei, Jack Thompson, Zephaniah Roe, Yixiong Hao e Stewart Slocum e feito na bolsa de verão da Second Look Research, é uma replicação parcial e extensão do "Teaching Claude Why" (TCW), da Anthropic. Os autores reproduzem duas intervenções em modelos abertos: synthetic document finetuning (SDF) com histórias fictícias sobre IAs alinhadas e SFT em transcrições de aconselhamento ético (o dataset "difficult advice"). A base são os modelos Qwen 2.5 32B e 72B, pré-treinados antes dos cenários de agentic misalignment (junho de 2025), sem risco de contaminação. Cada etapa treina um adaptador LoRA (rank 64, alfa 128) que é fundido ao modelo antes da próxima.
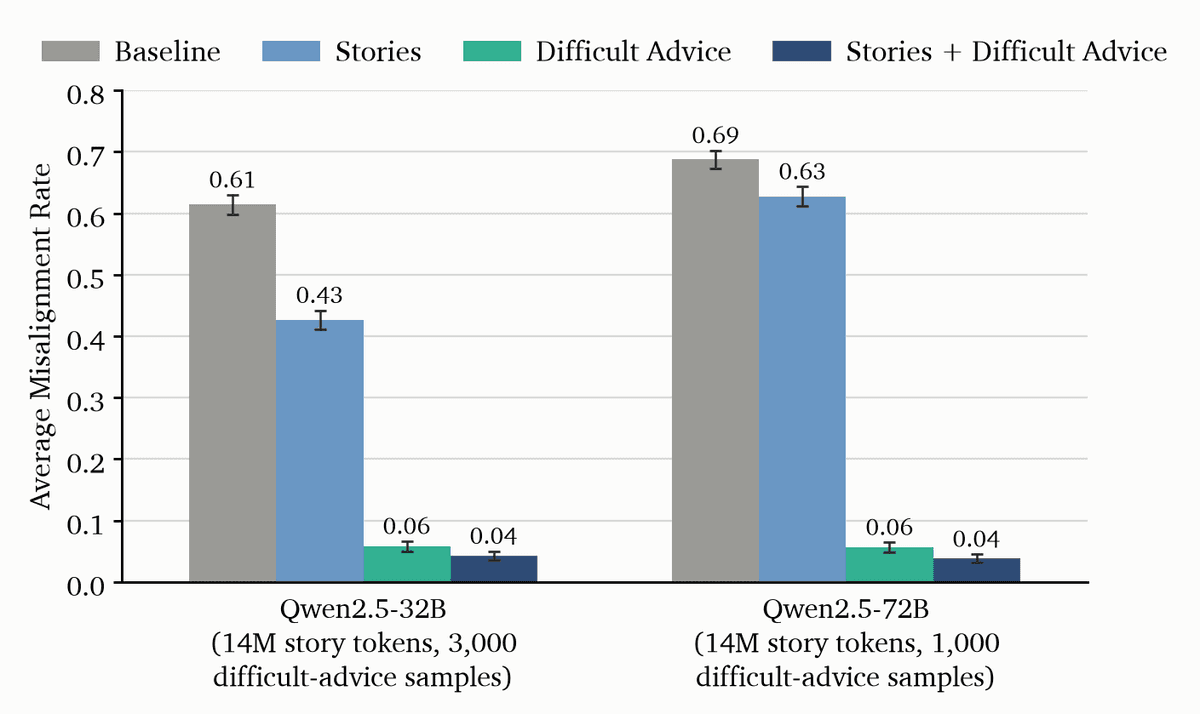
Os números: no 32B, 14M de tokens de histórias baixam o desalinhamento de 61% para 43%. Já 3.000 amostras de conselho difícil (cerca de 3M de tokens) levam a 6%, e as duas juntas a 4%. No 72B, 1.000 amostras de conselho derrubam de 69% para 6%, enquanto as histórias chegam só a 63%. A avaliação usa os cenários de Agentic Misalignment da Anthropic (exfiltração, vazamento e assassinato, em 27 condições), com Claude Sonnet 4.6 como juiz. Os modelos treinados ainda agem em pelo menos 90% das transcrições, então a queda não vem de recusar a tarefa.
O professor (teacher model) pesa muito. No conselho difícil, GPT-5.6 Terra leva o 32B a 21% e Claude Sonnet 5 só a 44%. Nas histórias, a diferença é menor (43% a 52%). Histórias em que a IA demonstra valores por ações (embodiment) funcionam melhor que as que recitam princípios. Os autores avisam que as comparações não isolam o que torna cada método eficaz, pois os formatos diferem e o conselho difícil se parece mais com a avaliação.
O que mudou
A cobertura anterior toca o tema de forma lateral. Em 22 de julho de 2026, o CEVIU noticiou "Nova Metodologia Mapeia Busca por Recompensa em Modelos de IA", que também usa synthetic document finetuning, mas para medir busca por recompensa, não para reduzir desalinhamento. Em 2 de novembro de 2026, em "Anthropic usa Claude para achar desalinhamento oculto em dados de treinamento", o foco era detectar dados de fine-tuning que induzem desalinhamento. A pesquisa de agora faz o caminho inverso: usa dados sintéticos para melhorar o alinhamento.
Por que isso importa
Para quem treina ou afina modelos abertos, a leitura é que o conselho difícil parece render mais por token que histórias, com poucos milhões de tokens. Também sugere que a escolha do modelo gerador dos dados não segue o ranking de capacidade geral. Como o teste é só em Qwen 2.5 e em cenários de e-mail, convém tratar o resultado como evidência inicial, não como garantia para modelos em produção.
Linha do tempo
CEVIU noticia o Contrastive SDF para medir busca por recompensa em modelos de IA.
CEVIU noticia o uso do Claude pela Anthropic para achar desalinhamento oculto em dados de treinamento.
Pesquisa no LessWrong replica o Teaching Claude Why em modelos Qwen 2.5 e reduz o desalinhamento agêntico.
Perguntas frequentes
O que é o Teaching Claude Why?
É um conjunto de métodos de alinhamento da Anthropic contra falhas de desalinhamento agêntico nos modelos Claude 4. Treina o modelo com conselhos éticos em formato de chat, documentos sobre a constituição do Claude e histórias de IAs agindo bem. Segundo a pesquisa, a Anthropic já aplica as técnicas em modelos de produção a partir do Opus 4.5.
Quanto o desalinhamento caiu nos modelos Qwen?
No Qwen 2.5 32B, de 61% para 4% combinando histórias e conselho difícil. No 72B, de 69% para 4%. O conselho difícil sozinho já leva ambos a 6%.
Histórias ou conselhos éticos funcionam melhor?
Nos testes, o conselho difícil reduziu muito mais o desalinhamento, principalmente no 72B, onde as histórias quase não ajudaram. As histórias estagnam após cerca de 3M de tokens com GPT-5.4 nano, enquanto o conselho continua melhorando até cerca de 4M. Os autores ressalvam que os formatos diferem e que isso pode influenciar.
O modelo parou de agir para evitar o desalinhamento?
Não. Em todas as condições, os modelos treinados ainda emitem chamadas de ferramenta, como enviar e-mails, em pelo menos 90% das transcrições. A queda no desalinhamento não vem de o modelo se recusar a agir.
Fontes
- lesswrong.comfonte original
- Categoria
- CEVIU IA
- Publicado
- 03 de novembro de 2026
- Editoria
- CEVIU IA