
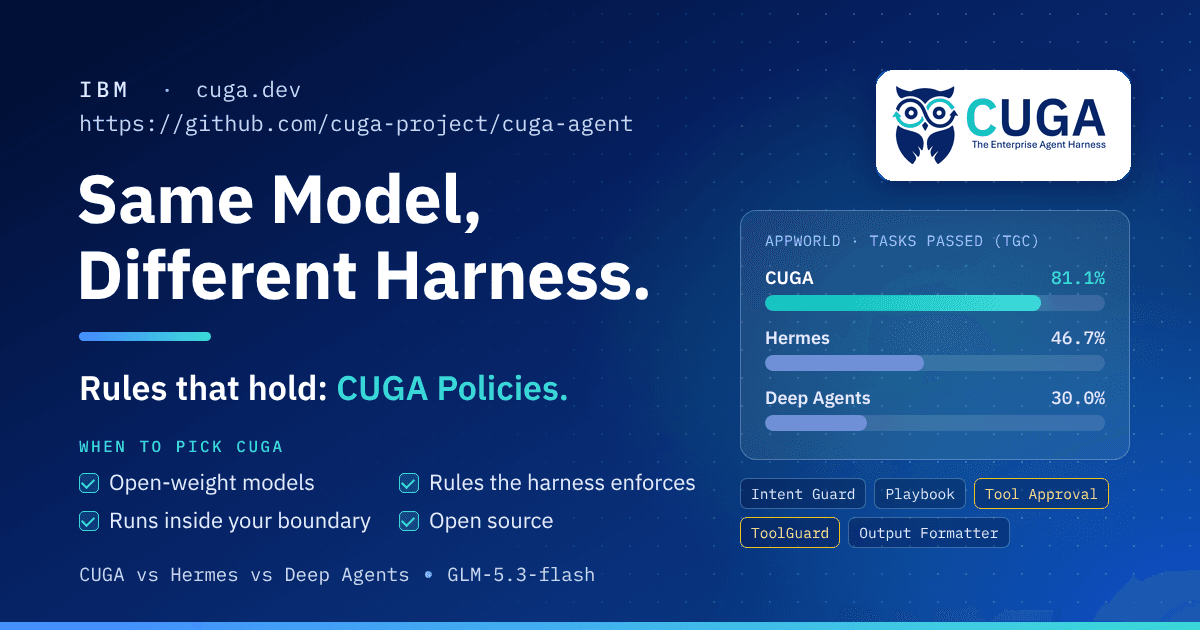
Mesmo modelo, harness diferente: IBM Research compara CUGA, Hermes e Deep Agents e vê taxa de conclusão ir de 30% a 81%
Aprofundamento CEVIU
Aprofundamento
A IBM Research controlou a variável que quase ninguém isola: o modelo. Os três harnesses (CUGA, Hermes e Deep Agents) usaram o mesmo open-weight, o GLM-5.3-flash, nas mesmas 90 tarefas do AppWorld, divididas em 30 cenários, com uma tentativa por tarefa e o framework Harbor. O AppWorld reúne 9 apps e 457 APIs. Como são apps de consumo, serve de proxy para o que a automação corporativa exige: login, leitura de documentação de API, paginação e alteração de estado em vários apps.
A métrica SGC é a mais dura: um cenário só passa se as três variantes passarem. Deu 20 cenários para o CUGA, 8 para o Hermes e 2 para o Deep Agents. Os autores avisam que não é veredito sobre Hermes ou Deep Agents, pois nenhum foi feito para esse tipo de trabalho. Os limites são claros: amostra pequena, um único benchmark, configurações não idênticas e nenhuma policy ativa nas execuções, então a aplicação de regras não foi medida. O time do CUGA também admite que usou uma configuração de AppWorld que os outros não tiveram, e se compromete a rodar de novo qualquer configuração enviada ao harbor-eval.
O que mudou
O CUGA já tinha aparecido no CEVIU. Em 24 de junho de 2026, na matéria "CUGA leva apps agentic do protótipo à produção", ele foi apresentado como o agent harness open source da IBM que cuida de planejamento, execução e estado. Agora a IBM mostra um número comparativo, com modelo fixo, em vez de só descrever a proposta. Sobre o tema harness, em 3 de setembro de 2026 o CEVIU noticiou "Estudo Revela Disparidade de Custos em Agent Harnesses de IA para Codificação" e, em 18 de setembro de 2026, a análise sobre impacto no custo da geração de código. Aquelas coberturas olhavam custo e tokens em agentes de código. Esta olha taxa de conclusão em tarefas com APIs de vários apps.
Por que isso importa
Para quem monta agentes em produção, a leitura é que escolher o harness merece o mesmo rigor que escolher o modelo. Trocar de modelo pode render menos do que trocar a estrutura em volta dele. Mas o dado vem de quem fabrica um dos harnesses, em um benchmark e com 90 tarefas. Vale reproduzir com a sua carga antes de decidir. Já o ponto das policies é arquitetural: regra de negócio no prompt é só instrução, e o que precisa valer sempre deveria morar no runtime.
Linha do tempo
CEVIU noticia benchmark executável da IBM Research para avaliar raciocínio de agentes em múltiplas etapas.
CEVIU noticia o CUGA, agent harness open source da IBM, levando apps agentic à produção.
CEVIU noticia o estudo FrontierHarness sobre disparidade de custos entre harnesses de codificação.
CEVIU noticia análise do impacto de agent harnesses no custo da geração de código.
IBM Research compara CUGA, Hermes e Deep Agents com o mesmo modelo e vê conclusão de 30% a 81% no AppWorld.
Perguntas frequentes
O que a IBM Research testou nesta comparação?
Três agent harnesses, CUGA, Hermes e Deep Agents, com o mesmo modelo open-weight, o GLM-5.3-flash. Rodaram 90 tarefas do AppWorld em 30 cenários, com uma tentativa por tarefa. A taxa de conclusão variou de 30% a 81% só pela troca do harness.
O resultado prova que o CUGA é melhor que Hermes e Deep Agents?
Não. Os próprios autores dizem que não é um veredito, porque Hermes e Deep Agents não foram feitos para trabalho com APIs de vários apps. Além disso, o time do CUGA usou uma configuração de AppWorld que os outros não tiveram. A IBM convida a comunidade a enviar configurações melhores para o harbor-eval.
O que é a métrica SGC?
É a métrica em que um cenário só passa se as três variantes dele passarem. Ela premia consistência, não uma execução de sorte. Deu 20 cenários para o CUGA, 8 para o Hermes e 2 para o Deep Agents.
Por que policies no harness seriam melhores que regras no prompt?
Segundo a IBM, o prompt é instrução, não garantia: o modelo pode interpretá-lo mal, o usuário pode convencer o agente a ignorá-lo e uma mensagem injetada pode alterá-lo. As policies do CUGA levam as regras para o harness. Ressalva: as execuções do experimento não usaram policies, então esse efeito não foi medido ali.
Fontes
- huggingface.cofonte original
- Categoria
- CEVIU IA
- Publicado
- 03 de novembro de 2026
- Editoria
- CEVIU IA